
Nachbearbeitung der Jobergebnisse
Letzte Aktualisierung: Juni 1, 2022
Übersicht
Mit der Nachbearbeitungsfunktion der Rescale-Plattform können Sie ausgewählte Daten aus Ausgabedateien direkt auf der Rescale-Plattform extrahieren, verarbeiten und anzeigen, ohne die Daten auf Ihren lokalen Computer übertragen zu müssen.
Die Nachbearbeitungsfunktion ermöglicht es Ihnen, die Vorteile der leistungsstarken Hardware von Rescale voll auszunutzen und die Zeit bis zur Anzeige der Ergebnisse zu verkürzen, indem Sie DatenübertragungDie Bewegung von Daten zwischen verschiedenen Speichersystemen, Standorten... Mehr. Jobs mit mehreren Läufen bieten Ihnen außerdem die Möglichkeit, Diagramme basierend auf Ihren definierten Eingabeparametern sowie allen Ausgabeparametern anzuzeigen, die aus Ihrem SimulationSimulation ist Experimentieren, Testen von Szenarien und Erstellen von … Mehr Ausgabedateien.
Um die Diagrammfunktion voll auszunutzen, müssen Sie ein Nachbearbeitungsskript zum Parsen Ihrer Datendateien schreiben (z. B. ein Python- oder Shell-Skript). Die extrahierten Parameter müssen in einem tabulatorgetrennten Format ausgegeben werden, wie unten beschrieben, um in der Diagrammfunktion verwendet werden zu können. In diesem Tutorial erweitern wir das 2D-Tragflächenprofil Versuchsplanung (DOE)DOE steht für „Design of Experiments“. Es handelt sich um eine statistische Methode … Mehr Beispiel beschrieben in der DOE-Tutorial um die Leistung des Tragflächenprofils direkt auf der Rescale-Plattform zu untersuchen. Die Eingabedateien, parallelen Einstellungen, Vorlagendatei, Softwareeinstellungen und Hardwareeinstellungen für dieses Tutorial sind identisch mit denen im DOE-Tutorial.
Ausgabeformat für die Nachbearbeitung
Jede zu extrahierende Variable und ihr Wert sollten in einer separaten Zeile in die Standardausgabe geschrieben werden. Die Zeile sollte im Tabulator-getrennten Format vorliegen, d. h. der Variablenname, gefolgt von einem „Tabulator“, gefolgt vom Variablenwert.
In einem Bash-Skript könnte dies folgendermaßen aussehen:
printf "%s\t%s\n" "variable" "$stringValue"
Oder in Python:
`print(f"variableName\t{value})`
Hochladen eines Nachbearbeitungsskripts
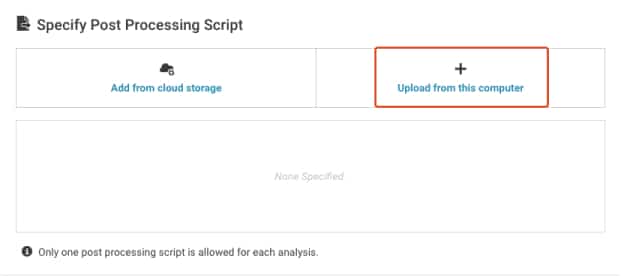
Der Nachbearbeitungsschritt des Einrichtungsprozesses ist derselbe, unabhängig davon, ob Sie einen einfachen Job mit einem Durchlauf oder einen Job mit mehreren Durchläufen, wie z. B. ein DOE, ausführen. Die Nachbearbeitung wird in der Regel nach der Definition der Hardwareeinstellungen für den Job eingerichtet. Die Einrichtungsseite ist im Bild unten zu sehen. Laden Sie ein Nachbearbeitungsskript hoch, indem Sie auf Von diesem Computer hochladen.
Nach dem Hochladen des Skripts müssen Sie einen Befehl zur Ausführung angeben. Das folgende Bild zeigt, wie ein hochgeladenes Python-Skript, forceCoefficients.py (der die Auftriebs- und Widerstandskoeffizienten extrahiert) wird aufgerufen, um die Ergebnisse zu verarbeiten. Der Nachbearbeitungsbefehl ist rot hervorgehoben.
Hinweis: Das Nachbearbeitungsskript wird aus dem Arbeitsverzeichnis des jeweiligen Laufs ausgeführt. Daher ist der relative Pfad zu den Ausgabedateien für alle Läufe gleich.
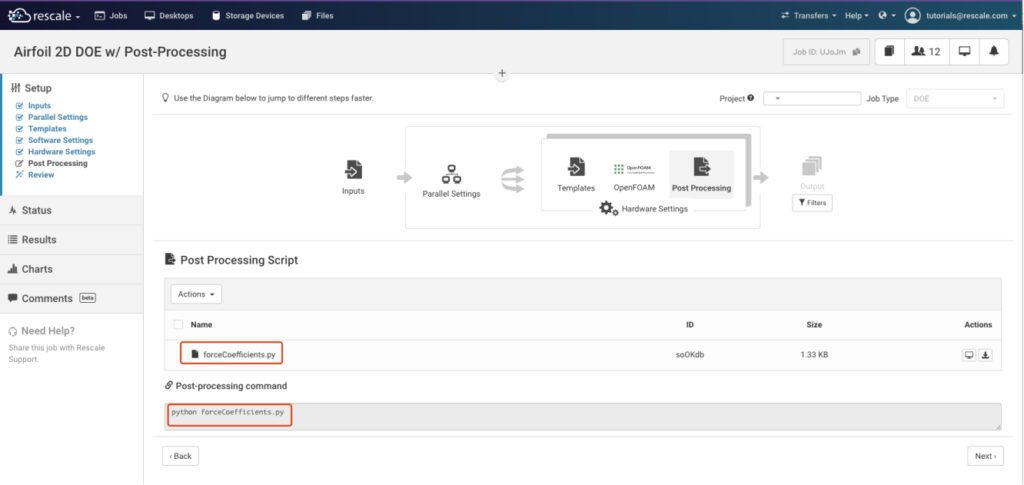
Derselbe Vorgang ist auch für ein Shell-Skript anwendbar. Unabhängig vom Skripttyp müssen die Variablen vom Skript im im vorherigen Abschnitt beschriebenen, durch Tabulatoren getrennten Format ausgegeben werden.
Sobald die Nachbearbeitungseinrichtung abgeschlossen ist, kann der Auftrag übermittelt werden und wird normal ausgeführt. Das Nachbearbeitungsskript wird am Ende jedes einzelnen Laufs ausgeführt, um die während des Laufs erstellten Ausgabedateien zu verarbeiten.
Nachbearbeitung der Skriptausgabe
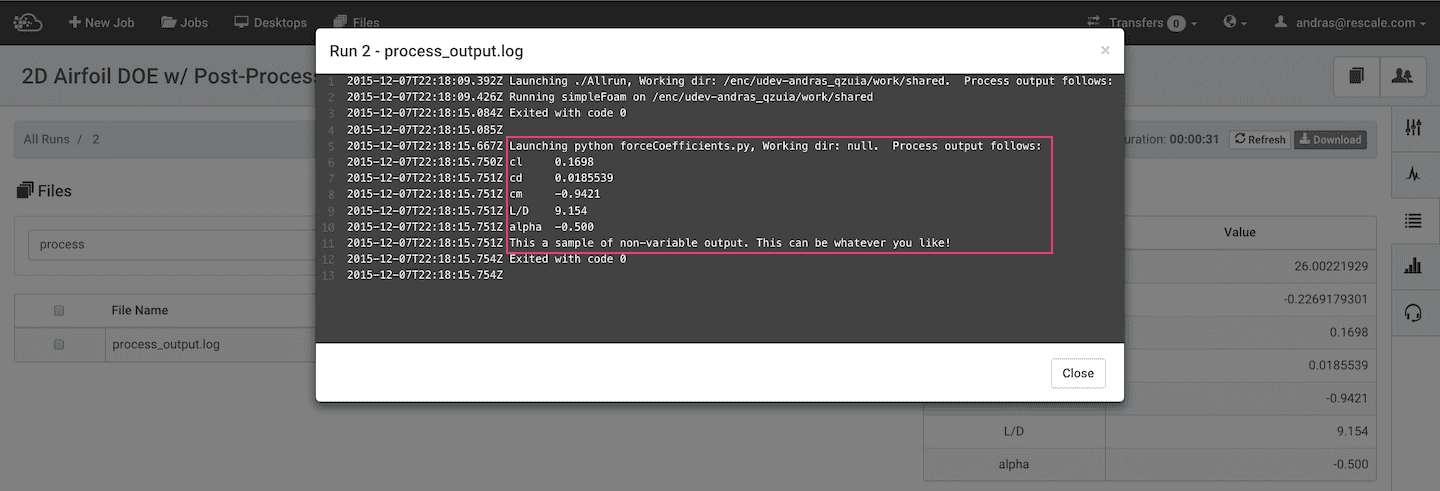
Nachbearbeitungsskripte müssen Daten im tabulatorgetrennten Format ausgeben, damit sie von der Rescale-Plattform als „Variablen“ für die Anzeige und Diagrammerstellung registriert werden können. Skripte können jedoch auch zusätzliche Informationen für Ihre Verwendung ausgeben. Die gesamte Ausgabe des Nachbearbeitungsskripts finden Sie im process_output.log des einzelnen Laufs, wie unten gezeigt.
Auf diese Weise können Sie in Ihren Nachbearbeitungsskripten nach Wunsch weitere nützliche Informationen ausgeben. Im Bild unten ist die Variablenausgabe im process_output.log.
Ergebnisse
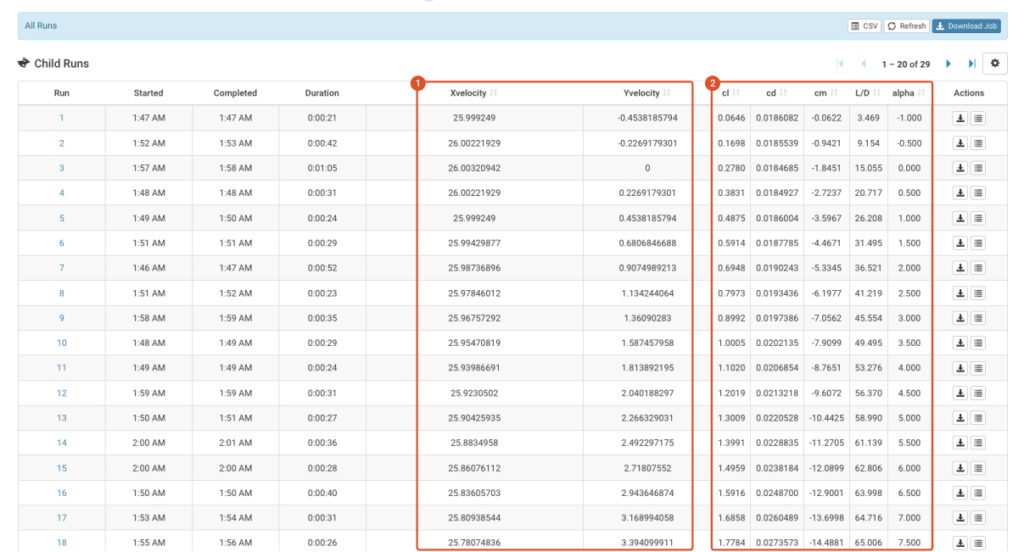
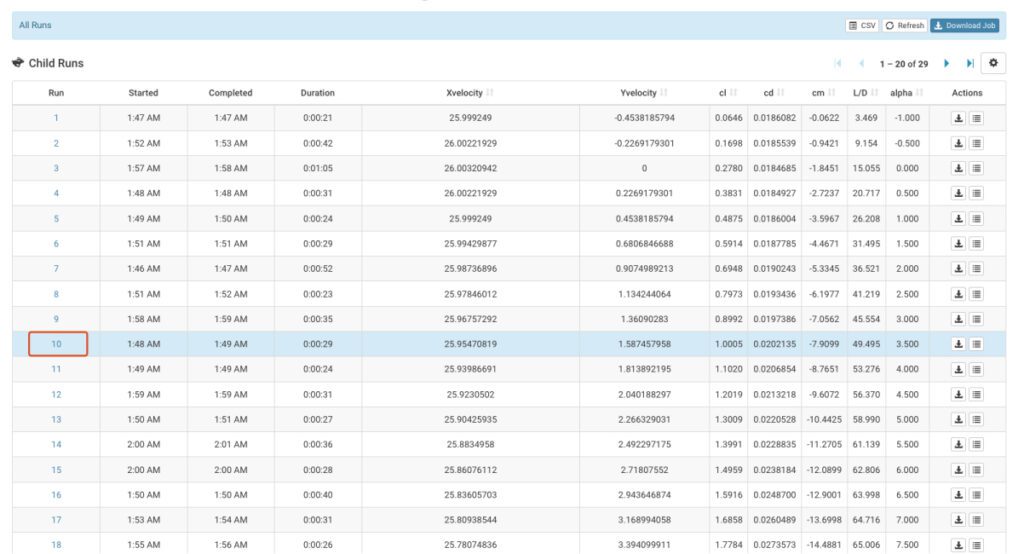
Das Bild unten zeigt die Ergebnisse für einen abgeschlossenen DOE-Job mit Nachbearbeitung. Die Variablen, die in Parallele Einstellungen, d. h. die Eingabebedingungen für diesen DOE-Job sind in Feld 1 hervorgehoben. Die vom Nachbearbeitungsskript extrahierten und ausgegebenen Variablen erscheinen auch in der Ergebnisse und sind in Feld 2 hervorgehoben. Diese tabellarische Ansicht ermöglicht Ihnen eine schnelle Überprüfung der Daten für alle Läufe.
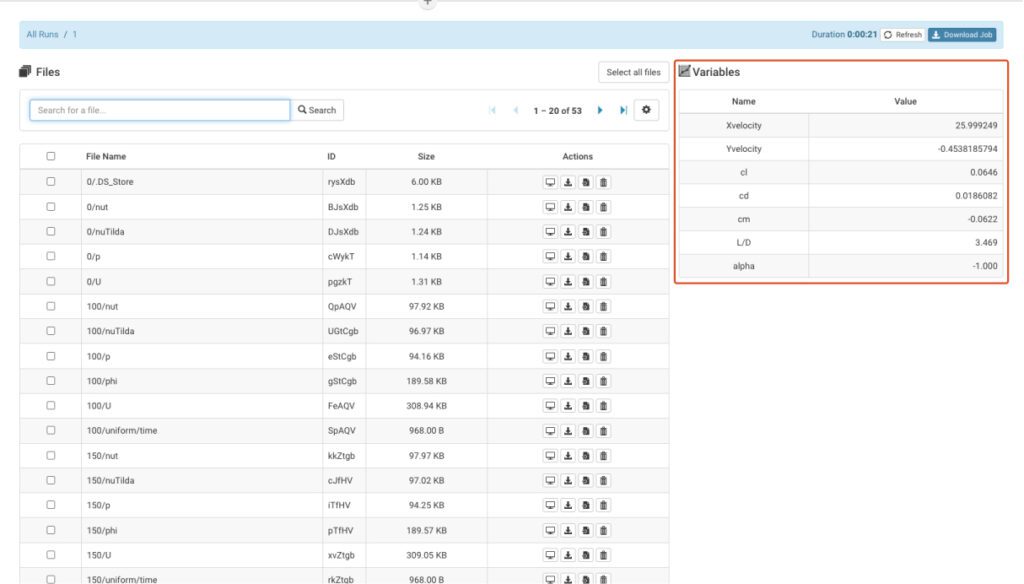
Durch Klicken auf die Führen Sie Die Zahl in der linken Spalte öffnet die Seite für den jeweiligen Lauf. Auf dieser Seite können die Ausgabedateien des ausgewählten Laufs angezeigt, heruntergeladen oder für zukünftige Jobs bereitgestellt werden. Die Eingabe- und Ausgabevariablen werden in der Variablen Tabelle, wie unten hervorgehoben.
Nächste Schritte
Durch Extrahieren der Ausgabevariablen mithilfe eines Nachbearbeitungsskripts können Sie die Diagrammfunktion von Rescale nutzen und Diagramme direkt auf der Rescale-Plattform erstellen. Es stehen drei verschiedene Diagrammtypen zur Verfügung:
- Streuen
- Gebiet
- Oberfläche
Sie können die darzustellenden Kombinationen von Eingabe- und Ausgabeparametern mithilfe der Tabelle auf der rechten Seite auswählen. Unten sehen Sie ein Beispiel für ein Streudiagramm aus dem 2D-Tragflächen-DOE. In diesem Fall stellt das Diagramm den Auftriebskoeffizienten im Vergleich zum Widerstandskoeffizienten dar.
Beachten Sie, dass in einem Streudiagramm mehrere Datenreihen dargestellt werden können, obwohl unten nur eine Datenreihe angezeigt wird.
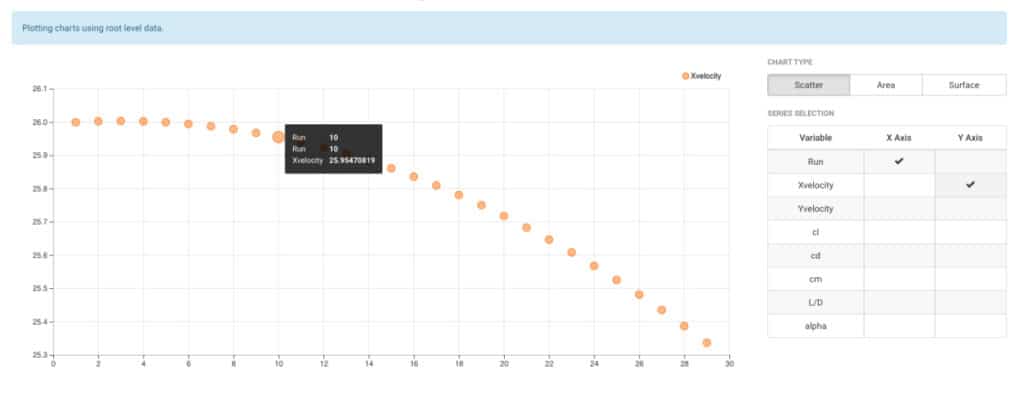
Wenn Sie den Cursor über einen einzelnen Datenpunkt in einem Streudiagramm bewegen, wird ein Datenfeld mit den X/Y-Werten für diesen Punkt sowie der Nummer des Laufs angezeigt, der die Daten erzeugt hat (siehe oben). Durch Klicken auf den Punkt wird der Lauf auf der Ergebnisseite hervorgehoben (siehe unten).
Hinweis: Oberflächendiagramme werden mithilfe eines Rasters basierend auf Ihren Eingabedaten und einem gewichteten Durchschnittsinterpolator erstellt. Daher können die Oberflächenwerte der von Ihnen gewählten „Z“-Variablen erheblich von den Werten benachbarter Punkte abweichen.