Die nächste Chance im Cloud Computing mit über 100 Milliarden US-Dollar und ihre erste Killer-App: Deep Learning
Mit Beginn des Jahres 2017 befindet sich die Unternehmenssoftwarebranche im Rahmen der 4 Billionen Dollar schweren Transformation des Enterprise-IT-Marktes am Wendepunkt für die flächendeckende Cloud-Nutzung. Die Gründe für die Cloud-Nutzung in der Unternehmens-IT sind überzeugend, und viele gehen davon aus, dass dieser Wandel bereits stattgefunden hat. Wir stehen jedoch erst am Anfang dieses Wandels, und die Auswirkungen werden alle Bereiche der IT grundlegend verändern. Branchenexperten schätzen, dass die Cloud-Durchdringung in Unternehmen heute tatsächlich nur bei etwa 6 % liegt. [1. Trends in der Infrastruktur und ihre Zukunft] Die meisten Unternehmen haben den vollen Nutzen dieser Transformation noch nicht erkannt. Es ist klar, dass die Nutzung der Cloud in den Kerngeschäftsaktivitäten von IT-Unternehmen im Bereich Hardware und Software eng mit einer verbesserten Geschäftsleistung und einem höheren Shareholder Value korreliert.
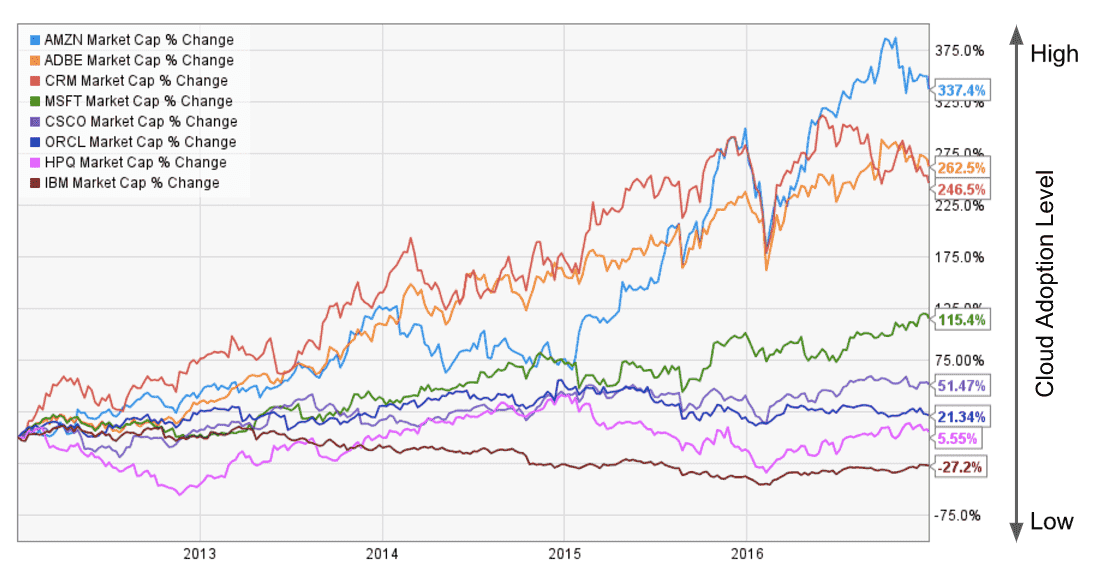
Betrachtet man beispielsweise die Veränderungen der Marktkapitalisierung der letzten fünf Jahre, so waren Unternehmen, die die Cloud voll und ganz nutzen (Amazon [AMZN], Adobe [ADBE], Salesforce [CRM]), sehr erfolgreich. Unternehmen, die erst kürzlich die Cloud genutzt haben (Microsoft [MSFT]), verzeichnen ebenfalls starkes Wachstum. Unternehmen, die die Cloud bisher nicht genutzt oder umgesetzt haben (Oracle [ORCL], HP [HPQ] und IBM [IBM]), tun sich schwer, ihren Geschäftswert weiter zu steigern. Zwar gibt es viele weitere Treiber für das Wachstum der Marktkapitalisierung dieser Unternehmen, doch das Niveau der Cloud-Produkte, Geschäftsmodelle und Expertise waren eindeutig erfolgsentscheidend, während Cloud-Kompetenzen mittlerweile für jedes Unternehmenssoftwareunternehmen zur Grundvoraussetzung geworden sind.
Während dieses jahrzehntelangen, transformativen Wandels hin zur Cloud-Nutzung in Unternehmen finden mehrere bedeutende Makrophasen statt, die gemeinsam das Potenzial und den Geschäftswert der Cloud für Unternehmen entfalten. Die ersten beiden grundlegenden Phasen sind SaaS (Cloud 1.0), das das Bereitstellungs- und Geschäftsmodell transformiert, und Big Data (Cloud 2.0), das den Wert riesiger Datensätze erschließt. SaaS und Big Data haben in Unternehmen bereits jeweils über 100 Milliarden US-Dollar an Wert geschaffen. Big Compute, das auf diesen kritischen Grundlagen aufbaut, befindet sich nun an einem Wendepunkt und ist bereit, die dritte Phase einzuläuten.
Cloud-Infrastruktur und Infrastructure-as-a-Service (IaaS) war die entscheidende Basisschicht, die die Cloud-Transformation der Unternehmens-IT ermöglichte. Amazon Web Services, Microsoft Azure und Google Cloud Platform haben die technologische und infrastrukturelle Basis für SaaS, Big Data und nun auch Big Compute geschaffen. Wie SaaS und Big Data wird auch Big Compute zu technologischen Umbrüchen führen und eine neue Welle richtungsweisender Unternehmen anlocken, die die enormen Chancen dieser neuen Breakout-Kategorie nutzen. Darüber hinaus generieren die bestehenden Branchenführer Milliardenumsätze mit rechenintensiven Workloads im traditionellen On-Premise-High-Performance-Computing (HPC)-Markt stehen vor dem Dilemma des Innovators: Sie müssen ihr gesamtes Geschäft neu erfinden, um in diesem Bereich effektive Big-Compute-Lösungen anbieten zu können – was den innovativsten Unternehmen eine einzigartige Chance bietet, in ihrer Kategorie führend zu werden.
Cloud 1.0: SaaS
Transformation des Geschäftsmodells und Bereitstellung von Unternehmenssoftware
SaaS-native Unternehmen wie Salesforce, NetSuite und Workday haben durch Geschäftsmodellinnovation und reibungslose Softwarebereitstellung richtungsweisende und führende SaaS-Lösungen für CRM, ERP und HR entwickelt. Diese führenden SaaS-Anbieter haben die Cloud genutzt, um die etablierten Anbieter, die diese Unternehmenssoftware-Kategorien traditionell dominierten, zu verdrängen.
Auch etablierte Unternehmen hatten die Möglichkeit, ihr Geschäft neu zu erfinden und SaaS für ihre Produktlinie zu implementieren. Zum Beispiel: Adobe Adobe hat seine Strategie neu erfunden und sein Unternehmen erfolgreich in einen führenden SaaS-Anbieter verwandelt. Selbst unter den Zwängen eines börsennotierten Unternehmens gelang es Adobe, von veralteter On-Premise-Software auf ein Cloud-SaaS-Abonnement- und Bereitstellungsmodell umzusteigen.
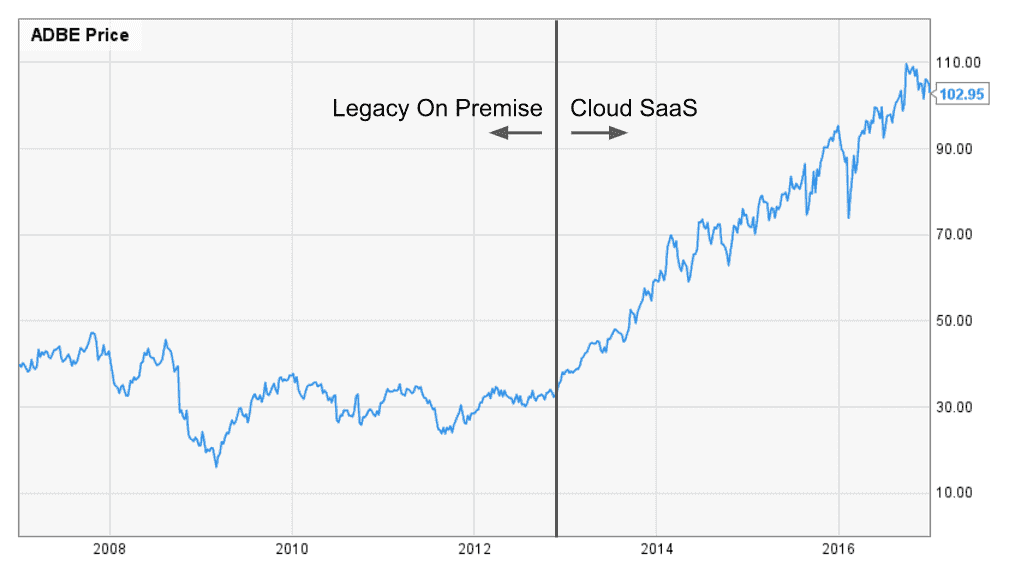
Adobe hat das Geschäftsmodell für seine führende Produktlinie von einer Jahreslizenz im Wert von 2,500 US-Dollar auf ein monatliches Abonnement im Wert von 50–100 US-Dollar umgestellt..[4. Adobe stellt Creative Suite ein und bietet nur noch Abonnements an] Das Produktteam stellte außerdem das Bereitstellungsmodell seiner Software auf eine browserbasierte Lösung mit kontinuierlichen Updates um. Kurz gesagt: Die Kunden waren begeistert. Adobe verzichtete zwar auf kurzfristige Einnahmen, schuf aber deutlich mehr zukünftigen Wert. Mit der SaaS-Transformation erweiterte Adobe seine Marktchancen, indem es durch den höheren Kundennutzen eine breitere Marktattraktivität und eine höhere Zahlungsbereitschaft demonstrierte und gleichzeitig die entscheidende Fähigkeit besaß, diesen Wert langfristig zu sichern.
Cloud 2.0: Big Data
Skalierung und Konnektivität für die Full-Stack-Datenschicht
Mit der Weiterentwicklung der Cloud-Infrastruktur, die das schnelle Wachstum von SaaS-Unternehmen unterstützte, bot Infrastructure-as-a-Service (IaaS) eine grundlegende Schicht skalierbarer und allgegenwärtiger Speicher- und Datenbanken. Diese umfassende Infrastruktur ermöglichte dramatische Innovationen auf der Datenebene und treibt die Big Data Transformation.
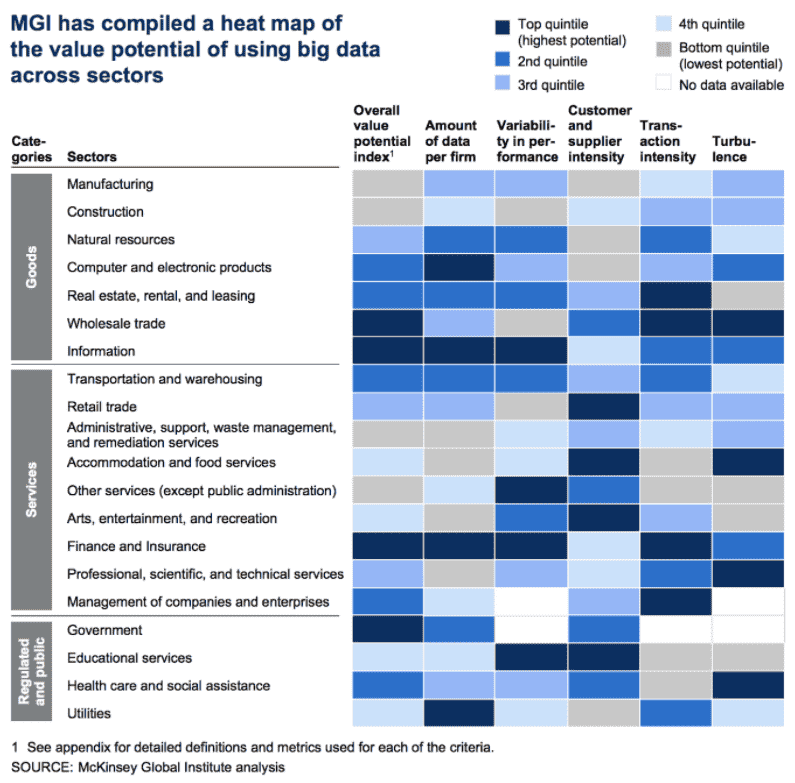
Führende Unternehmen in der Kategorie Big Data wie Splunk, Cloudera und Palantir haben unsere Fähigkeit, Erkenntnisse aus der Vergangenheit zu gewinnen, durch Skalierung, Manipulation und Verknüpfung von Unternehmensdatensätzen grundlegend verändert. Splunk ermöglicht es, Erkenntnisse aus großen und unterschiedlichen Anwendungsprotokollen von Unternehmen zu gewinnen. Cloudera hat dies mit der Bereitstellung verteilter Speicher- und Verarbeitungscluster für Unternehmen auf die nächste Ebene gebracht, und Palantir hat proprietäre Stacks entwickelt, um isolierte und unstrukturierte Datensätze im öffentlichen und privaten Sektor zu verknüpfen. Im Grunde ist Big Data eine horizontale Fähigkeit, die unternehmensweit eingesetzt werden kann, um Erkenntnisse aus vorhandenen Datensätzen zu gewinnen.
Cloud 3.0: Große Rechenleistung
Skalierung und Workload-Aktivierung für die Full-Stack-Compute-Ebene
Big Compute ist der nächste Wendepunkt im Enterprise Cloud Computing. So wie Big Data Datenbeschränkungen beseitigte und wichtige Kategorien von Unternehmenssoftware transformierte, beseitigt Big Compute Beschränkungen bei der Rechenhardware und ermöglicht die nahtlose Skalierung von Rechenlasten auf optimierten Infrastrukturkonfigurationen ohne Leistungseinbußen.
Trugschluss „Supercomputer in der Tasche“
Moores Gesetz und IaaS-Cloud-Computing haben zu der Vorstellung geführt, dass „jeder einen Supercomputer in der Tasche hat“ und allgegenwärtige Rechenleistung universell für alle zugänglich ist. Während die Rechenkapazitäten exponentiell wachsen und deutlich zugänglicher geworden sind, sind auch die Rechenanforderungen für Anwendungen dramatisch gestiegen, um die unersättliche Nachfrage nach komplexen Algorithmen der nächsten Generation zu decken. Tatsächlich ist der „Supercomputer in Ihrer Tasche“ des iPhones in Wirklichkeit ein Supercomputer von vor über 25 Jahren.,[6. Verarbeitungsleistung im Vergleich] und im gleichen Zeitraum sind die Rechenleistungsanforderungen für das Software-Ökosystem mit einer Rate gestiegen, die dem Mooreschen Gesetz entspricht oder es sogar übertrifft.
Viele kritische Unternehmensprobleme und Innovationen sind immer noch computergebunden
Entgegen der landläufigen Meinung sind viele der weltweit schwierigsten Softwareprobleme immer noch rechenintensiv. Seit den Anfängen der Unternehmenssoftware haben Rechenkapazitätsbeschränkungen sowohl die Anwendungen als auch den Arbeitsumfang stark eingeschränkt, da die Implementierung von Supercomputern und Hochleistungsrechnern in Unternehmen Millionen von Dollar kostet und Fachwissen erfordert.
Hochleistungsrechnen wird in den meisten großen Fortune 500-Unternehmen intensiv eingesetzt, darunter in Branchen wie der Luft- und Raumfahrt, der Automobilindustrie, dem Energiesektor, den Biowissenschaften und der Halbleiterindustrie. In fast allen diesen Branchen sind die Unternehmen mit erheblichen Einschränkungen der Rechenkapazität konfrontiert. Beispielsweise erfordern groß angelegte Probleme im Luft- und Raumfahrtdesign komplexe numerische Strömungsmechanik (CFD) Algorithmen, deren Lösung auf großen Hochleistungsrechnerclustern Tage oder Wochen dauern kann. Bei der Simulationsanalyse von Crashtests im Automobilbereich ist die Skalierung Finite-Elemente-Analyse (FEA) Physik auf Millionen von Komponenten und Wechselwirkungen stellt ein massives Rechenproblem dar. Und in den Biowissenschaften ist der enorme Rechenaufwand der Molekulardynamik (MD) Simulation schränkt die computergestützte Arzneimittelforschung ein, eine der größten Möglichkeiten für Störungen für Pharmaunternehmen.
Cloud-Computing-Innovationen wie SaaS, Big Data und IaaS bilden die Grundbausteine der Big-Compute-Kategorie. Ein umfassender Big-Compute-Stack ermöglicht nun reibungslose Skalierung, anwendungszentrierte Hardware-Spezialisierung und leistungsoptimierte Workloads – nahtlos für Softwareentwickler und Endnutzer. Big Compute transformiert eine breite Palette von Full-Stack-Softwarediensten auf Spezialhardware in eine softwaredefinierte Ebene. So erhalten Sie programmgesteuerte High-Performance-Computing-Funktionen – oder, wahrscheinlicher, die Auswertung von Back-End-Funktionen in Ihrer täglich genutzten Software. Dieser Ansatz stellt den herkömmlichen Standard-Computing-Cluster für ein breites Anwendungsspektrum auf den Kopf und bietet eine À-la-carte-Lösung, bei der die Rechenlasten profiliert und auf einer optimal auf die jeweilige Workload zugeschnittenen spezialisierten Hardware bereitgestellt werden. Big Compute verwandelt einen homogenen Cluster mit vielen Kompromissen bei Leistung und Kosten in eine heterogene Lösung ohne Kompromisse.
Hardwarefragmentierung und -spezialisierung ermöglichen Big Compute
Big Compute ist eine horizontale Technologie, die es Unternehmen ermöglicht, komplexe Algorithmen und Workloads auf flexibler, spezialisierter Recheninfrastruktur zu skalieren. Spezialisierte Recheninfrastruktur ist ein entscheidender Erfolgsfaktor, da zwischen Standardinfrastruktur und Spezialservern eine um ein Vielfaches größere Leistungslücke besteht. Viele Serverkomponenten wie Prozessoren, Netzwerke, Arbeitsspeicher, Storage usw. können spezialisiert sein. Big Compute demokratisiert den Zugriff auf diese Spezialhardware aus softwaredefinierter Sicht. So lässt sich ein 10 Millionen Dollar teurer Hochleistungsrechnercluster für nur wenige Tausend Dollar pro Stunde aufbauen und in beliebige Unternehmenssoftwareanwendungen integrieren. Dabei werden – und das ist am wichtigsten – die höchsten Leistungsanforderungen für High-End-Anwendungen erfüllt.
Im Rechenzentrum gibt es viele Bereiche, die optimiert werden müssen – von den physischen Racks über die Vernetzung bis hin zu den einzelnen Serverkomponenten. Beispielsweise gibt es bereits ein breites Spektrum an Prozessorfunktionen, das zunehmend fragmentiert wird. Die speziellen Fähigkeiten dieser Prozessoren sind entscheidend für bestimmte Big-Compute-Workloads, die je nach Algorithmen und Implementierung auf die richtigen Architekturen abgebildet werden müssen.
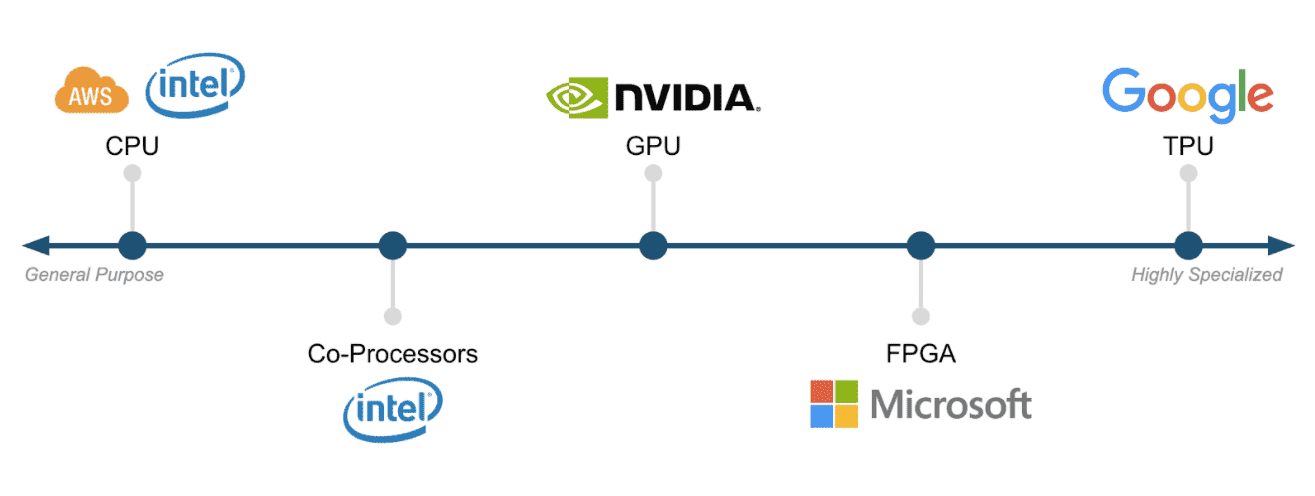
Big Compute ermöglicht es Benutzern, Softwareanwendungen und Algorithmen, diese Funktionen nahtlos zu nutzen, ohne die erforderliche Middleware und Bibliotheken verstehen oder bereitstellen zu müssen. Dies beschleunigt den Einführungszyklus und die Bereitstellung spezialisierter Hardwarefunktionen in IaaS und Rechenzentren und ermöglicht vor allem eine völlig neue Kategorie von Big Compute-Unternehmenssoftwareanwendungen und -tools.
Big Compute bietet im Wesentlichen die Ebene des softwaredefinierten Computings, die einen stärker anwendungsorientierten Computing-Ansatz im Unternehmen ermöglicht. Dies ermöglicht eine nahtlose Optimierung und Skalierbarkeit des Stacks und macht die Big-Compute-Funktionen letztendlich für Entwickler und Endbenutzer zugänglich. Diese Funktion führt zu einem dramatischen Wandel im Unternehmen: Von multidisziplinären Teams hochqualifizierter Experten für Hardware, Middleware und domänenspezifische Softwarealgorithmen, unterstützt durch hohe Investitionen in Rechenressourcen, hin zu einem nahtlosen Service, der es dem durchschnittlichen Unternehmensbenutzer ermöglicht, sich auf die Anwendungsebene zu konzentrieren und gleichzeitig auf eine hochkomplexe, aber nahtlose Big-Compute-Ebene für die Ausführung zurückzugreifen. Dieser Wandel ermöglicht es Unternehmen, eine Abstraktionsebene höher zu gehen – von der Formulierung von Workloads, die den zugrunde liegenden Hardwarefunktionen gerecht werden, bis hin zur Lösung komplexerer Probleme ohne Rechenleistungsbeschränkungen.
Der Aufstieg von Big Compute stellt nicht nur eine grundlegende neue Funktion für alle Unternehmenssoftwareanwendungen dar, sondern bietet auch die Möglichkeit, von rückwärtsgerichteten Analysen (wie sie für Big Data typisch sind) zu zukunftsorientierten Analysen und Simulationen überzugehen, um prädiktive Erkenntnisse und Vorhersagen zukünftiger Zustände zu gewinnen. Big Compute kann Simulationen bereitstellen, die Datensätze generieren, die Big-Data-Tools nutzen, um die potenzielle Qualität eines durch eine Simulation generierten zukünftigen Zustands zu bewerten. Ein asynchroner Prozess eignet sich für die größten Probleme, bewegt sich jedoch in Richtung Echtzeit, da der Big-Compute-Stack schneller verarbeiten kann als die erforderliche Reaktionszeit. Beispielsweise laufen Training (asynchron) und Inferenz (Echtzeit) beim Deep Learning auf einem Big-Compute-Stack von Funktionen lokal am Edge oder zentral in der Cloud, sofern die Latenzen dies zulassen.
Deep Learning, die erste Big-Compute-Killer-App
Der erste wirkliche Durchbruch im Big Compute war die Kategorie der tiefe Lernen Software. Deep Learning ist eine Teilmenge der Algorithmen des maschinellen Lernens, die massiv parallele Berechnungen erfordert und sich daher hervorragend für GPU-Hardware eignet, die ursprünglich für die parallele Verarbeitung von Grafikthreads entwickelt wurde. Deep-Learning-Algorithmen gibt es schon seit Jahrzehnten, aber ihr jüngster Erfolg ist auf hochspezialisierte, auf diese Arbeitslast zugeschnittene GPU-Hardware zurückzuführen. Außerdem ist es möglich, eine schlüsselfertige Full-Stack-Lösung zu entwickeln, auf der die Softwarealgorithmen laufen, ohne dass man ein Experte für die Implementierung, Parallelisierung und Orchestrierung der Algorithmen auf der Spezialhardware sein muss.
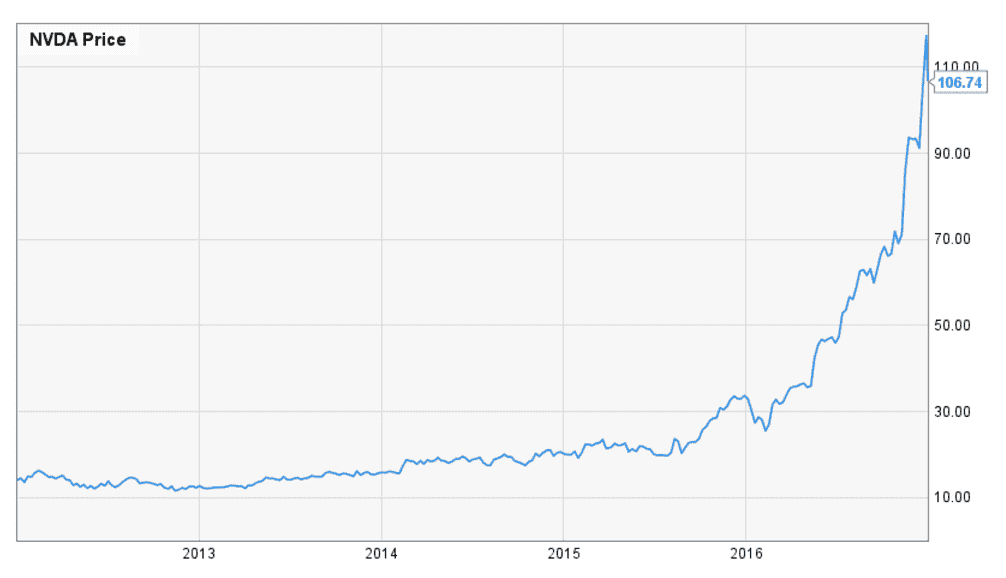
Deep-Learning-Tools gelten heute als unverzichtbare horizontale Lösung für Unternehmen. Sie bieten Analyse-, Erkenntnis- und Intelligenzfunktionen, die bisher ohne massive Investitionen und umfassendes Know-how nicht erreichbar waren. Dank eines Big-Compute-Stacks aus spezialisierter Hardware, Middleware und integrierten Algorithmen sind diese Machine-Learning-Algorithmen nun universell verfügbar. Sie sind auf der neuesten Generation spezialisierter, skalierbarer GPUs verfügbar und können schnell als Lösung implementiert werden, um bestehende Softwarefunktionen unternehmensweit mit algorithmischer Intelligenz zu ergänzen und so die internen Fähigkeiten zu verbessern. Als Marktführer im GPU-Markt NVIDIA hat „Spitzhacken während eines Goldrauschs verkauft“ und ein enormes Wachstum und eine enorme Akzeptanz erlebt, die durch die Big-Compute-Schicht vorangetrieben wurde, wodurch diese speziellen Hardwarefunktionen für jeden, der Deep-Learning-Tools verwenden möchte, schnell und einfach zugänglich sind.
Google (Alphabet) hat Deep Learning als eine grundlegende Fähigkeit betrachtet, um weiterhin führend in der Suche zu bleiben. Es wurde als so wichtig für ihre Forschungs- und Entwicklungsbemühungen angesehen, dass sie die TensorFlow Algorithmen werden in ihrem breiten Portfolio auch außerhalb der Suche eingesetzt. Sie sind so wichtig, dass sie sogar einen eigenen Tensor Processing Unit (TPU)-Chip entwickelt haben, um die Leistung auf ein Niveau zu steigern, das mit Standard-Chipsätzen nicht erreichbar ist. Dies verdeutlicht die entscheidende Bedeutung spezialisierter Hardware im Big Compute Stack für optimale algorithmische Leistung, um neue Funktionen und Innovationen voranzutreiben.
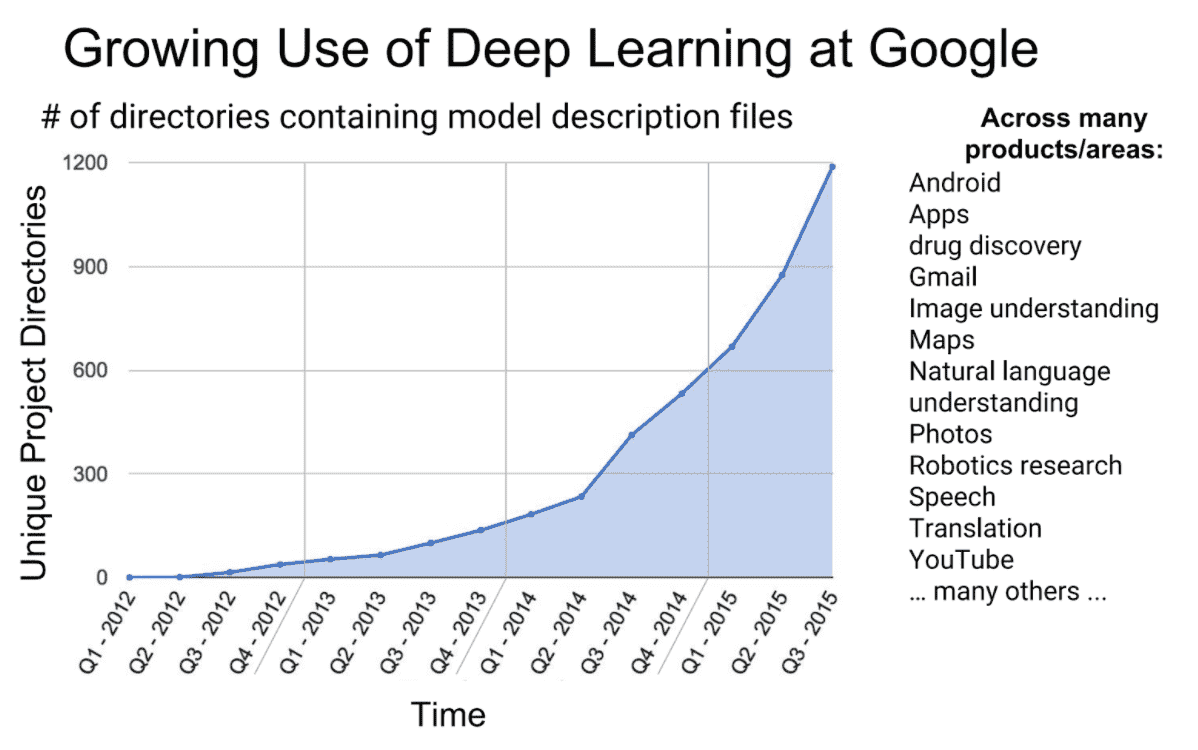
Anfang 2017 dürfte Deep Learning den Höhepunkt seines Hype-Zyklus erreicht haben, doch es zeichnet sich ein klarer, fundamentaler und langfristiger Mehrwert ab. Zumindest als Back-End-Prozess zur Optimierung hochkomplexer Situationen, in denen die Datensätze für deterministische Algorithmen zu groß sind, schafft Deep Learning Mehrwert. So dürfte Google die 500 Millionen Dollar teure Übernahme von DeepMind durch eine einzige Implementierung seiner Machine-Learning-Tools zur Verbesserung der Kühlung seines Rechenzentrums wieder hereingeholt haben.[9] DeepMind AI reduziert die Kühlkosten für Google Data Center um 40%] Es ist außerdem wahrscheinlich, dass Deep Learning neue Möglichkeiten eröffnen und weitere Innovationen in den Bereichen autonomes Fahren, Arzneimittelforschung, medizinische Bildgebung, Robotik und vielen anderen spannenden Bereichen beschleunigen wird. Deep Learning ist nur eine einzelne Kategorie von Softwareanwendungen, die vom Big Compute Stack angetrieben und ermöglicht wird.
Der entstehende Big Compute Stack
Der Big Compute Stack ist die entscheidende Grundlage, um Big Compute-Funktionen in jede Softwareanwendung zu integrieren und den komplexen Verwaltungsaufwand zu bewältigen, der für die reibungslose Ausführung von Workloads auf einer breiten Auswahl spezialisierter Infrastrukturen erforderlich ist. Es gibt völlig neue Anwendungskategorien, die mit dem Big Compute Stack erst noch erschlossen werden müssen. Analog zum Deep Learning verfügen diese über Algorithmen, die bisher rechenintensiv waren und spezielle Hardware, komplexe Middleware sowie eine umfassende Feinabstimmung und Optimierung des Stacks erfordern, um für Unternehmen wirtschaftlich rentabel zu werden.
Big Compute hat das Potenzial, die gesamte Wirtschaftslandschaft um ein Vielfaches stärker zu beeinflussen als Big Data. Big Compute bietet nicht nur Rechen- und Algorithmus-Funktionen, die die Leistungsfähigkeit und Wirkung von Big Data-Analysetools steigern, sondern eröffnet auch völlig neue Möglichkeiten, die bisher nicht möglich waren.
Der Erfolg von Deep Learning als erste Big-Compute-Killer-App signalisiert einen Trend hin zu einer exponentiell stärkeren Nutzung groß angelegter, spezialisierter Computer. Wie bei Big Data werden Big-Compute-Stack-Funktionen für Unternehmen unverzichtbar sein.
Wir bei Rescale sind überzeugt, dass Big Compute die Grundlage für zukünftige Innovationen bildet – angetrieben von Algorithmen und Software, die bisher durch fundiertes Fachwissen und hohe Vorabinvestitionen stark eingeschränkt waren, nun aber mit dem Big Compute Stack entfesselt werden. Wir entwickeln die universelle Plattform, um Big Compute-Funktionen in Unternehmen zu bringen – eine entscheidende Fähigkeit, die unserer Meinung nach notwendig sein wird, um die meisten wichtigen Innovationen in den führenden Fortune 500-Unternehmen branchenübergreifend voranzutreiben. Von der Weltraumforschung über Elektrofahrzeuge bis hin zur computergestützten Arzneimittelforschung arbeiten wir mit den führenden Unternehmen der Branche zusammen, die den Big Compute Stack als Wettbewerbsvorteil in ihren jeweiligen Branchen einsetzen.
Der Aufstieg von Big Compute wird ein breites Spektrum an Innovationen und einen enormen Geschäftswert für Unternehmen freisetzen, der bisher durch spezialisierte Hardware, Zugänglichkeit und Skalierbarkeit eingeschränkt war. Während Nachzügler von Big Compute-Funktionen einem härteren Wettbewerb um undifferenzierte Funktionen ausgesetzt sein werden, bietet sich den Vorreitern die einzigartige Gelegenheit, das vorhandene interne Know-how und die Kernkompetenzen ihres Unternehmens zu nutzen und diese mit Big Compute-Funktionen zu ergänzen, um zukünftige Innovationen zu schaffen, die unsere Welt verändern werden.
Wir freuen uns auf ein sehr spannendes Big-Compute-Jahr 2017 und darüber hinaus!
-Joris Poort, CEO, Rescale
Schauen Sie unser Video der Rescale Night in San Francisco! neu zu registrieren für die Big Compute-Community.
Mehr erfahren über Rescale. Folgen Sie uns auf LinkedIn, Twitter, Facebook und YouTube.