Rescale bietet verschiedene Software mit On-Demand-Lizenzierung an. Diese Software ist aufgrund ihres Pay-as-you-go-Prinzips beliebt. Sie bietet nicht nur einen einfachen Zugriff, sondern ist auch preislich so gestaltet, dass sie auf mehreren Kernen läuft und so schneller zur Lösung führt.
Was die Preise für On-Demand-Software betrifft, so fallen die meisten Programme in vier allgemeine Preiskategorien pro Stunde:
- Proportional – Sie zahlen proportional zur Anzahl der von Ihnen genutzten Kerne
- Pauschale – Sie zahlen einen Pauschalpreis pro Stunde, unabhängig davon, wie viele Kerne Sie nutzen
- Capped – Sie zahlen anteilig bis zu einer bestimmten Anzahl von Kernen und zahlen danach eine Pauschale
- Ermäßigt – Sie zahlen einen Nominalpreis für den ersten Kern und zahlen weniger für jeden weiteren Kern
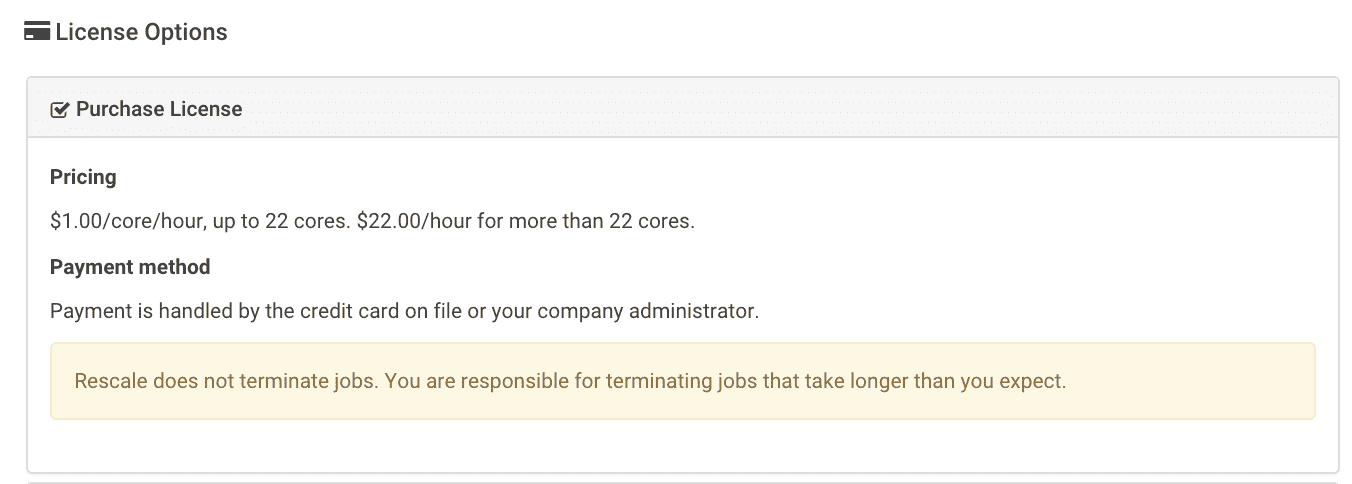
Es ist klar, dass ein proportionaler Tarif bei der Skalierung auf viele Kerne dem Kunden keinen Vorteil bringt. Die anderen drei Preismodelle können jedoch durch den Einsatz von mehr Kernen Vorteile für den Kunden bieten. Tatsächlich basiert der Vorteil sowohl auf dem Preismodell als auch auf der Skalierbarkeit des Auftrags und der Software. Die Skalierbarkeit basiert auf der Annahme, dass ein bestimmter Auftrag auf mehr Kernen schneller ausgeführt wird.
In diesem Blogbeitrag möchte ich zeigen, dass bestimmte Softwarepreismodelle die Möglichkeit bieten, Ihre Arbeit schneller und auf mehr Kernen auszuführen und dabei tatsächlich weniger zu bezahlen.
Nomenklatur
Dies ist keine wissenschaftliche Arbeit, dennoch werde ich einige Gleichungen zur Veranschaulichung einiger Konzepte im Zusammenhang mit Preis und Skalierung verwenden. Um die Gleichungen verständlicher zu machen, hier einige Definitionen
| hw | Hardware |
| I | Anzahl der Iterationen |
| k | Einige Konstanten pro Einheit |
| K | Einige konstante |
| N | Anzahl der Kerne oder Prozesse |
| p | Einzelpreis |
| P | Preis |
| sw | Software |
| t | Zeit pro Iteration |
| T | Gesamtzeit |
Das Problem
Ein Ingenieur verfügt über ein Modell und möchte wissen, wie er es am kostengünstigsten mit Rescale ausführen kann. Da sich die Kosten des Auftrags aus den Kosten für Hardware und Software zusammensetzen, müssen die jeweiligen Preismodelle berücksichtigt werden. Die Hardwarekosten werden von Rescale anteilig berechnet. Die Softwarekosten richten sich nach dem Preismodell des Softwareanbieters (ISV). Der Gesamtstundenpreis würde in etwa wie folgt aussehen:
Pgesamt = Phw + Psw
Die Gesamtkosten des Auftrags ergeben sich aus dem Stundenpreis und der Dauer des Auftrags. Dies ist der Wert, den wir minimieren möchten.
Gesamtkosten = (Phw + Psw) * Gesamtsimulationszeit
Wie bereits erläutert, können wir sagen, dass die zum Ausführen des Auftrags benötigte Zeit und die Stundenpreise von der Anzahl der verwendeten Kerne abhängen.
Phw = f(N) = phw * N
Psw = f(N)
T = f(N)
Mit diesen Informationen können wir nun versuchen, die Kosten des gesamten Auftrags zu optimieren.
Hardware-Preise
Hardware wird von Rescale anteilig berechnet. Der Stundenpreis basiert auf einem Stundensatz pro Kern, der je nach den verschiedenen Kerntypen und Preisplänen von Rescale variiert. Vereinfacht ausgedrückt ergibt sich der Stundenpreis für Hardware aus dem Stundensatz pro Kern und der Anzahl der Kerne:
Phw =Shw* N
Softwarepreise
Die Preise für On-Demand-Software werden von den ISVs festgelegt. Wie bereits erwähnt, gibt es verschiedene Preiskategorien. Die Gleichungen zur Berechnung des Stundenpreises für Software in Abhängigkeit von der Anzahl der Kerne sind relativ einfach:
| Proportional | Psw = k * N |
| Pauschale | Psw = K. |
| Capped | Psw = min(K, k * N) |
| Ermäßigt | Psw = K * f(N) Zum Beispiel: Psw = K * N.9 |
Simulationszeit und Software-Skalierbarkeit
Die Zeit zum Ausführen einer Simulation über N Prozesse/Kerne kann mit der folgenden Gleichung angenähert werden:
TSimulation = Tseriell (1 / N. + k1 * (N – 1)k2)
Wo T.seriell ist die Zeit, die für die serielle Ausführung der Simulation benötigt wird. Der blaue Teil beschreibt die reine Rechenzeit, der rote Teil den Kommunikationsaufwand. Wenn Sie die Begründung interessiert, lesen Sie weiter. Andernfalls springen Sie zu „Kostenkalkulation“.
Die Details:
Es gibt viele Möglichkeiten, Skalierbarkeit zu modellieren. Amdahls Gesetz wird oft zitiert, um die Skalierbarkeit im Verhältnis zu den verschiedenen Teilen der Simulation darzustellen, die von der Skalierung über zusätzliche Ressourcen profitieren. Es geht jedoch nicht darauf ein, wie der Nutzen zusätzlicher Ressourcen definiert oder quantifiziert werden kann. In unserem Fall haben wir ein Modell mit fester Größe und möchten wissen, wie es sich verhält, wenn wir es über eine zunehmende Anzahl von Hardwarekernen skalieren. Gehen wir zur Veranschaulichung von einigen Annahmen aus:
- Die Simulation ist iterativ
- Die Simulation wird auf N Prozesse auf N Kernen verteilt
- Jeder Prozess benötigt Informationen von anderen Prozessen, um die nächste Iteration zu berechnen und verwendet MPI
- Die Anzahl der Iterationen, I, um die Simulation abzuschließen, ist unabhängig von N
- Die Anzahl der Rechenzyklen, die zum Abschließen einer Iteration erforderlich sind, ist unabhängig von N
Unter diesen Annahmen beträgt die zum Abschließen einer Iteration benötigte Zeit:
tIteration = tberechnen + Tmit uns kommunizieren,
wenn es sich bei Compute und Communicate um synchrone Operationen handelt. Andernfalls, wenn man sie als asynchrone (nicht blockierende) Operationen betrachtet,
tIteration = max(tberechnen, Tmit uns kommunizieren,)
Schließlich lässt sich die Gesamtrechenzeit einfach aus der Iterationszeit und der Anzahl der Iterationen berechnen.
T = tIteration * Ich ∝ tIteration
Hier gehen wir davon aus, dass jede Iteration mehr oder weniger gleich ist.
Rechenzeit
Für Rechenzeit, Annahme (5) gibt uns
tberechnen = tseriell / N
Dies bedeutet, dass unser Modell ohne Kommunikationsaufwand eine lineare, starke Skalierung aufweist. Es zeigt uns auch, dass je größer das Modell (tseriell), desto größer tberechnen und der weniger nachteilige Effekt des Kommunikationsaufwands auf die relative Lösungszeit aufgrund der Dominanz von tberechnenDas Ergebnis ist, dass größere Modelle lassen sich besser skalieren.
Kommunikationszeit
Das Zeit zu kommunizieren ist komplizierter und hängt unter anderem davon ab, wie schnell die Verbindung ist, wie viele Daten übertragen werden müssen und wie viele Prozesse N es gibt.
Lassen Sie es uns vereinfachen und aufschlüsseln.
Die Kommunikationszeit zwischen zwei Prozessen kann als zwei Teile definiert werden: der Kommunikationsaufwand (Latenz) und die Datenübertragungszeit (privaten Transfer). Um also eine Nachricht von einem Prozess zu einem anderen zu senden, können wir vorerst einfach Folgendes definieren:
tNachricht = tLatenz + Tprivaten Transfer = tLatenz + (Übertragungsrate * Nachrichtengröße)
Die Übertragungsrate ist bei kleinen Nachrichten niedriger und steigt mit zunehmender Nachrichtengröße an, bis sie bei der Bandbreite der Verbindung ihren Höhepunkt erreicht. Wir können vorerst davon ausgehen, dass die Latenz für eine gegebene Verbindung konstant ist.
Um die Wirkung in der Praxis zu sehen, wird in diesem Artikel (https://mvapich.cse.ohio-state.edu/static/media/publications/abstract/liuj-sc03.pdf) untersucht die Leistung von MPI auf verschiedenen Verbindungen. Das Dokument zeigt, dass die Kommunikationszeit bei kleinen Nachrichtengrößen mehr oder weniger konstant ist.
tNachricht ≅ k
Mit diesem Wissen können wir schlussfolgern, dass Die Gesamtzeit für die Kommunikation hängt von der Anzahl der von jedem Prozess gesendeten Nachrichten ab.Die Anzahl der gesendeten Nachrichten hängt wiederum von der Anzahl der Prozesse ab, da vermutlich jeder Prozess mit jedem anderen Prozess kommuniziert. Eine Gleichung, mit der sich die Anzahl der gesendeten Nachrichten modellieren lässt, lautet:
Nachrichten = k1 * (N – 1)k2 ∝ tNachricht
Darüber hinaus können wir k normalisieren1 durch die Anzahl der Iterationen und damit tseriell
tmit uns kommunizieren, = tseriell * k1 * (N – 1)k2 ∝ tNachricht
Etwas zusammensetzen
Die Gesamtzeit für die Simulation beträgt
TSimulation ∝ tIteration = tberechnen + Tmit uns kommunizieren,
wenn Berechnung und Kommunikation synchrone (blockierende) Operationen sind. Durch Substitution
TSimulation = Tseriell (1 / N. + k1 * (N – 1)k2)
Abrufen der Konstanten
Die Konstanten können durch Anpassung der Gleichung an empirische Benchmarkdaten ermittelt werden. Das hier vorgestellte Kommunikations-Overhead-Modell ist keineswegs ein Allheilmittel. Unsere internen Benchmarks haben gezeigt, dass diese Gleichung für fast alle Skalierungszahlen gut geeignet ist.
Darüber hinaus haben wir festgestellt, dass in der Regel k2 ≅ 0.5. Wir haben auch festgestellt, dass k1 ist eine Funktion der Modellgröße, des Verbindungstyps und der Prozessorleistung.
Kostenkalkulation
Kehren wir zu unserer Gesamtkostengleichung zurück:
Gesamtkosten = (Phw + Psw) * TSimulation
Die Gesamtkosten hängen nun vom verwendeten Software-Preismodell ab.
Gesamtkosten = f(N) = (phw * N +Psw) * Tseriell (1 / N + k1 * (N – 1)k2)
Einen Excel-Rechner finden Sie hier [Link]. Hier ist eine Beispielausgabe: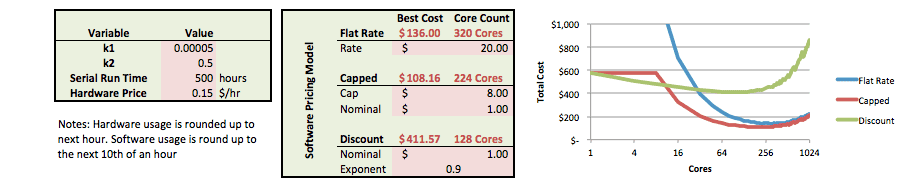
Wie wir helfen können
Das Support-Team von Rescale kann Ihnen dabei helfen, die richtige Anzahl an Kernen für Ihre Simulation zu ermitteln. Es ist nicht immer möglich, für jeden einzelnen Anwendungsfall Benchmarks durchzuführen. Wie im obigen Beispiel gezeigt, hat eine Abweichung von ein paar Kernen keinen großen Einfluss auf die Kostenersparnis.
Wir möchten Sie darauf aufmerksam machen, dass mit einer guten Skalierungssoftware und einem Flatrate or begrenzt Preismodell Es ist oft kosteneffizienter, auf mehreren Kernen zu laufen.