Beim Aufführen HPC in der Cloud, Einer der Arbeitsablauf. und Aufgaben Ingenieure und Wissenschaftler müssen, ist die Handhabung großer Mengen von frustriertenDie Frage, die sich Ingenieure oft stellen müssen, lautet: „Welche Daten sind für mich nützlich und wie kann ich sie in funktionaler Form darstellen?“ Wenn alle Daten in der Cloud gespeichert sind, ist es wichtig, die Zeit zwischen der Datengenerierung und der Möglichkeit, die Daten praktisch zu nutzen, zu minimieren. Das einfache Herunterladen von Gigabytes an Daten ist weder die bevorzugte noch die effizienteste Methode.
Natürlich verfolgen verschiedene Anwendungen unterschiedliche Ziele. Manchmal möchte der Ingenieur alle Ausgabedaten lokal speichern und schnell zugänglich machen. In anderen Fällen erweist sich die Cloud als praktische Möglichkeit, Daten für Projekte zu speichern, und der Ingenieur kann jederzeit Daten von vor Monaten ausgeführten Jobs herunterladen. Die Bearbeitungszeit für einen HPC-Job ist jedoch entscheidend. Es gibt verschiedene Ansätze, um die Bearbeitungszeit für datenintensive Jobs zu minimieren. Im Folgenden finden Sie einige praktische Möglichkeiten Neu skalieren Kunden minimieren den Zeitaufwand durch die Optimierung ihres Umgangs mit Daten.
LS-DYNA vor/nach
LS-DYNA-Jobs können große Datenmengen erzeugen. Der Benutzer bestimmt, welche Daten sein Job generiert. Wie oft der Lauf auf die Festplatte schreibt und welche Daten geschrieben werden, kann der Benutzer konfigurieren. Der durchschnittliche Ingenieur ist sich zwar nicht hundertprozentig sicher, welche Daten er benötigt, glaubt aber, eine gute Vorstellung davon zu haben, was er letztendlich verwenden wird. Er entscheidet sich, möglichst viele Daten in Binärdateien zu speichern und weiß, wie er das praktische Wrapper-Skript von Rescale zur Ausführung seiner LS-DYNA-Jobs verwendet:
ls-dyna -n -s ; -i -p
Der Ingenieur spart jedoch Download-Bandbreite, indem er die integrierte Befehlszeilenoption „Postprocessing“ von Rescale verwendet und das Flag „-d“ verwendet, um seine Eingabedateien in einer einzigen .db-Datei nachzuverarbeiten:
ls-dyna -n 16 -s 4 -i big-model.k -p single -d create_postdb.inp
Da er die Informationen kennt, die er wahrscheinlich benötigt (Verschiebung, plastische Dehnung, Von-Mises-Spannungen und Dicke), könnte seine Datei create_postdb.inp etwa so aussehen:
d3plot output.db state_on = 10, 20, 30, 40, 50, 60, 70, 80, 90, 100 Verschiebung plastische Dehnung von_mises_stress Dicke
Der Ingenieur muss nun nur noch die Datei output.db mit allen gewünschten Informationen herunterladen. Statt 35 GB Daten lädt er also eine einzige 1 GB große Datei herunter. Anstatt anderthalb Stunden auf den Download seiner Datei zu warten, verkürzt sich die Zeit für den Download aller benötigten Daten auf wenige Minuten.
Nachbearbeitung im Cluster
Ein anderer Ingenieur läuft CFD konvergierenIhr Auftrag wurde gerade abgeschlossen und hat 40 GB Daten generiert. Glücklicherweise hat sie ihre SSH-Anmeldeinformationen auf der Seite „Rescale-Einstellungen“ eingerichtet:
Sie hat ihren öffentlichen Schlüssel eingegeben, den Rescale auf allen ihren Rescale-Knoten installiert hat, und eine CIDR-Regel eingerichtet, sodass ihre Knoten nur von ihrem Netzwerk aus zugänglich sind. Die Job-Logs haben ihr mitgeteilt, wie sie sich mit dem Cluster verbinden kann: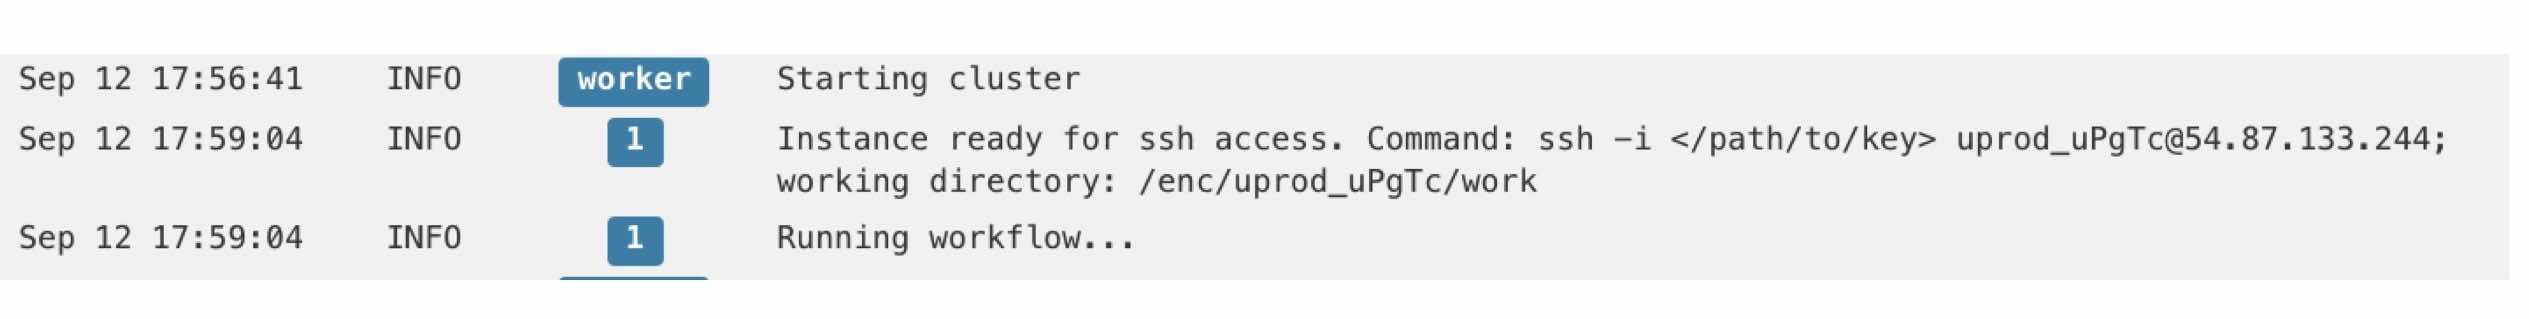
Sie kann sich nun ganz einfach per SSH mit ihrem Cluster verbinden, indem sie den Befehl in ihr Terminal kopiert und einfügt oder Putty unter Windows verwendet. Sobald sie in ihrem Knoten angemeldet ist, führt sie einfach Folgendes aus:
post_convert
Dadurch wird das praktische Post-Processing-Tool von Converge CFD gestartet, mit dem sie ausgewählte Datensätze in Tecplot, Ensight oder andere plotfähige Formate konvertieren kann. Sie kann diese kleinen Plot-Dateien nun per SCP oder SFTP auf ihre lokale Festplatte herunterladen.
Ich möchte nicht über den Download aller meiner Daten „synchronisieren“
Der erste Ingenieur führt viele Aufträge mit Rescale aus. Doch wenn er morgens ins Büro kommt, stellt er fest, dass viele seiner Aufträge über Nacht abgeschlossen wurden. Glücklicherweise musste er nicht alle Ausgabedateien manuell herunterladen, sondern nutzte das praktische Java-basierte Befehlszeilenprogramm von Rescale, um die Dateien nach Abschluss eines Auftrags auf seine Festplatte herunterzuladen.
Nachdem er einen API-Schlüssel von Rescale angefordert hatte, startete er das Befehlszeilenprogramm von seinem Arbeitscomputer mit dem einfachen Befehl:
java -jar rescale.jar sync -p abcdef1234567890 -d 600
Der Befehl nutzt die API von Rescale, um alle 10 Minuten zu prüfen, ob neue Aufträge abgeschlossen wurden. Falls ja, lädt Rescale die Dateien automatisch auf ein lokales Laufwerk herunter. Das Kommandozeilenprogramm lädt die Ausgabedaten effizient herunter und entschlüsselt sie (multithreaded). Während unser Techniker schlief, lief sein Firmennetzwerk fleißig und lud alle abgeschlossenen Aufträge auf seinen Arbeitscomputer herunter, damit er am nächsten Tag produktiver arbeiten konnte.
Demnächst verfügbar: GUI-basierte Nachbearbeitung
Obwohl die zweite Ingenieurin bereits X11-Forwarding über SSH nutzen kann, um grundlegende GUI-basierte Nachbearbeitungen in der Cloud durchzuführen, wäre eine bessere Performance sehr nützlich. Glücklicherweise muss sie nicht lange warten, da Rescale aktiv an einer Remote-Desktop-Lösung für GUI-basierte Nachbearbeitung arbeitet.
Intelligenter Umgang mit Daten
Wenn es um Daten in der Cloud geht, kommt es im Endeffekt darauf an, die Ihnen zur Verfügung stehenden Tools so effizient wie möglich zu nutzen. LS-DYNA und CFD konvergieren sind nicht die einzige Software, die benutzerfreundliche Nachbearbeitungstools für die Befehlszeile bietet. Viele andere auf Rescale verfügbare Tools bieten dieselbe Funktionalität.
Die Frage „Was wird in der Cloud und was lokal erledigt?“ lässt sich nur beantworten, wenn Sie entscheiden, wie sich Rescale am besten in Ihre bestehenden Entwicklungsprozesse einfügt. Manchmal ist es praktisch, alle Daten vor Ort zu haben und gleichzeitig auch die gesamte Nachbearbeitung vor Ort durchzuführen. Oftmals kann jedoch ein größerer Teil der Entwicklungsarbeit in die Cloud verlagert werden, wie die beiden Entwicklungsbeispiele zeigen.
Aus diesem Grund ist es unser Ziel bei Rescale, alle notwendigen Tools bereitzustellen, um den Umgang mit Daten so gering wie möglich zu halten.
Erfahren Sie mehr über die neuesten Datenverwaltungslösungen von Rescale
Vereinbaren Sie eine Demo mit einem unserer Experten