
Reduzierung der Rechenzeit für mehrere Betriebspunktsimulationen bei der Skalierung
Einführung
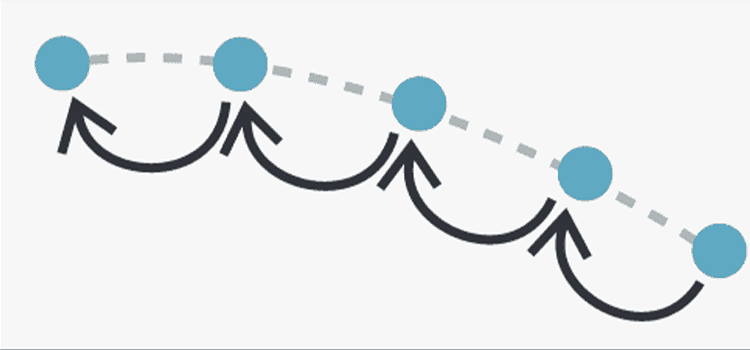
Computersimulationen werden häufig verwendet, um das Verhalten eines Systems unter verschiedenen Bedingungen zu untersuchen, z. B. CFD-Simulationen (Computational Fluid Dynamics) eines Flügels bei verschiedenen Mach-Zahlen oder eines Triebwerkskompressors bei unterschiedlichen Druckverhältnissen. Diese Simulationen sind rechenintensiv und können einige Stunden bis Tage dauern. Eine Strategie zur Verkürzung der Lösungszeit besteht darin, die Simulation mit einer besseren Anfangsbedingung zu starten. Durch die Bereitstellung einer Anfangsbedingung, die der endgültigen Lösung „näher“ kommt, sind weniger Iterationen erforderlich und die Rechenzeit wird verkürzt. Die Bereitstellung einer geeigneten Anfangsbedingung kann auch die Simulationsstabilität verbessern, insbesondere bei Betriebspunkten mit komplexer Physik wie dem Strömungsabriss.
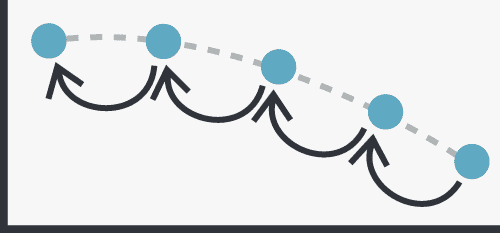
In diesem Beitrag simulieren wir die turbulente Strömung um einen Flügel für einen Bereich von Mach-Zahlen von 0.5 bis 0.9 bei einem Anstellwinkel von etwa 3 Grad. Die Ergebnisse der vorherigen Berechnung werden als Ausgangsbedingung für die nächste verwendet (z. B. werden die Ergebnisse für Mach 0.5 verwendet, um die Berechnung für Mach 0.6 zu initialisieren). Der turbulente ONERA M6 Lernprogramm für den Open-Source-CFD-Solver Stanford University Unstructured (SU2) dient als Grundlage dieser Berechnungen. Die hier verwendeten Mesh- und Konfigurationsdateien stammen aus dem SU2 Github-RepositoryWährend die Verwendung einer vorherigen Lösung als Eingabe für die nächste Berechnung mithilfe der Rescale-Schnittstelle schon immer möglich war, können Benutzer dies mit dem neuen Python SDK „Benutzerdefinierte Optimierung“ programmgesteuert und innerhalb eines einzelnen Auftrags tun.
Sie können die folgenden Links verwenden, um den Job zu klonen oder anzuzeigen und ihn zu verfolgen:
Klonauftrag
Job anzeigen
Python-Skriptentwicklung
Der erste Schritt besteht darin, das Python-Skript für die Berechnungen zu entwickeln und die SU2-Konfigurationsdatei für die Aufgabe anzupassen. Ein ähnliches „Templating“-Konzept wie bei Design of Experiment-Jobs wird hier verwendet. Mehrere Zeilen der Konfigurationsdatei input-template.cfg werden angepasst, um die Wertebefüllung durch das Python-Skript zu ermöglichen (wie unten zum Festlegen der Mach-Zahl). Die vollständige Konfigurationsdateivorlage finden Sie im Job.
%--- DEFINITION DER KOMPRESSIBLEN FREIEN STRÖMUNG ---% % % Mach-Zahl (dimensionslos, basierend auf den Werten der freien Strömung) MACH_NUMBER= ${Mach} % % Anstellwinkel (Grad, nur für kompressible Strömungen) AoA= 3.06
Das für die Berechnungen verwendete Python-Skript ist unten vollständig aufgeführt. Wir werden anschließend die einzelnen Teile besprechen, wichtige Konzepte hervorheben und Vorschläge machen. Beachten Sie, dass eine SU2-Berechnung eine spezielle „Neustart“-Datei erzeugt, um eine weitere Berechnung zu starten. Diese Neustartdatei enthält die Werte der Lösungsprimitiven an jedem Knotenpunkt.
importiere optimization_sdk als rescale importiere os importiere shutil CONFIG_TEMPLATE_FILE = 'input-template.cfg' MESH_FILE = 'mesh.su2' # Hilfsfunktion zum Auffüllen der Vorlage def replace_in_file(filepath, pattern, replacement): with open(filepath, 'r') als f: data = f.read() data = data.replace(pattern, replacement) with open(filepath, 'w') als f: f.write(data) # Definiere die Betriebspunkte (in Mach) op_points = (0.5, 0.6, 0.7, 0.8, 0.9) # Definiere eine Gesamtlaufanzahl rescale_run = 1 # Durchlaufe die Betriebspunkte für Mach in op_points: print "Run: %d Mach: %0.4f..." % (rescale_run, mach) # Kopiere die Konfigurationsdatei der Eingabevorlage und fülle sie auf config_run = 'input-%d.cfg' % rescale_run shutil.copyfile(CONFIG_TEMPLATE_FILE, config_run) replace_in_file(config_run, "${Mach}", str(mach)) input_files = [config_run, MESH_FILE] # Definieren Sie die resultierende „Neustart“-Datei aus der Berechnung restart_file = 'restart_file_%d.dat' % rescale_run replace_in_file(config_run, "${Restart-file-out}", restart_file) output_files = [restart_file] # Richten Sie den Solver so ein, dass er von der vorherigen Lösung aus neu startet if rescale_run != 1: # Neustart ist möglich replace_in_file(config_run, "${Restart}", 'YES') restart_file_previous = 'restart_file_%d.dat' % (rescale_run - 1) input_files.append(restart_file_previous) else: # Dies ist der erste Durchlauf, daher ist kein Neustart möglich replace_in_file(config_run, "${Restart}", 'NO') restart_file_previous = 'none' replace_in_file(config_run, "${Restart-file-in}", restart_file_previous) # Befehl zum Ausführen von SU2 auf dem Compute-Cluster generieren und absenden! command = 'parallel_computation.py -n $RESCALE_CORES_PER_SLOT -f %s' % config_run run = rescale.submit( command, input_files=input_files, output_files=output_files, var_values={'Mach': mach} ) # Warten Sie, bis der Lauf abgeschlossen ist, und erhöhen Sie die Laufnummer run.wait() rescale_run += 1
Beginnend mit dem ersten Block,
importiere optimization_sdk als Neuskalierung importiere os importiere shutil CONFIG_TEMPLATE_FILE = 'input-template.cfg' MESH_FILE = 'mesh.su2'
Hier importieren wir die Python-Module os und shutil, die für Dateioperationen nützlich sind. Wichtiger ist jedoch das Rescale-Optimierungs-SDK, das zum Senden von Läufen verwendet wird. Dieses Modul wird beim Ausführen eines benutzerdefinierten Optimierungsjobs automatisch im Python-Pfad platziert. Die Dateinamen der Konfigurationsvorlage und des Meshes werden ebenfalls deklariert.
# Definieren Sie die Betriebspunkte (in Mach) op_points = (0.5, 0.6, 0.7, 0.8, 0.9) # Definieren Sie eine Gesamtanzahl der Läufe rescale_run = 1 # Durchlaufen Sie die Betriebspunkte für Mach in op_points: print "Run: %d Mach: %0.4f..." % (rescale_run, mach) # Kopieren Sie die Konfigurationsdatei der Eingabevorlage und füllen Sie sie aus config_run = 'input-%d.cfg' % rescale_run shutil.copyfile(CONFIG_TEMPLATE_FILE, config_run) replace_in_file(config_run, "${Mach}", str(mach)) input_files = [config_run, MESH_FILE] # Definieren Sie die resultierende „Neustart“-Datei aus der Berechnung restart_file = 'restart_file_%d.dat' % rescale_run replace_in_file(config_run, "${Restart-file-out}", restart_file) output_files = [Neustartdatei]
In diesem Block definieren wir zunächst eine Liste von Mach-Zahlen, die jeden der Betriebspunkte darstellen, und es wird eine globale Laufanzahl definiert (rescale_run). Diese Laufanzahl ist nicht erforderlich, aber für Trackingzwecke nützlich. Dann geben wir eine For-Schleife ein, um jeden der Betriebspunkte auszuführen. Eine laufspezifische Konfigurationsdatei wird erstellt und mit der gewünschten Mach-Zahl gefüllt. Als Nächstes definieren wir eine Liste mit Eingabedateinamen für den Lauf, nämlich die Konfigurationsdatei und die Mesh-Datei. Diese Dateien werden vom Optimierungsknoten auf den/die Rechenknoten übertragen. Schließlich wird die resultierende „Neustart“-Datei aus der Berechnung restart_file_.dat genannt und in der Konfigurationsdatei festgelegt. Diese Neustartdatei wird einer Liste von Ausgabedateien hinzugefügt, die nach Abschluss des Laufs von dem/den Rechenknoten zurück zum Optimierungsknoten übertragen werden.
Beachten Sie, dass sich alle verbleibenden Blöcke innerhalb der oben definierten For-Schleife befinden.
# Richten Sie den Solver so ein, dass er von der vorherigen Lösung neu startet, wenn rescale_run != 1: # Neustart ist möglich replace_in_file(config_run, "${Restart}", 'YES') restart_file_previous = 'restart_file_%d.dat' % (rescale_run - 1) input_files.append(restart_file_previous) sonst: # Dies ist der erste Durchlauf, daher ist kein Neustart möglich replace_in_file(config_run, "${Restart}", 'NO') restart_file_previous = 'none' replace_in_file(config_run, "${Restart-file-in}", restart_file_previous)
Hier legen wir die Anfangsbedingung für den Solver fest. Handelt es sich nicht um den ersten Durchlauf, steht eine Neustartdatei zur Verfügung, um die Anfangsbedingung festzulegen. In diesem Fall wird in der Konfigurationsdatei die Neustartdatei des vorherigen Durchlaufs verwendet und der Liste der Eingabedateien hinzugefügt. Handelt es sich um den ersten Durchlauf, ist keine Neustartdatei verfügbar. Dies wird in der Konfigurationsdatei festgelegt.
# Generieren Sie den Befehl zum Ausführen von SU2 auf dem Compute-Cluster und senden Sie ihn ab! command = 'parallel_computation.py -n $RESCALE_CORES_PER_SLOT -f %s' % config_run run = rescale.submit( command, input_files=input_files, output_files=output_files, var_values={'Mach': mach} )
Als nächstes wird der Befehl zum Ausführen der Berechnung definiert. parallel_computation.py ist ein von SU2 bereitgestelltes Python-Wrapper-Skript für Multi-Core-Berechnungen. Beachten Sie die Verwendung von $RESCALE_CORES_PER_SLOT zur Definition der Anzahl der Kerne. Diese Umgebungsvariable wird automatisch basierend auf Ihren Hardwareeinstellungen erstellt. Anschließend wird der Lauf übermittelt, wobei der auszuführende Befehl, die Ein- und Ausgabedateien und schließlich die Variablenwerte für diesen Lauf (in diesem Fall nur die Mach-Zahl) angegeben werden.
# Warten Sie, bis der Lauf abgeschlossen ist, und erhöhen Sie die Laufnummer run.wait() rescale_run += 1
Im letzten Block weisen wir das Skript an, auf den Abschluss des Laufs zu warten, bevor die For-Schleife fortgesetzt und die Anzahl der Läufe erhöht wird. Die Neustartdatei des Laufs wird automatisch von den Compute-Knoten zurück zum Optimierer-Knoten übertragen, da wir sie als Ausgabedatei deklariert haben.
Ausführen des Jobs beim erneuten Skalieren
Nachdem wir das Python-Skript entwickelt haben, führen wir den Job nun auf der Rescale-Plattform aus. Der „Jobtyp“ wird auf „Optimierung“ eingestellt und eine ZIP-Datei MachOpPoints.zip mit dem Python-Skript, der Mesh-Datei und der Konfigurationsvorlagendatei wird als Eingabedatei hochgeladen.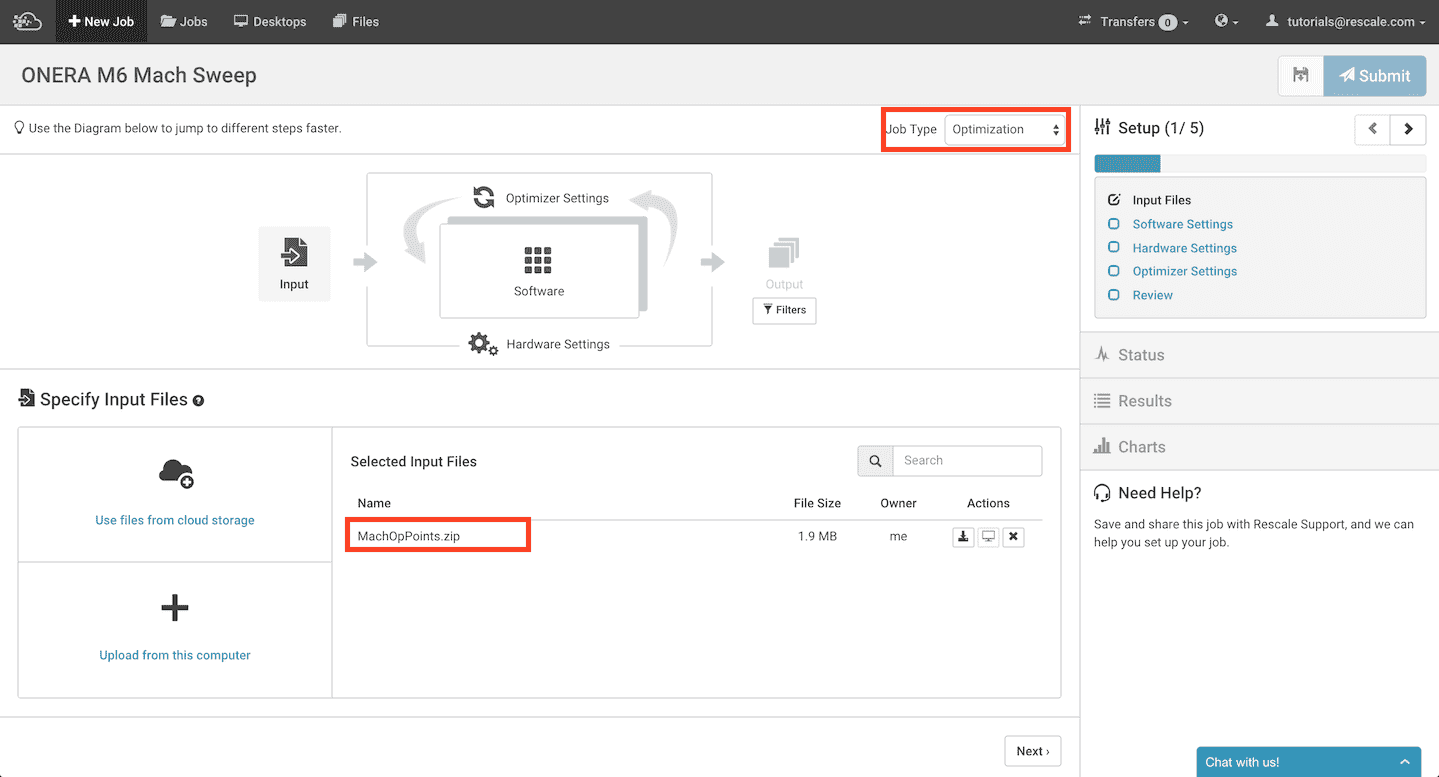
Unter „Optimizer-Einstellungen“ ist die Option „Benutzerdefiniert“ und der Befehl zum Ausführen des Python-Skripts (python runOpPoints.py) eingestellt. Als Software für diesen Job wurde ebenfalls SU2 ausgewählt.
Abschließend wählen wir auf der Seite „Hardware-Einstellungen“ 4 Nickelkerne pro Steckplatz und einen einzelnen Steckplatz (da die Berechnungen nacheinander ausgeführt werden) aus. Nun sind wir bereit, den Auftrag abzuschicken!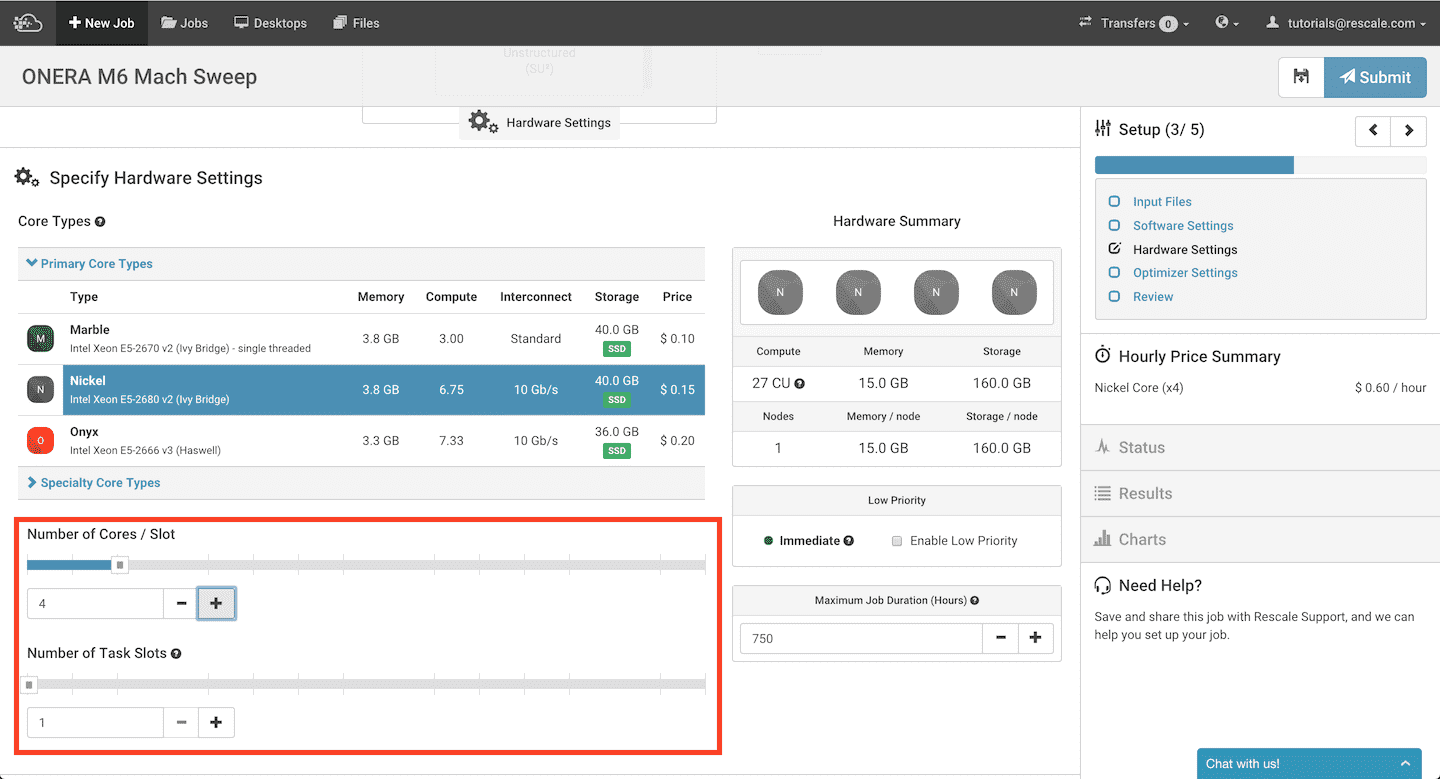
Jeder der Betriebspunkte wird als „Unterlauf“ von Lauf 1 (mit den Bezeichnungen 1.1, 1.2…) angezeigt. Sie können die Dateien der einzelnen Berechnungen live verfolgen. Im Bild unten untersuchen wir die Datei process_output.log, die die Restinformationen von SU2 für die dritte Berechnung (Mach 0.7) enthält.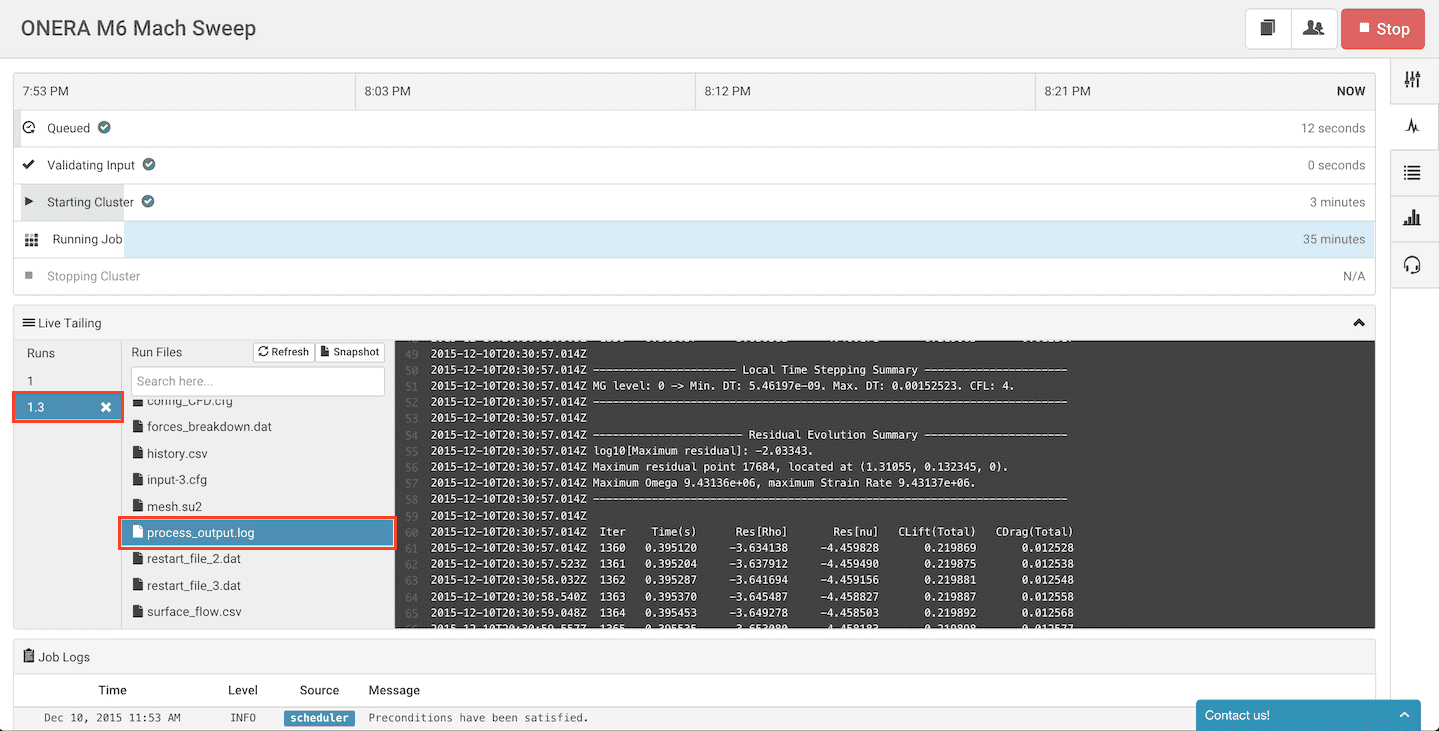
Die Fertigstellung des Auftrags dauert etwa eine Stunde. Nach Abschluss wird die Registerkarte „Ergebnisse“ wie unten dargestellt angezeigt und die fünf Durchläufe werden angezeigt.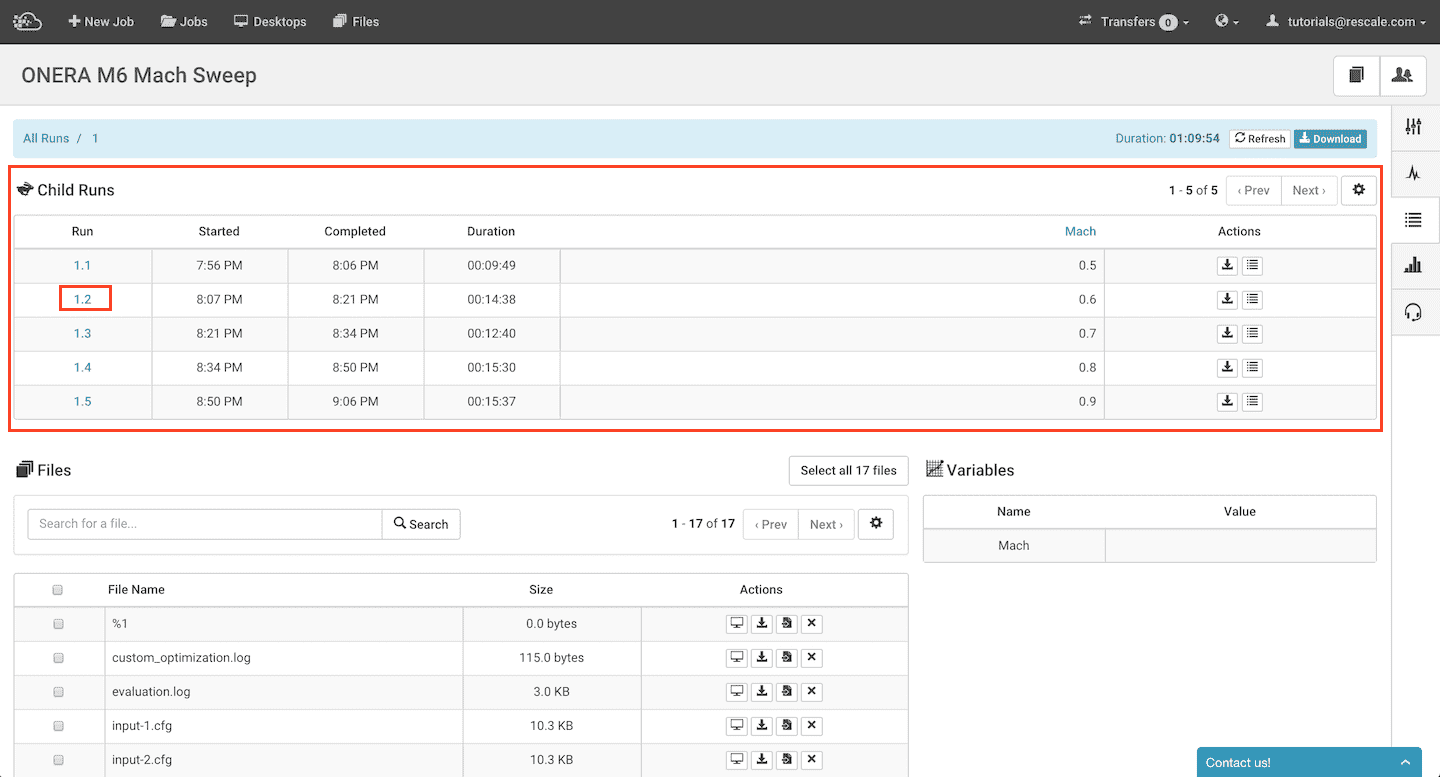
Wenn Sie auf den zweiten Lauf 1.2 klicken, werden die für diesen Job spezifischen Dateien angezeigt.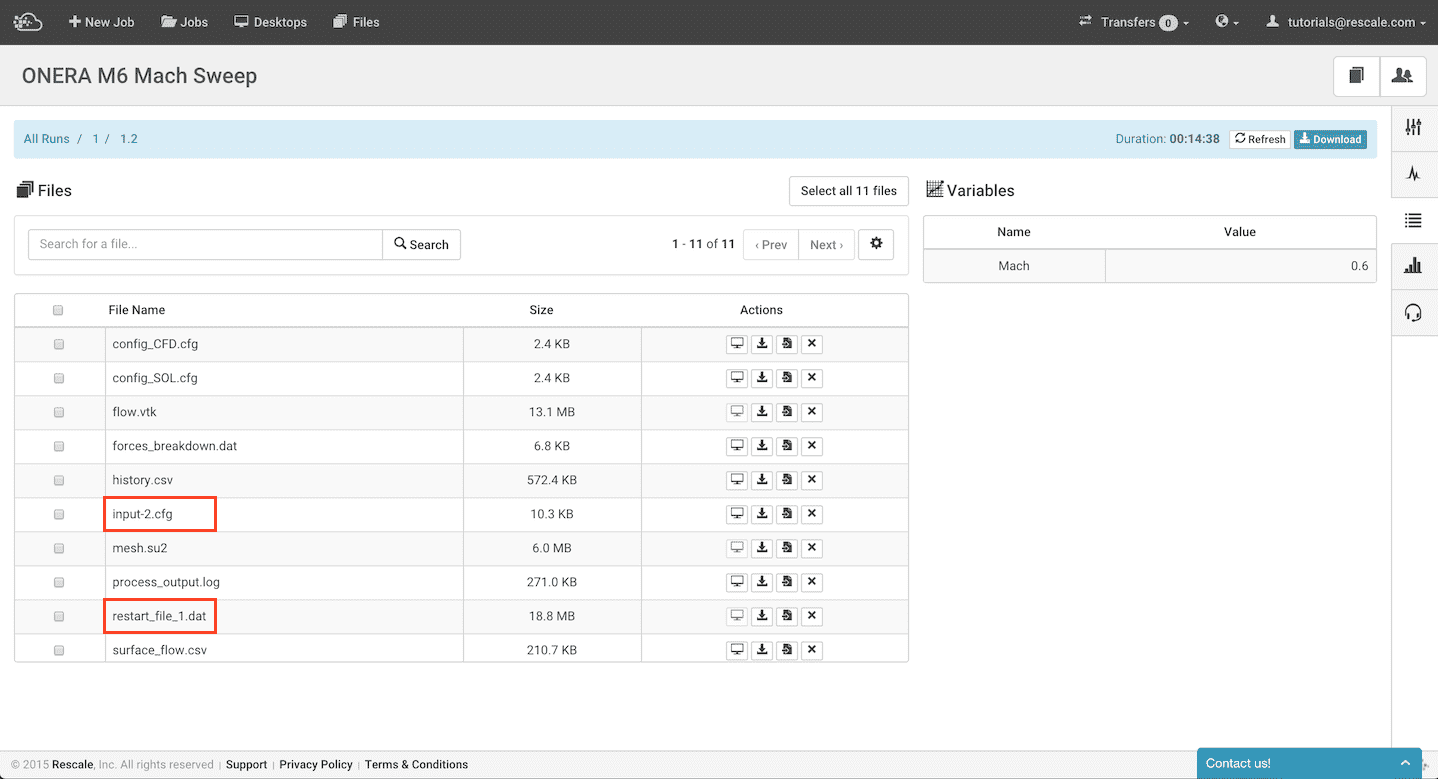
Wir sehen die vom Python-Skript erstellte Konfigurationsdatei input-2.cfg sowie die Neustartdatei restart_file_1.dat aus dem vorherigen Lauf. In der Datei process_output.log sehen wir die folgende Zeile:
Lesen Sie die Flow-Lösung aus: restart_file_1.dat.
Bestätigung, dass die Berechnung unter Verwendung der Anfangsbedingung aus der Neustartdatei gestartet wurde.
Wenn Sie mehr Informationen über die Plattform von Rescale wünschen, kontaktieren Sie uns bitte unter info@rescale.com.
