So steigern Sie die HPC-Leistung bei gleichzeitiger Kostensenkung und geringerem Energieverbrauch
High Performance Computing ist heute ein Eckpfeiler moderner Forschung und Entwicklung. Unternehmen aller Branchen setzen auf digitale Modellierung und Simulation, um Produktentwicklungszyklen zu verkürzen. Insbesondere im Ingenieurwesen Elektronische Konstruktionsautomatisierung (EDA) und die schnelle Expansion des industriellen Internets der Dinge (IIoT) treiben die HPC-Nachfrage voran.
Da Unternehmen für immer komplexere Simulationen und andere Aufgaben auf HPC zurückgreifen, müssen sie auch weiterhin die Kosten kontrollieren und den Energieverbrauch senken.
Was ist High Performance Computing (HPC)?
Im Vergleich zum Allzweck-Computing bietet HPC einen höheren Durchsatz, um komplexe Rechenprobleme mit extrem hoher Geschwindigkeit zu verarbeiten. HPC-Systeme bestehen aus drei Hauptkomponenten: Rechenleistung, Netzwerk und Speicher. Sie bündeln die Rechenleistung durch massiv parallele Verarbeitung.
HPC-Cluster bestehen aus einer großen Anzahl von Servern, die in einem Netzwerk miteinander verbunden sind. Jeder einzelne Computer wird als „Knoten“ bezeichnet. HPC-Systeme enthalten häufig 16 bis 64 Knoten mit jeweils zwei CPUs.
Der Bedarf an Hochleistungsrechnern wird durch die immer anspruchsvollere Software und die riesigen Datensätze, die für Simulationen und Analysen verwendet werden, vorangetrieben. Diese Software wird zur Verbesserung der Produktleistung in verschiedenen Disziplinen eingesetzt, darunter Flugzeugaerodynamik, autonomes Fahren, Arzneimittelforschung und Wettermodellierung. Beispielsweise Simulationssoftwareanwendungen von Ansys, Siemens, Dassault und Konvergente Wissenschaft verlassen sich auf spezialisierte HPC-Architekturen, um Computational Fluid Dynamics für die Entwicklung von Verkehrsflugzeugen, Militärflugzeugen und Raumfahrzeugen. F&E-Organisationen unterhalten in der Regel auch breites Anwendungsportfolio, einschließlich kommerzieller, Open Source- und selbst entwickelter Codes. Sicherstellen, dass sie effizient auf HPC-Infrastruktur ist eine Herausforderung, da alle unterschiedliche Anforderungen haben. Gleichzeitig wächst die Landschaft der unabhängigen Softwareanbieter (ISVs) weiter, was die Unterstützung der Nutzung fortschrittlicher F&E-Software für Unternehmen weiter erschwert.
Spezialisierte HPC-Cluster
HPC nutzt spezialisierte HPC-Cluster, um Arbeitsabläufe für bestimmte Arten von Anwendungen und Workloads zu optimieren.
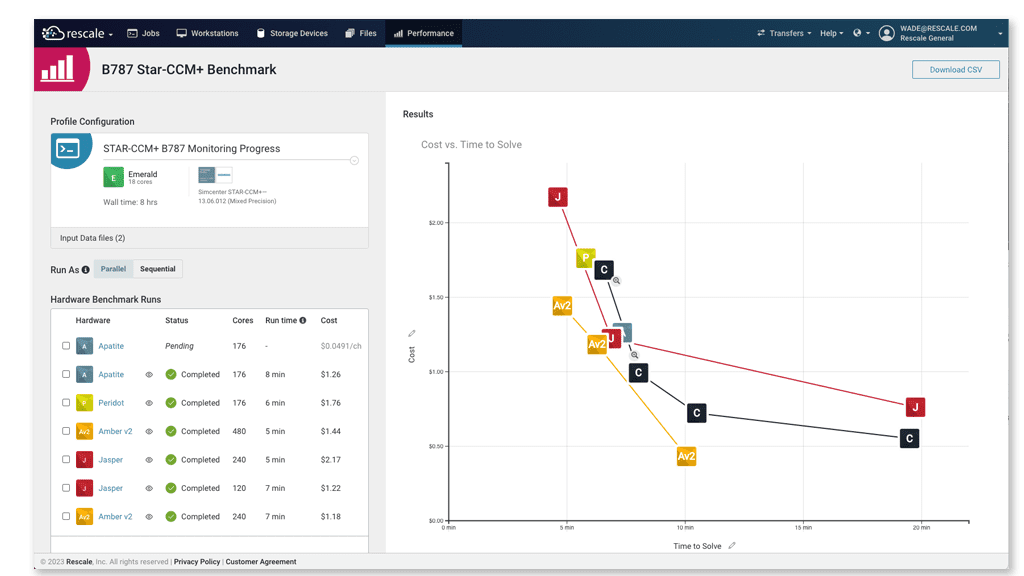
Manche Aufgaben erfordern mehr Kommunikation zwischen den Knoten sowie spezielle Hard- und Software. Die Rechenleistung eines bestimmten Workloads bestimmt die Anzahl der benötigten Knoten im Cluster. Manche Software- und Rechenaufgaben lassen sich auch mit bestimmten Halbleiterchips besser ausführen. Ein automatisiertes Benchmarking-Tool wie Leistungsprofile neu skalieren kann unglaublich hilfreich sein, um die beste Chiparchitektur für eine bestimmte Computeraufgabe zu finden.
Eine Hochleistungsverbindung für Cluster erfüllt die Anforderungen an geringe Latenz und Bandbreite. Sie verfolgt die Arbeitslast und leitet sie bei Bedarf um. Eine Möglichkeit, große Datensätze zu verarbeiten, besteht darin, HPC-Anwendungen zu bündeln und über mehrere Cluster hinweg auszuführen. Ein Cluster-Manager führt Kapazitäts- und Integritätsprüfungen durch, um verfügbare Ressourcen zu finden und zu nutzen.
Containerisierung
Einige Unternehmen nutzen für das HPC-Workload-Management auch GPU-optimierte Container, die bei KI-Implementierungen zunehmend zum Einsatz kommen. Das am häufigsten verwendete Containersystem für HPC ist der Open-Source-Apptainer (Singularity). Shifter und Docker sind weitere Optionen. Sie ermöglichen die nahtlose Integration führender KI-Anwendungen. Containerisierte Anwendungen erhöhen die Portabilität und ermöglichen die Nutzung interner und kommerzieller Anwendungen von überall aus.
Virtualisierung ist eine Alternative zur Containerisierung. Sie generiert eine virtuelle Umgebung auf dem Host-Betriebssystem. Virtuelle Maschinen (VMs) werden mit eigenen Betriebssystemen programmiert, was eine vollständige Isolierung voneinander ermöglicht. Beispiele hierfür sind Hyper-V, vSphere und OpenStack.
Warum ist HPC wichtig?
HPC liefert wichtige Informationen und Analysen in deutlich kürzerer Zeit als herkömmliche Computer. Die Geschwindigkeit von HPC bietet Vorteile für viele Bereiche – von Ingenieuren und Datenwissenschaftlern bis hin zu Produktdesignern und Forschern.
Auch Modellierung und Simulation (M&S) erreichen damit ein völlig neues Niveau. Modelle mit höherer Auflösung liefern beispielsweise detailliertere Informationen über ein neues Produkt, wodurch Prototypen und Praxistests reduziert oder überflüssig werden. Denken Sie beispielsweise an Crashsimulationen im Auto statt an echte Crashtests oder an die Ausbildung von Piloten in Flugsimulatoren statt in echten Flugzeugen.
Mit Cloud-HPC können zahlreiche Unternehmen ihren Computerbedarf schnell und bedarfsgerecht skalieren.
Einige Beispiele sind:
- Ingenieurbüros
- Forschungslabore
- Finanztechnologie (Fintech)
- Produktentwicklung
- Regierung und Verteidigung
Sogar Startups und kleine Unternehmen können die Vorteile von hochskalierbarem Cloud-HPC nutzen.
HPC-Leistung verstehen
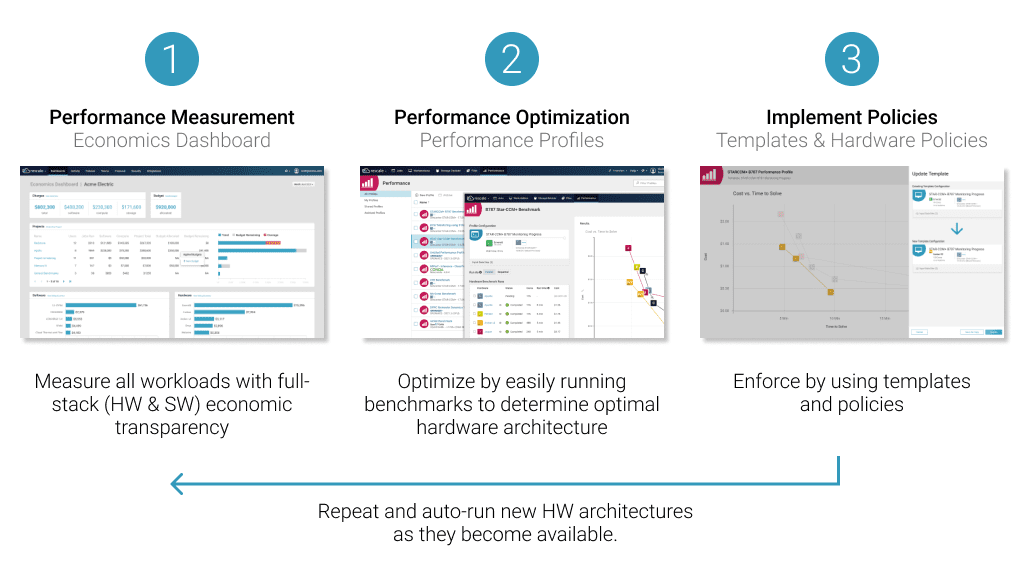
HPC-Optimierung befasst sich mit der komplexen Bereitstellung der richtigen Computerarchitektur für eine bestimmte Arbeitslast. Sie trägt auch wesentlich zur Steigerung der Energieeffizienz von Systemen bei. Eine HPC-Arbeitslast ist eine datenintensive Aufgabe, die auf Systemressourcen verteilt ist, die sich vor Ort oder in der Cloud befinden.
Moderne HPC-Systeme bewältigen enorme Arbeitslasten, darunter KI, maschinelles Lernen und Deep Learning. Sie führen Millionen von Szenarien gleichzeitig aus und verarbeiten dabei riesige Datenmengen.
Wichtige Leistungsmetriken
Analysten messen die Leistung von HPC-Systemen in Flops pro Sekunde. Derzeit steht die Frontier-Maschine im Oak Ridge National Laboratory an der Spitze der TOP500 Liste der leistungsstärksten Supercomputer mit 1.102 Eflop/s (ein Exaflop entspricht einer Trillion Berechnungen).
Eine weitere wichtige Kennzahl ist Effektivität des Stromverbrauchs (PUE), der die Energieeffizienz des gesamten Rechenzentrums bestimmt. Sie berechnen den PUE, indem Sie die Gesamtleistung, die in ein Rechenzentrum eingeht, durch die Leistung teilen, die für den Betrieb aller IT-Geräte benötigt wird. Je näher der Wert bei 1.0 liegt, desto besser ist die Gesamteffizienz. Ein weiterer Benchmarking-Standard ist Effizienz der Rechenzentrumsinfrastruktur (DCiE). Diese Kennzahl für die Energieeffizienz wird berechnet, indem die Leistung der IT-Geräte durch die Gesamtleistung der Anlage geteilt wird.
Schließlich sind Metriken zwar wichtig, aber nur bis zu einem gewissen Punkt. Letztendlich ist den Benutzern die tatsächliche Leistung am wichtigsten, die ihre Rechenaufgaben schneller macht. Es kann schwierig sein, die HPC-Leistung für alle Arten von Software und Workloads vollständig zu bewerten. Manche Halbleiterchips funktionieren bei bestimmten Softwaretypen besser als bei anderen.
Rechenengpässe
Für manche Unternehmen stellt die lokale Infrastruktur selbst einen Engpass dar. Diese Art von Infrastrukturinvestitionen wird typischerweise für eine 100-prozentige Auslastung berechnet. Sobald die Nachfrage das Angebot übersteigt, entsteht ein Engpass, da keine Kapazität mehr vorhanden ist. Im Vergleich dazu ist Cloud-HPC flexibel und lässt sich je nach Bedarf skalieren. Unternehmen können einfach mehr Rechenleistung abonnieren. Dadurch bietet HPC in der Cloud volle Auslastung, ohne an die Grenzen begrenzter Kapazitäten zu stoßen.
In HPC-Systemen gibt es viele weitere potenzielle Engpässe, darunter Speicherkapazität, E/A-Durchsatz und Speichergeschwindigkeit/-kapazität. CPU-Kerne, Taktfrequenz oder Caching können die Leistung ebenfalls einschränken, während andere Hemmnisse die Bandbreite des Netzwerk-Switches betreffen können.
Ein weiteres Problem ist die Speicherkapazität, da höhere Datenübertragungsraten einen höheren Speicherbedarf für Pufferung und Speicherung bedeuten. Herkömmlicher DDR3-, DDR4- und sogar DDR5-Speicher kann zum Engpass werden. High-Bandwidth Memory (HBM) ist jedoch eine mögliche Lösung, da es die achtfache Bandbreite von DDR5-Speicher bietet.
Um Engpässe zu vermeiden, ist es außerdem wichtig, die Softwarespezifikationen an HPC-Konfigurationen anzupassen, die die Leistung optimieren.
HPC-Energieeffizienz
Die Energieeffizienz von HPC-Systemen, gemessen in Flops pro Watt, verbessert sich kontinuierlich. Ein Beispiel hierfür ist die Henry System am Flatiron Institute in New York City mit einem Effizienzwert von 65.09 GFlops/Watt.
Rechenzentrumsbetreiber verbessern die Energieeffizienz kontinuierlich auf vielfältige Weise. Beispielsweise reduzieren stromsparende Chipsätze der nächsten Generation den Energieverbrauch und leiten Wärme besser ab. Leistungsoptimierte IP-Cores reduzieren zudem den Energieverbrauch und den Datentransport über Speicher mit hoher BandbreiteEinige Betreiber haben sich alternativen Nachhaltigkeitsmethoden zugewandt, wie Flüssigkeitskühlung und Wärmerückgewinnung.
Rechenzentren suchen zunehmend nach erneuerbaren Energiequellen wie Wasserkraft, Wind, Sonne, Biomasse und grüner Wasserstoff. Es werden erhebliche Fortschritte erzielt, wie die Tatsache zeigt, dass sich der Stromverbrauch von Rechenzentren zwischen 191 und 2015 bei 2021 Terawattstunden eingependelt hat. Einmalige Migrationen von lokalen Rechenzentren haben das allgemeine Wachstum der HPC-Nachfrage jedoch etwas überdeckt.
Reaktion auf die Nachfrage nach HPC-Computing
Um die Nachfrage zu decken, stellt die Industrie leistungsstärkere Maschinen als je zuvor bereit. Die Kapazität der Systeme reicht von Petaflops bis zu Exaflops und darüber hinaus. Ein Supercomputer mit Exaflop-Kapazität benötigt eine Sekunde für eine Trillion Berechnungen. Es würde mehr als 31 Milliarden Jahre diese Anzahl von Berechnungen mit nur einer Berechnung pro Sekunde abzuschließen.
Zu den Innovationen zur Steigerung der HPC-Effizienz gehören neue Architekturen und Hardware. Beispielsweise erfüllen 3DIC und Die-to-Die-Konnektivität die neuesten Leistungsanforderungen. Und flexibleres Switching ist möglich, wenn FPGA, GPU, CPU und andere Verarbeitungsarchitekturen in einem einzigen Knoten integriert werden.
Neue Hardware bevorzugt häufig Cloud-basiertes HPC. Daher können ältere lokale Rechenzentren die Vorteile energieeffizienterer Chipsätze nicht immer nutzen. Die Migration in die Cloud ist eine Möglichkeit, den steigenden Anforderungen an Geschwindigkeit, Skalierbarkeit und Nachhaltigkeit effektiv gerecht zu werden.
Eine einfache „Lift and Shift“-Migration von lokalen Systemen in die Cloud deckt jedoch nicht immer die neuen HPC-Anforderungen eines Unternehmens ab. Manchmal kann die bestehende Infrastruktur den sich ändernden Geschäftsanforderungen nicht gerecht werden, da sie typischerweise alle vier bis fünf Jahre aktualisiert wird. Ein solch langer Zyklus kann mit den schnellen Veränderungen im HPC-Ökosystem nicht Schritt halten. Die Cloud-Nutzung bietet zudem ein relativ hohes Maß an finanzieller Flexibilität. Die HPC-Kostenmodelle von Unternehmen wechseln von längerfristigen CapEx zu kurzfristigeren Betriebskosten. Sie binden nicht so viel Kapital und können verschiedene Cloud-HPC-Kostenmodelle besser an den aktuellen Bedarf anpassen.
Wichtige Erkenntnisse
Für Unternehmen mit lokalen Rechenzentren ist die Migration in die Cloud eine wichtige Möglichkeit, die Energieeffizienz zu steigern und gleichzeitig die Kosten zu senken. Cloud HPC bietet Unternehmen jeder Größe die Möglichkeit, von den neuesten technologischen Fortschritten zu profitieren.
Die Optimierung der HPC-Leistung erfordert die Abstimmung zwischen Softwarespezifikationen und verfügbarer Hardware. Darüber hinaus können spezialisierte HPC-Cluster und Containerisierung die HPC-Leistung und Energieeffizienz steigern.
Mit der zunehmenden Nutzung von KI werden HPC-Systeme noch Energieeffizienz.
Erfahren Sie mehr von Rescale
Entdecken Sie, wie Rescale Ihrem Unternehmen dabei helfen kann, Kosten zu kontrollieren und gleichzeitig mehr Innovation zu fördern. Mit Leistungsprofileist es einfach, die beste Cloud-HPC-Architektur für Ihre Anforderungen zu ermitteln.
Erfahren Sie mehr in unserem On-Demand-Webinar „Optimieren Sie Workload-Kosten und Leistung in der Cloud.“