Das Engineering-Team von Rescale widmet sich der Lösung der Komplexität der Verwaltung High Performance Computing (HPC)-Systeme in diesem Zeitalter der Hybrid- und Multi-Cloud-Computing.
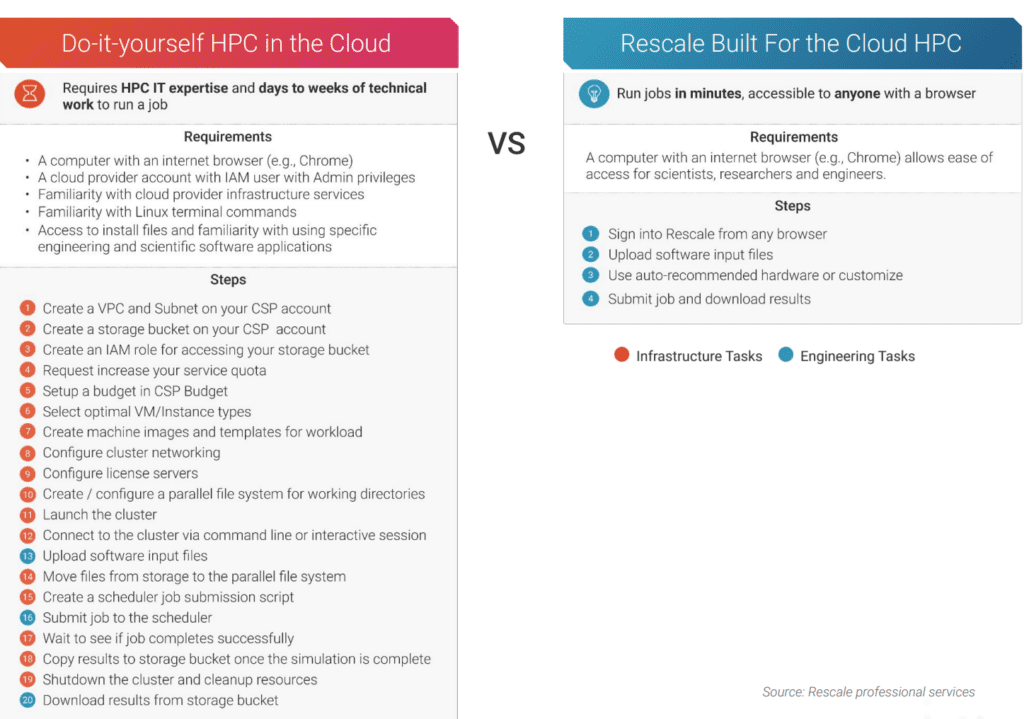
Grundlegend für HPC in der Forschung und Entwicklung ist die Erstellung eines Rechenjobs zur Durchführung einer digitalen Simulation oder einer anderen Art von Analyse. Ein Schwerpunkt des Rescale-Entwicklungsteams liegt daher auf der Automatisierung vieler Aufgaben, die für die erfolgreiche Einrichtung eines Simulationsjobs oder anderer großer Rechenaufgaben erforderlich sind.
In dieser zweiteiligen Blogbeitragsreihe werde ich die wichtigsten Aspekte der Konfiguration einer Computerumgebung für die Ausführung von HPC-Batchjobs und andere Verwaltungsaspekte behandeln, unabhängig von den von Ihnen verwendeten Tools oder Ihrer Infrastruktur (vor Ort oder in der Cloud).
In diesem ersten Beitrag werde ich zunächst definieren, was HPC-Batchjobs sind, wie sie sich von typischen IT-Batchjobs unterscheiden und welche Überlegungen zur Einrichtung erforderlich sind. Hardware-Infrastruktur und ein Netzwerk-Fabric zum Ausführen von HPC-Clustern.
HPC-Batch-Computing, definiert
In der HPC-Welt geht es bei Batch-Jobs darum, die Hardware für die Ausführung Ihrer Softwareanwendung einzurichten, um eine bestimmte Art von Rechenaufgabe (normalerweise für digitale Simulationen) durchzuführen.
Sobald Sie Ihre Rechenumgebung eingerichtet haben, können Sie loslegen und die Infrastruktur und Software die Arbeit erledigen lassen. Nach Abschluss des HPC-Auftrags können Forscher und Ingenieure die Ergebnisse überprüfen und mit der Analyse beginnen.
Mit HPC-BatchjobsDie richtige Einrichtung der Rechenumgebung ist entscheidend. HPC-Workloads können hinsichtlich ihres Rechenbedarfs stark variieren. Daher ist es wichtig, die Infrastruktur so zu konfigurieren, dass Leistung und Zuverlässigkeit gewährleistet sind. Es ist in vielerlei Hinsicht kostspielig, wenn eine Simulation aufgrund von Software- oder Hardwarekonfigurationsfehlern fehlschlägt oder nicht die gewünschten Ergebnisse liefert.
Diese Simulationen erfordern oft erhebliche Computerressourcen über einen langen Zeitraum. Das ist teuer. Während die Verwendung nur eines Knoten (ein Computer in einem Supercomputing-Cluster) ist nicht ungewöhnlich, Simulationen erfordern oft 20 oder 50 Knoten, was in der Größenordnung von Tausenden von CPU-KerneDiese Simulationen können zwischen einer halben Stunde und einer Woche oder länger dauern. Einige unserer Kunden lassen sehr lange Simulationen über Tage oder Wochen laufen, aber vier bis acht Stunden sind eine typische Laufzeit für einen HPC-Batchjob, um eine digitale Simulation abzuschließen.
HPC-Batchjobs: Kein typischer IT-Batchjob
Es gibt viele Arten von IT-Batchjobs. Wenn es jedoch um eine allgemeine Aufgabe wie das Aktualisieren einer Datenbank geht, geht es bei diesen Batchjobs eher darum, sicherzustellen, dass etwas zu einem bestimmten Zeitpunkt ausgeführt wird, als darum, die höchste Leistung aus Ihrer Hardware herauszuholen.
Das Hauptziel eines gängiger IT-Batchjobs ist: Ausführen, ohne Fehler und ohne andere zu behindern. Es wäre zwar toll, wenn er schnell laufen würde, aber der springende Punkt ist, über Nacht Zeit im Rechenzentrum zu finden, damit der Batchjob in Ruhe verarbeitet werden kann, ohne andere Aufgaben zu beeinträchtigen. Die Aufgabe muss einfach irgendwann abgeschlossen sein. Geschwindigkeit spielt bei gängiger IT-Batchjobs einfach keine Rolle.
Bei HPC-Batchjobs kommt es vor allem auf Geschwindigkeit und Effizienz an. Angesichts der Kosten für den Betrieb eigener Supercomputer oder deren Anmietung in der Cloud müssen Sie sicherstellen, dass Ihre Rechenressourcen optimal abgestimmt sind, egal ob in der Cloud oder im eigenen Rechenzentrum.
Selbst mit den uneingeschränkten Ressourcen der Cloud müssen Sie im Vergleich zu einem typischen IT-Batchjob eines Unternehmens, der über Nacht ausgeführt wird, noch viel mehr Arbeit investieren, um sicherzustellen, dass Ihre HPC-Batchjobs ordnungsgemäß ausgeführt werden.
Beim Einrichten eines HPC-Batchjobs müssen Sie zunächst sicherstellen, dass Sie die beste Chiparchitektur und die dafür verfügbaren Erweiterungen verwenden. Verschiedene Generationen von Intel- oder AMD-Chips verfügen über unterschiedliche Funktionen, und oft muss die Software konfiguriert und kompiliert werden, um diese zu nutzen.
Es gibt also erhebliche Probleme bei der Abstimmung zwischen Hardware und Software. Und dies wird immer schwieriger, da die Die Zahl spezialisierter Halbleiterchips wächst rasant. Die richtige Abstimmung zwischen Hardware und Software kann erhebliche Auswirkungen auf Kosten, Geschwindigkeit und Energieverbrauch haben.
Wichtige Überlegungen zum Einrichten von Batch-Jobs
Da es unerlässlich ist, dass Ihre HPC-Batchjobs erfolgreich und mit der erforderlichen Leistung ausgeführt werden, benötigen Sie die richtige Hardware, die optimal auf die jeweilige Anwendung abgestimmt ist. Verschiedene Simulationsanwendungen haben sehr unterschiedliche Anforderungen. Manche sind sehr speicherintensiv, andere sehr rechenintensiv. Wieder andere erfordern spezielle Halbleiterchips wie GPUs.
Zunächst sollten Sie herausfinden, welche Hardware Sie für Ihre Simulation verwenden möchten. Wenn Sie die Optimierung auf die falsche Hardware umstellen, kann der Batch-Job erheblich länger dauern, sogar um ein Vielfaches. Sie warten also länger und geben möglicherweise mehr Geld für die Rechenzeit aus.
Es muss auch ein Kompromiss zwischen Rechengeschwindigkeit und Softwarekosten berücksichtigt werden. Die Lizenzierung variiert stark, aber die anspruchsvollen und spezialisierten Anwendungen, die in Forschung und Entwicklung eingesetzt werden, sind in der Regel teuer im Betrieb, und die Lizenzkosten basieren auf einem Verbrauchsmodell (der Zeit, die mit der Anwendung für Simulationen oder andere Analysen verbracht wird).
Vor diesem Hintergrund kann es vorteilhaft sein, mehr Geld in schnellere Rechenressourcen zu investieren, um die Dauer eines HPC-Batchjobs zu verkürzen und so Softwarekosten zu sparen. Oftmals ist es sinnvoll, die Ausführung in möglichst kurzer Zeit – oder mit möglichst wenigen CPU-Kernstunden – zu optimieren, um die Lizenzkosten zu senken, da diese je nach Anwendung und Situation oft deutlich höher ausfallen als die Hardwarekosten.
Die entscheidende Bedeutung der richtigen Netzwerkstruktur
Es gibt noch eine weitere Komplexitätsachse, die bei IT-Batchjobs ungewöhnlich ist: die Netzwerkstruktur und die Konnektivität. Verschiedene Rechencluster verfügen über unterschiedliche Netzwerkstrukturen, die alle Knoten miteinander verbinden. Bei Standard-IT-Rechenjobs ist dies normalerweise kein Problem. Diese benötigen lediglich ein paar Server.
Eine der großen Herausforderungen, auf die sich das Engineering-Team bei Rescale konzentriert, besteht darin, wie die Kommunikation zwischen Knoten funktioniert und wie sich dies auf die Leistung einer HPC-Anwendung auswirkt.
Typischerweise handelt es sich bei vielen dieser Aufgaben um umfangreiche Simulationen. Diese müssen auf mehreren Knoten ausgeführt werden. Viele dieser Anwendungen setzen zudem ein feingranulares Kommunikationsmodell zwischen den Knoten voraus.
Wenn Sie Ihren Cluster oder Ihre Kommunikationsbibliotheken nicht optimal einrichten, kann dies die Laufzeit Ihrer Simulation erheblich verlängern und zu zahlreichen Ineffizienzen führen.
Bei vielen HPC-Anwendungen müssen Sie sicherstellen, dass zwischen allen Knoten eine Verbindung mit sehr geringer Latenz besteht, damit die feinkörnige Kommunikation zwischen mehreren Knoten reibungslos funktioniert.
Es gibt viele Möglichkeiten, dieses Kommunikationsnetzwerk zwischen den Knoten aufzubauen. Sie können Ethernet mit hoher Bandbreite verwenden oder InfiniBand nutzen, das geringere Latenzzeiten und eine höhere Bandbreite als die meisten Ethernet-Optionen bietet. Es gibt auch verschiedene andere Netzwerkstrukturen.
Darüber hinaus verwenden viele HPC-Anwendungen eine Bibliotheksschicht namens MPI (Message Passing Interface). MPI ist jedoch nur ein Standard, keine Bibliothek selbst. Anbieter und Entwickler erstellen ihre eigenen Bibliotheken basierend auf dem MPI-Standard.
Sie müssen also sicherstellen, dass der von Ihnen verwendete MPI-Typ gut mit der von Ihnen verwendeten Hardware kompatibel ist. Mit anderen Worten: Sie müssen nicht nur die Hardware auf die Simulationsanwendung abstimmen, sondern auch die Hardware auf die Middleware-Schicht (die Bibliothek) und dann auf die Anwendung selbst.
Das MPI muss für bestimmte Netzwerktypen konfiguriert werden. Die Konfigurationsanforderungen variieren stark zwischen verschiedenen Netzwerktypen. Es ist nicht möglich, die Konfiguration einmal für einen Netzwerktyp festzulegen und dann davon auszugehen, dass sie in allen Fällen einwandfrei funktioniert. Ohne entsprechende Anpassung kommt es zu erheblichen Leistungsschwankungen.
Und es hängt von der Anwendung ab. Viele HPC-Batch-Jobs sind jedoch eher netzwerk- als rechengebunden, da alle detaillierten Informationen zwischen den verschiedenen Knoten ausgetauscht werden müssen, damit die Simulation fortschreiten kann. Außerdem muss sichergestellt werden, dass die Bibliotheken, die die Kommunikation zwischen den Knoten steuern, richtig eingerichtet sind.
Bei HPC-Batchjobs ist das Fazit immer dasselbe: Wenn Sie nicht den gesamten Hardware- und Software-Stack für Ihre HPC-Workload optimiert haben, können Sie nicht alle Vorteile dieser teuren Hardware und Software nutzen.
Damit ist Teil 1 dieser Serie abgeschlossen. Im zweiten Teil werde ich tiefer auf die wichtigsten Aspekte der Ausführung von HPC-Batchjobs eingehen, darunter die Planung von Jobs, die Kosten fehlerhafter HPC-Jobs, Sicherheit und Multi-Cloud-Management. Bleiben Sie dran!
Mehr über erfahren Intelligent Batch von Rescale Ressourcen
Stellen Sie sicher, dass alle Ihre High Performance Computing-Jobs
Richten Sie die richtige Methode ein, um schnell, effizient und zuverlässig zu laufen.