Rescale bietet mehrere Preisoptionen für die Ausführung Ihres HPC-Simulationen: On Demand, niedrige Priorität und Prepaid. Dieser Artikel zeigt eine Analyse der Rechenleistung, um zu bestimmen, wann ein Prepaid-Tarif aus Kostensicht sinnvoll ist.
Unser Prepaid-Tarif bietet eine langfristige Reservierung von Rescale-Cores zu den niedrigsten Kosten pro Stunde. Im Gegenzug bezahlen Sie alle Stunden der Reservierung im Voraus. Prepaid-Cores sind eine hervorragende Möglichkeit, Ihre Hardwarekosten zu senken, sofern die Auslastung hoch genug ist. Im Folgenden beantworten wir zwei Fragen:
- Wie hoch muss meine Auslastung für einen bestimmten Kerntyp sein, damit ich mit Prepaid Geld spare?
- Wie viele Prepaid-Kerne sollte ich bei einem bestimmten Zeitplan für die Kernnutzung kaufen, um meine gesamten Hardwarekosten zu minimieren?
Prepaid-Kosteneinsparungen durch Nutzung
Die erste Frage wird durch Lösen dieser Gleichung berechnet:
Kosteneinsparungen = Auslastung * Gesamtreservierungsstunden * Preis auf Anfrage – Gesamtreservierungsstunden *
Preis im Voraus bezahlt
Die Prepaid-Preisoption bietet zwei Zeiträume zur Auswahl. Benutzer können Kerne für 1 oder 3 Jahre im Voraus bezahlen. Bei unserem beliebten Nickel-Kerntyp (mit einer 3-Jahres-Prepaid-Gebühr von 0.04 $/Kern/Stunde) liegt der Break-Even-Punkt, bei dem die Kosteneinsparungen gleich null sind, bei:
Auslastung = 0.04 $ pro Stunde Prepaid / 0.15 $ pro Stunde On Demand = ~ 27 %
Wenn Ihre durchschnittliche Auslastung eines Nickelkerns über 27%, Prepaid spart Ihnen Geld im Vergleich zu On-Demand-Tarifen. Wenn Ihre durchschnittliche Auslastung über ein Jahr 50% beträgt, sparen Sie 482 USD pro Jahr und Kern Verwenden Sie die Prepaid-Option über einen Zeitraum von drei Jahren anstelle von On Demand.
Wie viel muss ich für eine bestimmte Jobprognose im Voraus bezahlen?
Die obige Berechnung ist einfach, aber Sie haben möglicherweise keine Zielauslastung im Sinn. Stattdessen verfügen Sie möglicherweise über eine Prognose aller Rechenjobs, die Sie ausführen möchten, oft basierend auf der historischen Nutzung. Wie ermitteln wir anhand eines Auftragsplans die optimale Anzahl der zu kaufenden Prepaid-Kerne?
Wie zuvor berechnen wir etwas Ähnliches:
Prepaid-Ersparnisse (x Kerne Prepaid) = Alle On-Demand-Kosten – (Prepaid-Kosten (x) + Restliche On-Demand-Kosten (x))
Alle On-Demand-Kosten ist die Gesamtzahl der Kernstunden für alle Ihre Jobs während des Prepaid-Zeitraums, multipliziert mit dem On-Demand-Kernpreis.
Vorausbezahlte Kosten sind nur die Prepaid-Kosten für x Kerne.
Restkosten auf Abruf ist schwierig zu berechnen. Wir müssen die zusätzlich benötigten On-Demand-Kernstunden ermitteln und gleichzeitig die Auslastung unserer Prepaid-Kerne maximieren.
Um die verbleibenden Kernstunden zu berechnen, müssen wir die Anzahl der pro Zeiteinheit laufenden Kerne betrachten und dann nur die Kerne berücksichtigen, die nicht im Voraus bezahlt werden. Visuell packen wir die Zeitintervalle der Kernnutzung von unten nach oben und schneiden die unteren x Kerne über die Jobs hinweg heraus (die im Voraus bezahlte Kerne verwenden) und berechnen dann nur die Kosten für den Rest.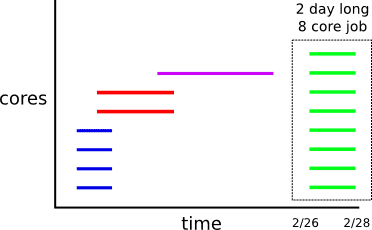
Die obige Abbildung berücksichtigt nicht, dass Kernzeitintervalle sich nicht immer vollständig überlappen oder disjunkt sind. Die Intervalle müssen in kleinere disjunkte Intervalle zerlegt werden, die wir dann von unten mit diesen Intervallteilen auffüllen.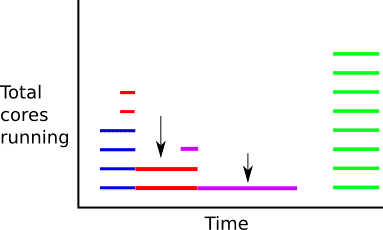
Als Nächstes zählen wir einfach die Kerne für jeden Zeitabschnitt hoch, fehlende Abschnitte haben implizit null Kerne.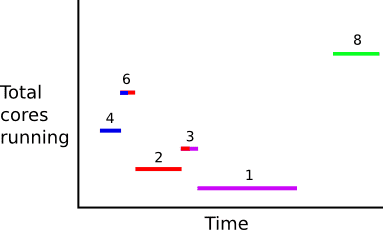
Hier haben wir unseren Reservierungszeitraum vollständig mit disjunkten Intervallen abgedeckt. Als Nächstes können wir die Anzahl der Prepaid-Kerne abziehen. Wenn wir beispielsweise 2 Prepaid-Kerne haben, erhalten wir diese verbleibenden Kernintervalle.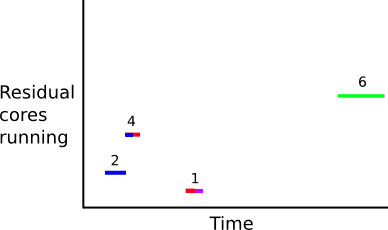
Aus diesen Intervallen addieren wir dann das Produkt aus Intervalllängen und Kernanzahl, um unsere verbleibenden Kernstunden zu erhalten.
Sehen wir uns an, wie diese Analyse programmgesteuert durchgeführt werden kann. Unsere Eingaben sind:
- Zeitplan der Rechenjobs, der eine Liste teilweise überlappender Tupel (Startzeit, Endzeit, Kernanzahl) ist
- Beginn des Prepaid-Reservierungszeitraums
- Ende des Prepaid-Reservierungszeitraums
- Anzahl der Prepaid-Kerne
def calculate_residual_core_hours(core_use_intervals, reservation_start, reservation_end, prepaid_core_count): # sortieren nach Startzeit sortierte_Intervalle = sortiert(core_use_intervals, Schlüssel=itemgenerator(0)) disjoint_intervals = chop_and_aggregate(reservation_start, reservation_end, sortierte_Intervalle) residual_core_intervals = ( (Startzeit, Endzeit, max(0, (Anzahl - prepaid_core_count))) für Startzeit, Endzeit, Anzahl in disjoint_intervals) return sum((Endzeit - Startzeit) * Anzahl für Startzeit, Endzeit, Anzahl in residual_core_intervals)
Der Großteil der Komplexität verbirgt sich hier in chop_and_aggregate. Sehen wir uns eine Implementierung davon an. Wir starten bei reservation_start und gehen zeitlich vorwärts, wobei wir die aktuell offenen Intervalle im Auge behalten. Wenn ein Intervall geöffnet oder geschlossen wird, erstellen wir ein neues disjunktes Intervall mit der aktuellen Kernanzahl zwischen den letzten beiden Zeitgrenzen.
def chop_and_aggregate(reservation_start, reservation_end, sorted_intervals): current_time = reservation_start open_intervals = Counter() closed_intervals = [] for start, end, count in sorted_intervals: # Intervalle schließen, die vor dem nächsten Intervallstart enden if open_intervals: next_end = min(open_intervals.keys()) while start >= next_end: closed_intervals.append((current_time, next_end, sum(open_intervals.values()))) del open_intervals[next_end] current_time = next_end if open_intervals: next_end = min(open_intervals.keys()) else: break # offene Intervalle zum neuen Intervallstartzeitpunkt aufteilen if open_intervals: closed_intervals.append((current_time, start, sum(open_intervals.values()))) # neues Intervall hinzufügen current_time = start open_intervals[end] += Anzahl # verbleibende offene Intervalle für Ende schließen in sortiert (open_intervals.keys()): Ende = min (Ende, Reservierungsende), wenn offene_Intervalle: geschlossene_Intervalle.anhängen ((aktuelle_Zeit, Ende, Summe (open_intervals.values()))) del offene_Intervalle[Ende] gibt geschlossene_Intervalle zurück
Zusammenfassend lässt sich sagen, dass Sie die verbleibenden Kernstunden mit dem On-Demand-Preis multiplizieren und so Ihre Kosteneinsparungen ermitteln können. Sie können „calculate_residual_core_hours“ sogar mit null Prepaid-Kernen verwenden, um (ineffizient) die gesamten On-Demand-Kosten zu ermitteln:
alle_On_Demand_Stunden = Berechne_Restkernstunden(Jobintervalle, Reservierungsbeginn, Reservierungsende, 0) Restkernstunden = Berechne_Restkernstunden(Jobintervalle, Reservierungsbeginn, Reservierungsende, Prepaid-Kerne) Einsparungen = (alle_On_Demand_Stunden * On_Demand_Preis) - (Prepaid-Kerne * Prepaid_Preis + Restkernstunden * On_Demand_Preis)
Von hier aus können Sie eine binäre Suche über die Anzahl der Prepaid-Cores durchführen, um Ihre optimalen Einsparungen zu ermitteln. Zur Optimierung müssen die disjoint_intervals nur einmal und für alle verschiedenen Prepaid-Core-Berechnungen berechnet werden.
Zusätzliche Details
Die obige Erklärung ist eine vereinfachte Darstellung unserer echten Prepaid-Option:
Verschiedene Kerntypen
Möglicherweise verwenden Sie für Ihre Aufträge mehrere Kerntypen (z. B. Marmor und Nickel). In diesem Fall trennen Sie Ihre Aufträge nach Kerntyp und führen die obige Analyse einmal für jeden Kerntyp-Charge durch. Sie erhalten die optimale Anzahl an Prepaid-Kernen jedes Typs. Beachten Sie, dass dies in manchen Situationen zu Kapazitätsverlusten führen kann und könnte am Ende teurer sein als die Ausführung auf weniger Kerntypen, auch wenn dies bedeutet, dass Sie auf leistungsstärkeren Kernen arbeiten, als für einen bestimmten Job benötigt werden.
Wir planen, in Kürze einen Prepaid-Kernrechner herauszubringen, der Empfehlungen auf Grundlage Ihrer bisherigen Rescale-Nutzung ausspricht und die obige Analyse für Sie durchführt!