Heute werden wir diskutieren, wie man mehrere GPUs nutzt, um ein einzelnes neuronales Netzwerk zu trainieren, indem man Laterne Bibliothek für maschinelles Lernen. Dies ist der erste einer Reihe von Artikeln über Techniken zum Skalieren von Trainings-Workloads für tiefe neuronale Netzwerke (DNN) zur Verwendung mehrerer GPUs und mehrerer Knoten.
In dieser Serie konzentrieren wir uns auf die Parallelisierung des Trainings eines einzelnen Netzwerks. Weitere Informationen zum peinlich parallelen Problem des effizienten Trainings mehrerer Netzwerke zur Optimierung der Konfigurationsparameter finden Sie unter dieser frühere Beitrag zur Hyperparameteroptimierung.
Über Torch
Torch ist eine leichtgewichtige, flexible Tensorbibliothek, die auf der Programmiersprache Lua aufbaut. Torch ist bei Forschern im Bereich des maschinellen Lernens beliebt, sodass viele neue Ideen für tiefe neuronale Netzwerke zuerst in Torch implementiert und als Open-Source-Erweiterungen bereitgestellt werden. Daher ist der neueste Stand der Technik im Deep Learning oft zuerst in Torch verfügbar.
Der Nachteil dabei ist, dass die Torch-Dokumentation oft hinter der Implementierung zurückbleibt. Wenn Sie also nicht auf GitHub ein Beispiel für genau das finden, was Sie tun möchten, kann es eine Herausforderung sein, herauszufinden, welche Torch-Module Sie verwenden sollten und wie Sie sie verwenden.
Ein Beispiel hierfür ist, wie Sie Torch dazu bringen, Ihre neuronalen Netzwerke mit mehreren GPUs zu trainieren. Die Suche nach „Multi-GPU-Torch“ im Internet liefert dieses GitHub-Problem als eines der Top-Ergebnisse. Daraus wissen wir, dass wir von der Torch-Umgebung aus auf mehr als eine GPU zugreifen können, aber wie verwenden wir dieses Low-Level-Konstrukt, um ein komplexes Netzwerk zu trainieren?
Daten- vs. Modellparallelität
Beim Parallelisieren der Arbeit zum Trainieren eines einzelnen neuronalen Netzwerks haben wir zwei Möglichkeiten, die Arbeit aufzuteilen: Modellparallelität und Datenparallelität.
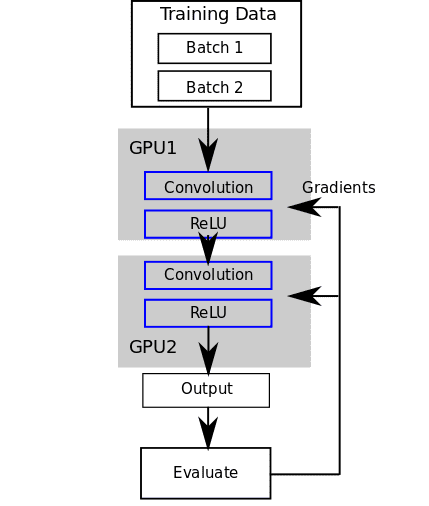
Mit der Modellparallelität führt jede GPU einen Teil der Knoten im Netzwerk für einen bestimmten Datenstapel aus.
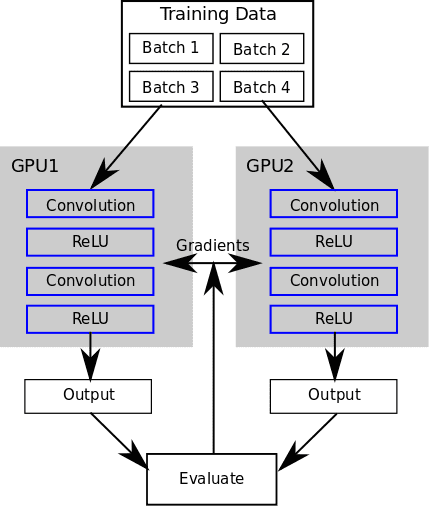
Mit Datenparallelität führt jede GPU das gesamte Netzwerk für unterschiedliche Datenstapel aus.
Diese Unterscheidung wird im Detail diskutiert In diesem Papier, aber die Wahl zwischen der einen oder anderen Methode hat Auswirkungen darauf, welche Art der Synchronisierung zwischen den GPUs erforderlich ist. Datenparallelität erfordert die Synchronisierung von Modellparametern, Modellparallelität erfordert die Synchronisierung von Eingabe- und Ausgabewerten zwischen den Blöcken.
Einfaches Fackelbeispiel
Wir werden uns nun ein einfaches Beispiel für das Training eines Convolutional Neural Networks ansehen, das auf einem Unit-Test in Torch selbstDieses Netzwerk verfügt über zwei Faltungs- und zwei Gleichrichterschichten. Wir führen einen einfachen Vorwärts- und Rückwärtsdurchlauf durch das Netzwerk durch. Anstatt Fehlergradienten für das Training zu berechnen, setzen wir sie der Einfachheit halber einfach auf einen Zufallsvektor.
erfordert „nn“ Modell = nn.Sequential() Modell:Hinzufügen(nn.SpatialConvolution(3, 3, 3, 5)) Modell:Hinzufügen(nn.ReLU(wahr)) Modell:Hinzufügen(nn.SpatialConvolution(3, 3, 3, 5)) Modell:Hinzufügen(nn.ReLU(wahr)) Eingabe = Torch.round(Tensor(16, 3, 10, 10):uniform(0, 255)) Ausgabe = Modell:Vorwärts(Eingabe) FakeGradients = Ausgabe:Klon():uniform(-0.1, 0.1) Modell:Rückwärts(Eingabe, FakeGradients)
Konvertieren wir es nun so, dass es auf einer GPU ausgeführt wird (dieses Beispiel läuft nur, wenn Sie eine CUDA-kompatible GPU haben):
erfordert „cutorch“, erfordert „cunn“, cutorch.setDevice(1) Modell = nn.Sequential() Modell:Hinzufügen(nn.SpatialConvolution(3, 3, 3, 5)) Modell:Hinzufügen(nn.ReLU(wahr)) Modell:Hinzufügen(nn.SpatialConvolution(3, 3, 3, 5)) Modell:Hinzufügen(nn.ReLU(wahr)) Modell:cuda() Eingabe = torch.round(torch.CudaTensor(16, 3, 10, 10):uniform(0, 255)) Ausgabe = Modell:vorwärts(Eingabe) fakeGradients = Ausgabe:Klon():uniform(-0.1, 0.1) Modell:rückwärts(Eingabe, fakeGradients)
Um dies auf einer GPU auszuführen, rufen wir auf anders()im Netzwerk und machen Sie dann die Eingabe zu einem CudaTensor.
Verteilen wir nun das Modell auf zwei GPUs (als Beispiel für das Modellparadigma). Wir iterieren über die GPU-Geräte-IDs und verwenden die cutorch.withDevice um jede Schicht auf einer bestimmten GPU zu platzieren.
erfordert „cutorch“, erfordert „cunn“, cutorch.setDevice(1), Modell = nn.Sequential() für i=1, math.min(2, cutorch.getDeviceCount()), führe cutorch.withDevice(i, function(), Modell:add(nn.SpatialConvolution(3, 3, 3, 5)) Ende) cutorch.withDevice(i, function(), Modell:add(nn.ReLU(true)) Ende) Ende, Modell:cuda(), Eingabe = torch.round(torch.CudaTensor(16, 3, 10, 10):uniform(0, 255)), Ausgabe = Modell:forward(Eingabe), fakeGradients = Ausgabe:clone():uniform(-0.1, 0.1), Modell:backward(Eingabe, fakeGradients)
Dadurch werden auf jeder GPU eine Faltungsschicht und eine ReLU-Schicht platziert. Die Vorwärts- und Rückwärtsdurchläufe müssen die Ausgaben zwischen GPU 1 und GPU 2 weiterleiten.
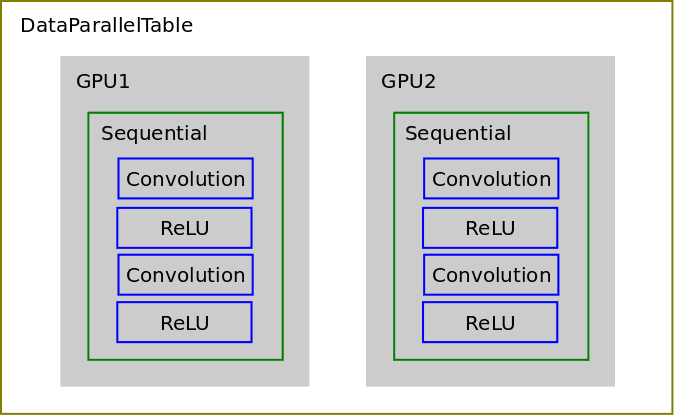
Als nächstes verwenden wir nn.DataParallelTable um Datenstapel auf Kopien des gesamten Netzwerks zu verteilen, das auf mehreren GPUs ausgeführt wird. DataParallelTable ist ein Torch-Container, der mehrere Container umschließt und die Eingabe auf sie verteilt.
erfordert „cutorch“ erfordert „cunn“ cutorch.setDevice(1) Modell = nn.Sequential() Modell:Hinzufügen(nn.SpatialConvolution(3, 3, 3, 5)) Modell:Hinzufügen(nn.ReLU(wahr)) Modell:Hinzufügen(nn.SpatialConvolution(3, 3, 3, 5)) Modell:Hinzufügen(nn.ReLU(wahr)) Modell:cuda() GPUs = torch.range(1, cutorch.getDeviceCount()):totable() dpt = nn.DataParallelTable(1):Hinzufügen(Modell, GPUs):cuda() Eingabe = torch.round(torch.CudaTensor(16, 3, 10, 10):uniform(0, 255)) Ausgabe = dpt:vorwärts(Eingabe) fakeGradients = Ausgabe:Klon():uniform(-0.1, 0.1) dpt:backward(Eingabe, gefälschteGradienten)
Anstatt die Vorwärts- und Rückwärtsdurchläufe über den ursprünglichen Sequential-Container auszuführen, führen wir sie jetzt auf dem DataParallelTable-Container aus und die Daten werden auf Kopien des Netzwerks auf jeder GPU verteilt.
Hier ist ein Job bei Rescale Sie können den gesamten oben genannten Code selbst klonen und ausführen.
Ein größeres Beispiel
Schauen wir uns nun die Anwendung von DataParallelTable beim Training eines echten DNN an. Wir verwenden Sergey Zagoruykos Implementierung von Breite Residualnetzwerke auf CIFAR10 auf GitHub.
In train.luasehen wir, dass die gesamte Parallelisierung des neuronalen Basisnetzwerks durch eine Hilfsfunktion angewendet wird:
Modell: hinzufügen (utils.makeDataParallelTable (net, opt.nGPU))
Sich eingehend mit etwas befassen makeDataParallelTablesehen wir eine ähnliche Struktur wie in unserem letzten Beispiel oben, wobei nn.DataParallelTable:add
Funktion utils.makeDataParallelTable(Modell, nGPU) wenn nGPU > 1, dann lokale GPUs = torch.range(1, nGPU):totable() lokaler schnellster, Benchmark = cudnn.fastest, cudnn.benchmark lokaler dpt = nn.DataParallelTable(1, true, true) :add(Modell, GPUs) :threads(Funktion() lokales cudnn = erfordert 'cudnn' cudnn.fastest, cudnn.benchmark = schnellster, Benchmark-Ende) dpt.gradInput = nil Modell = dpt:cuda() Ende Modellende zurückgeben
Sie können diese Jobs klonen und das Training selbst auf Rescale ausführen:
Nachdem wir das Training 10 Epochen lang ausgeführt haben, sehen wir, dass der 4-GPU-Job etwa 3.33-mal schneller läuft als der Einzel-GPU-Job. Ziemlich gute Skalierung!
In diesem Artikel haben wir Beispielimplementierungen für modell- und datenparalleles DNN-Training mit Torch vorgestellt. In zukünftigen Beiträgen werden wir die Nutzung von Multi-GPU-Training mit anderen neuronalen Netzwerkbibliotheken sowie die Skalierung mehrerer Knoten behandeln.