Das Design-of-Experiments (DOE)-Framework von Rescale bietet eine einfache Möglichkeit, die Leistung von Machine-Learning-Modellen zu optimieren. Dieser Artikel beschreibt einen Workflow zur Hyperparameteroptimierung in tiefen neuronalen Netzwerken. Eine Einführung in DOEs auf Rescale finden Sie unter dieses Webinar.
Tiefe neuronale Netzwerke (DNNs) sind ein beliebtes Modell für maschinelles Lernen und werden heute in vielen Anwendungen eingesetzt, darunter Robotik, selbstfahrende Autos, Bildsuche, Gesichtserkennung und Spracherkennung. In diesem Artikel trainieren wir einige neuronale Netzwerke für die Bildklassifizierung und zeigen, wie Sie mit Rescale die Leistung Ihrer DNN-Modelle maximieren.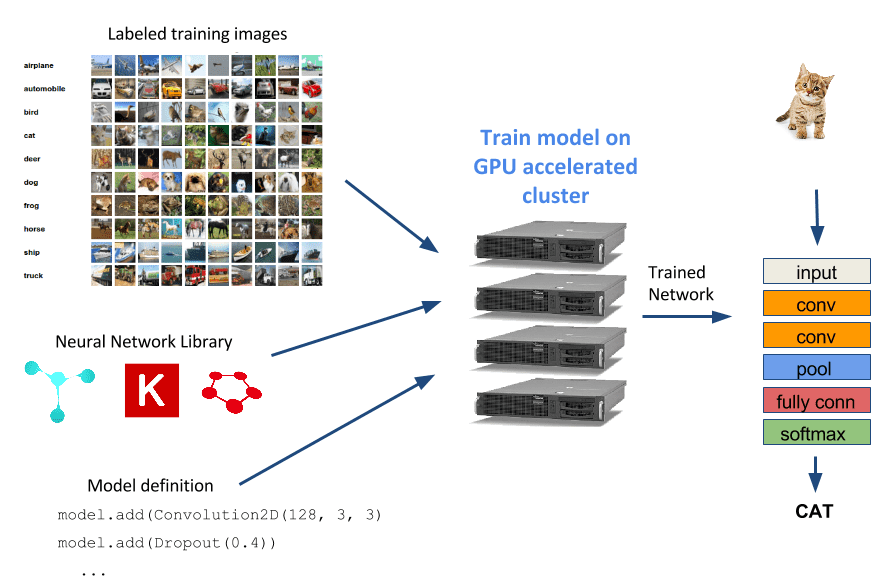
Eine Einführung in das Trainieren eines Bildklassifizierungs-DNN auf Rescale finden Sie unter dieser vorherige Artikel. Dieser Artikel geht auf das grundlegende Modelltrainingsbeispiel ein und zeigt, wie Sie die Leistung Ihres Netzwerks durch eine Technik namens Hyperparameteroptimierung verbessern können.
Hyperparameter-Optimierung
Ein typischer Ausgangspunkt für eine Aufgabe mit DNNs besteht darin, ein in der Literatur veröffentlichtes Modell auszuwählen und es in das neuronale Netzwerk-Trainingsframework Ihrer Wahl zu implementieren oder, noch einfacher, ein bereits implementiertes Modell von der Caffe Model Zoo. Sie trainieren das Modell dann möglicherweise anhand Ihres Trainingsdatensatzes und stellen fest, dass die Leistung (Klassifizierungsgenauigkeit, Trainingszeit usw.) nicht ganz ausreicht. An diesem Punkt können Sie zurückgehen und nach einem ganz neuen Modell zum Trainieren suchen oder versuchen, Ihr aktuelles Modell zu optimieren, um die gewünschte zusätzliche Leistung zu erzielen. Das Optimieren von Parametern für eine bestimmte neuronale Netzwerkarchitektur wird als Hyperparameteroptimierung bezeichnet. Hier ist eine kurze Liste häufig variierter Hyperparameter:
- Lernraten
- Chargengröße
- Trainingsepochen
- Bildverarbeitungsparameter
- Anzahl der Schichten
- Faltungsfilter
- Faltungskernelgröße
- Dropout-Fraktionen
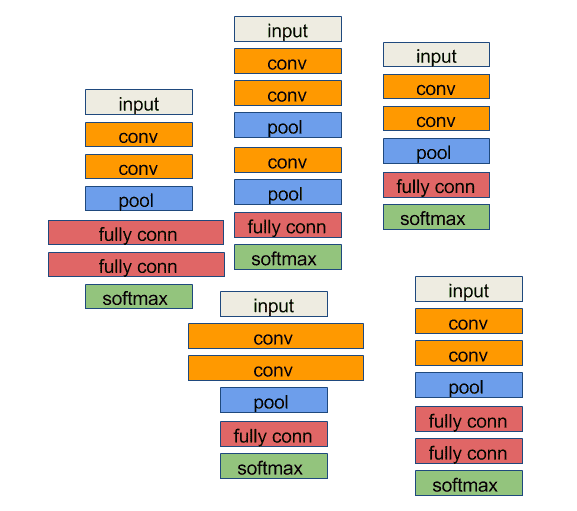
Angesichts der umfangreichen Auswahl an Hyperparametern gibt es selbst nach Festlegung der Modellarchitektur noch immer eine große Anzahl ähnlicher neuronaler Netzwerkvarianten. Unsere Aufgabe besteht darin, eine Variante zu finden, die unseren Anforderungen gerecht wird.
Randomisierte Hyperparameter-Suche DOE
Mithilfe der Rescale-Plattform erstellen wir nun einen Design-of-Experiments-Job, um Hyperparameter abzutasten und diese verschiedenen Netzwerkvarianten dann mithilfe von GPUs zu trainieren.
Für unser erstes Beispiel beginnen wir mit einem der Beispiel Faltungsnetzwerke aus dem Keras-GitHub-Repository, um einen MNIST-Ziffernklassifizierer zu trainieren. Mit diesem Netzwerk werden wir die folgenden Netzwerkparameter variieren:
- nb_filters: Anzahl der Filter in unserer Faltungsschicht
- nb_conv_size: Größe des Faltungskernels
Wir haben das Beispiel so geändert, dass es die oben genannten Vorlagenwerte enthält. Hier ist ein Auszug aus dem Skript mit den Vorlagenvariablen:
model.add(Convolution2D(${nb_filters}, ${nb_conv_size},
${nb_conv_size}))
model.add(Activation('relu'))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Dropout(0.25))
model.add(Flatten())
model.add(Dense(128))
model.add(Activation('relu'))
model.add(Dropout(0.5))
model.add(Dense(nb_classes))
model.add(Activation('softmax'))
Beachten Sie das nb_filters und nb_conv_size Parameter, umgeben von ${}Wir sind jetzt bereit, einen DOE-Job auf der Rescale-Plattform zu erstellen, der diese Vorlage verwendet.
Wenn Sie mitmachen möchten, können Sie den Beispieljob klonen:
Hartes MNIST DOE
Zuerst wählen wir oben rechts den DOE-Jobtyp aus und laden die mnist.pkl.gz-Datensatz aus dem Keras-GitHub-Repository.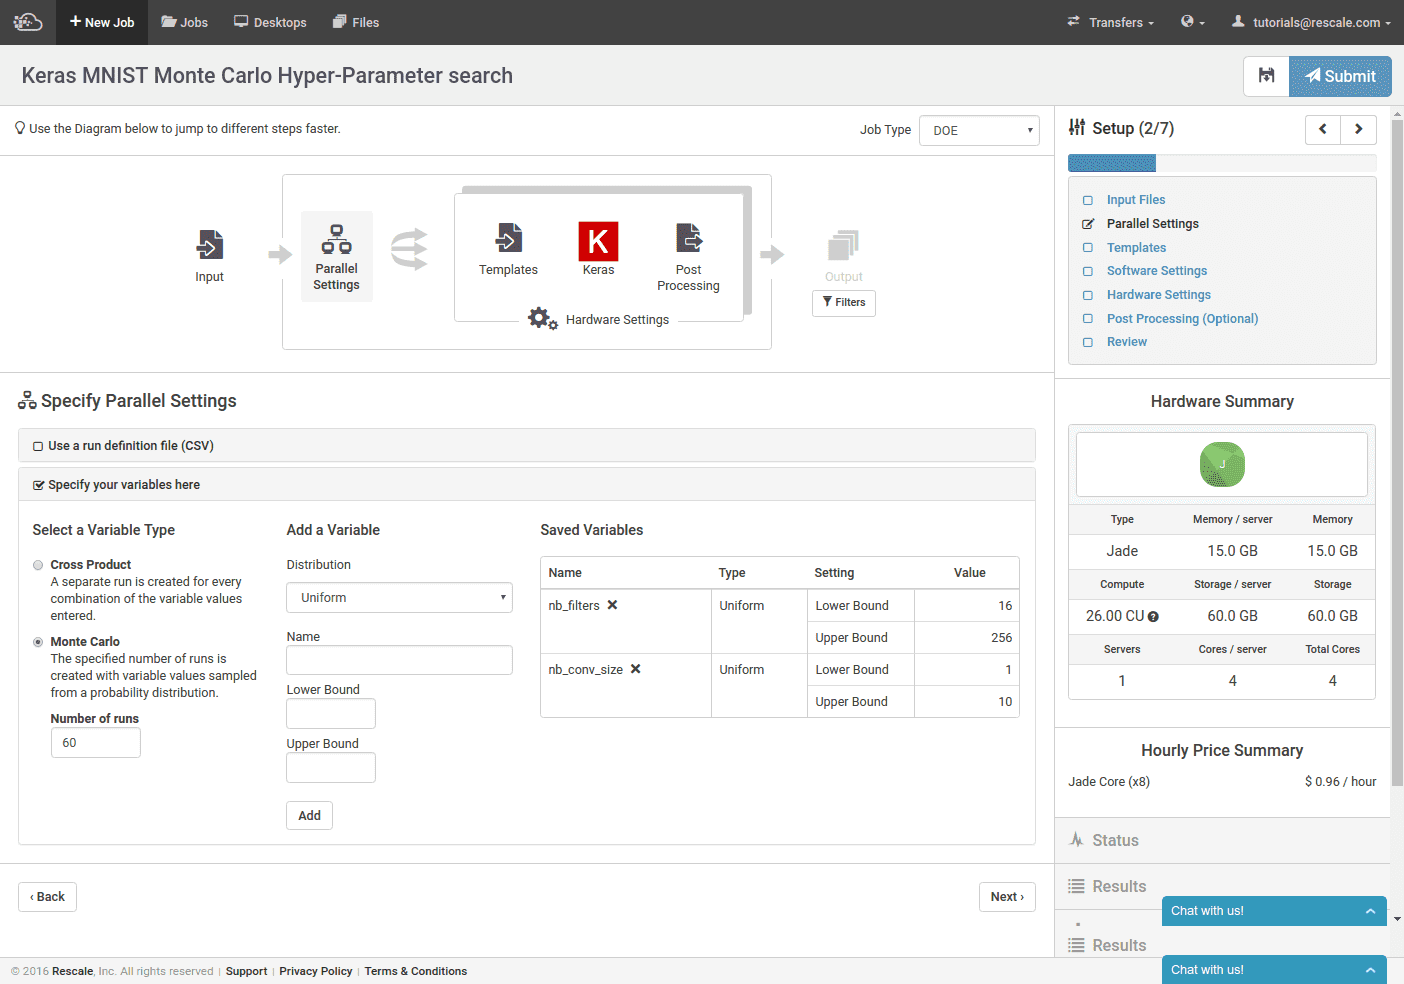
Als Nächstes geben wir an, dass wir eine Monte-Carlo-Versuchsplanung (unten links) durchführen, 60 verschiedene Trainingsläufe durchführen und unsere Vorlagenvariablen festlegen. Wir wählen die beiden Parameter, die aus einer gleichmäßigen Verteilung entnommen werden sollen, etwas willkürlich aus. Die Größe des Faltungskerns reicht von 1 bis 10 (jede Bildgröße beträgt 28 × 28, mehr als 28 wäre also nicht möglich), und die Anzahl der Faltungsfilter reicht von 16 bis 256.
Beachten Sie, dass wir unsere Vorlagenvariablenbereiche stattdessen auch mit einer CSV-Datei angeben könnten. In diesem Beispiel würden wir manuell Zufallswerte für unsere Variablen auswählen. Die CSV-Datei würde dann folgendermaßen aussehen:
Anzahl_Filter, Anzahl_Konv_Größe 16, 3 45, 8 32, 4 ...
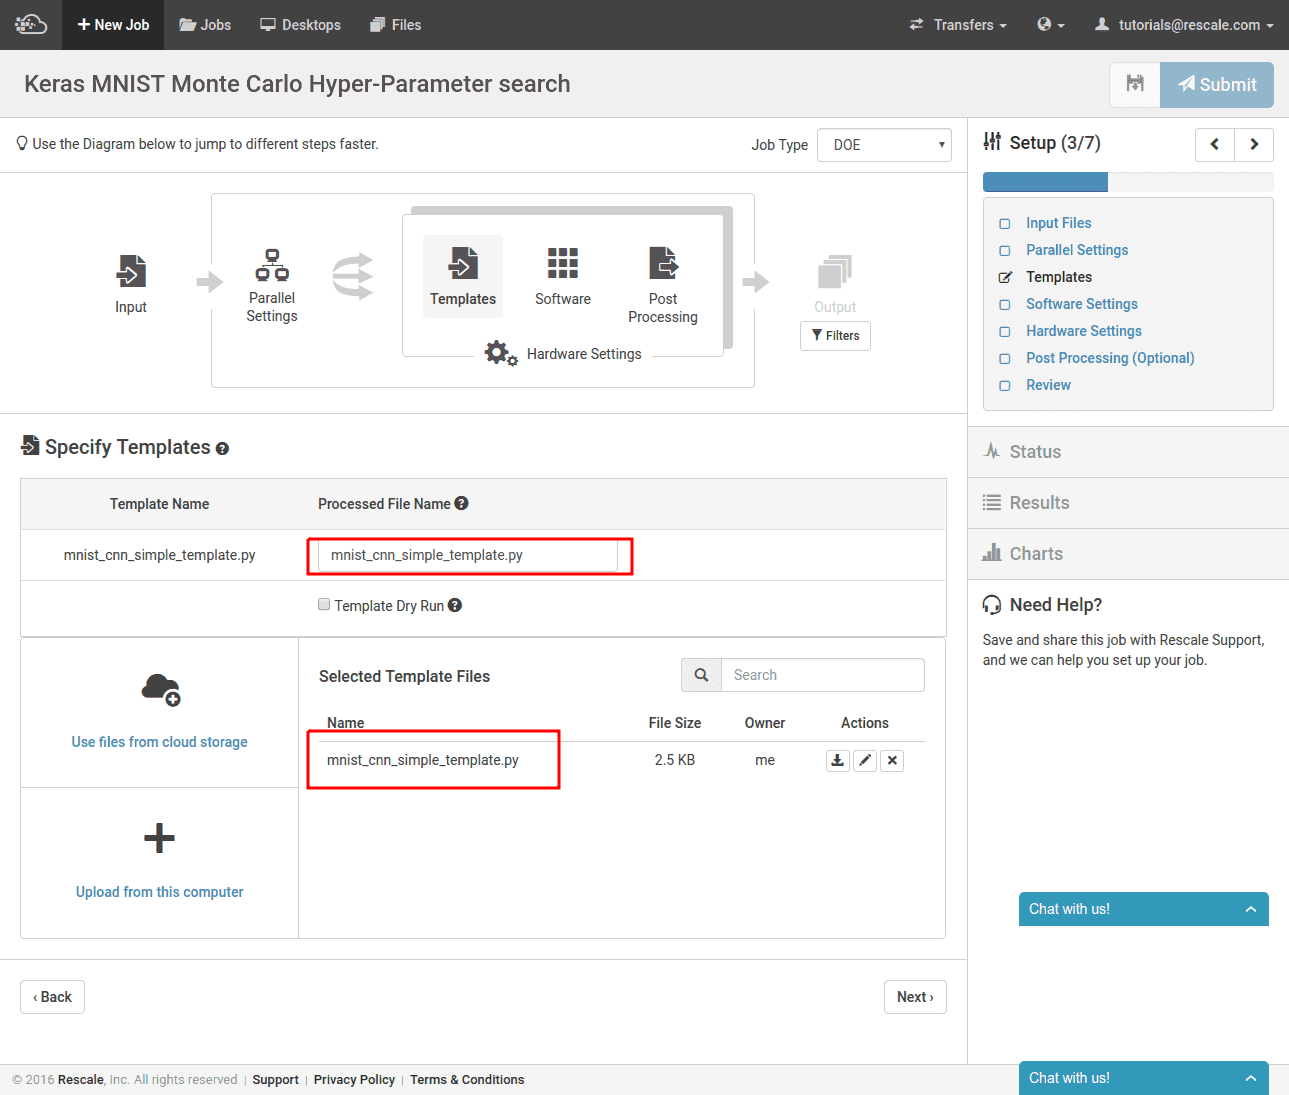
Als Nächstes laden wir die oben erstellte Keras-Skriptvorlage hoch. An dieser Stelle können wir auch einen neuen Namen für das Skript mit den eingefügten Werten angeben. Es ist auch in Ordnung, den Namen einfach beizubehalten, wie wir es hier getan haben. Die materialisierte Version überschreibt die Vorlage nicht.
Wählen Sie die gewünschte Trainingsbibliothek aus. Suchen Sie im Suchfeld nach „Keras“ und wählen Sie es aus. Wählen Sie anschließend die K520/Theano-kompatible Version aus. Anschließend rufen Sie die Kommandozeile auf, um das Trainingsskript auszuführen. Der erste Teil des Befehls besteht darin, das MNIST-Datensatzarchiv an einen Ort zu kopieren, an dem Keras es finden kann. Anschließend rufen Sie das Python-Skript auf.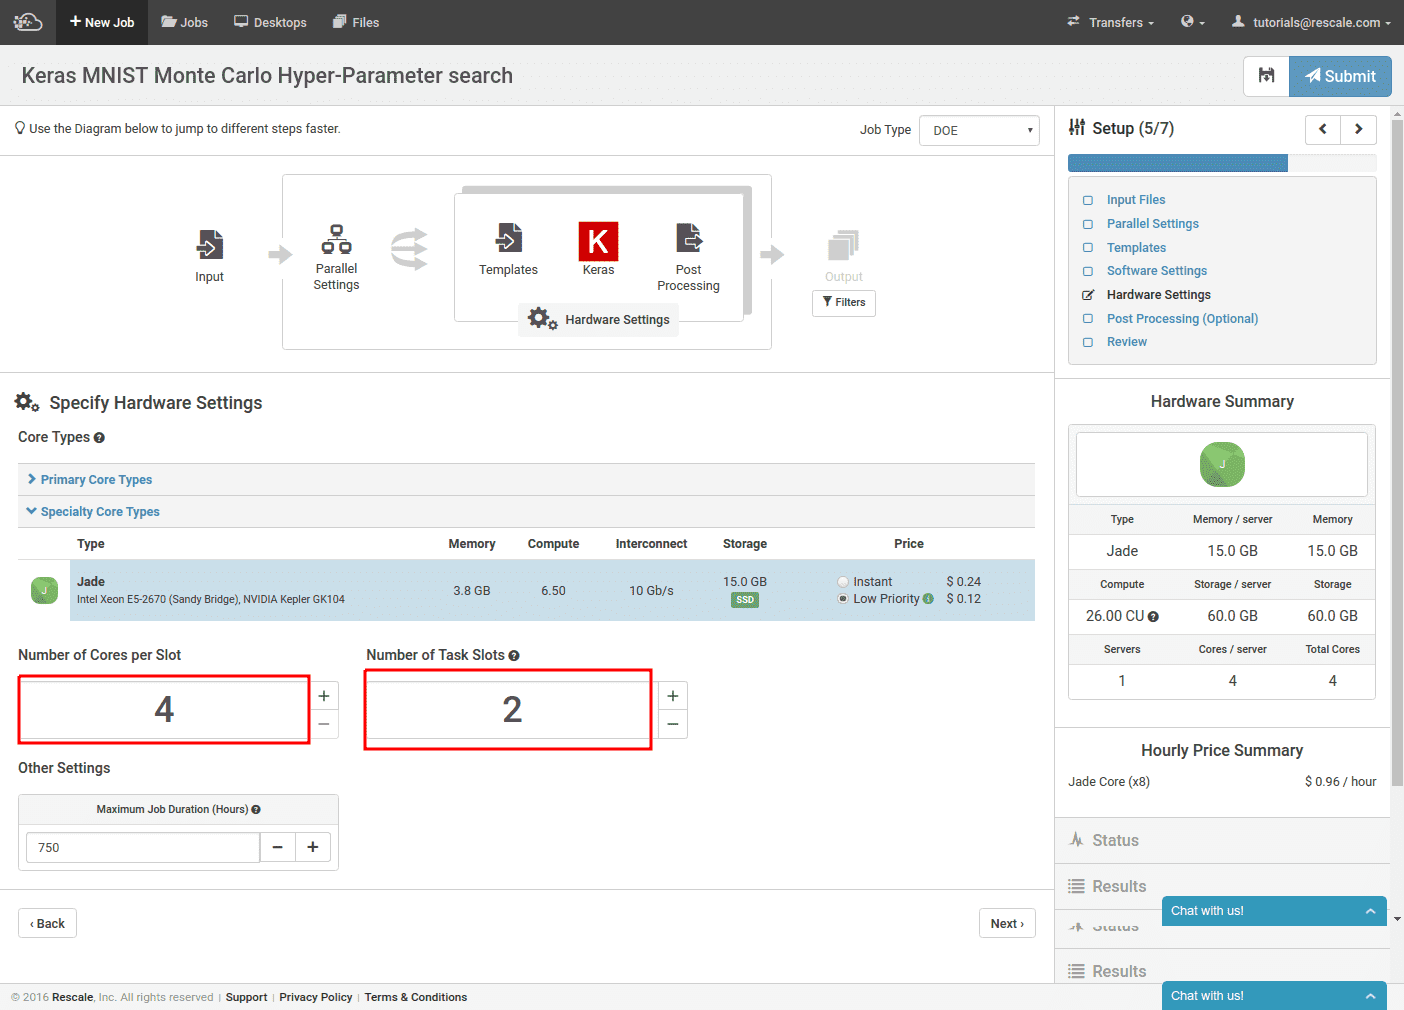
Da wir eine Version von Keras ausgewählt haben, die für die Arbeit mit K520s konfiguriert ist, ist unser Hardwaretyp bereits auf Jade eingegrenzt. Wir können nun die Größe jedes Trainingsclusters auf der linken Seite bestimmen. Die Zählung erfolgt hier in der Anzahl der CPU-Kerne. Für den Hardwaretyp Jade gibt es 4 CPU-Kerne für jeden GPU. Rechts legen wir die Anzahl der separaten Trainingscluster fest, die wir bereitstellen werden. In diesem Fall verwenden wir zwei Trainingscluster mit jeweils einer GPU pro Cluster.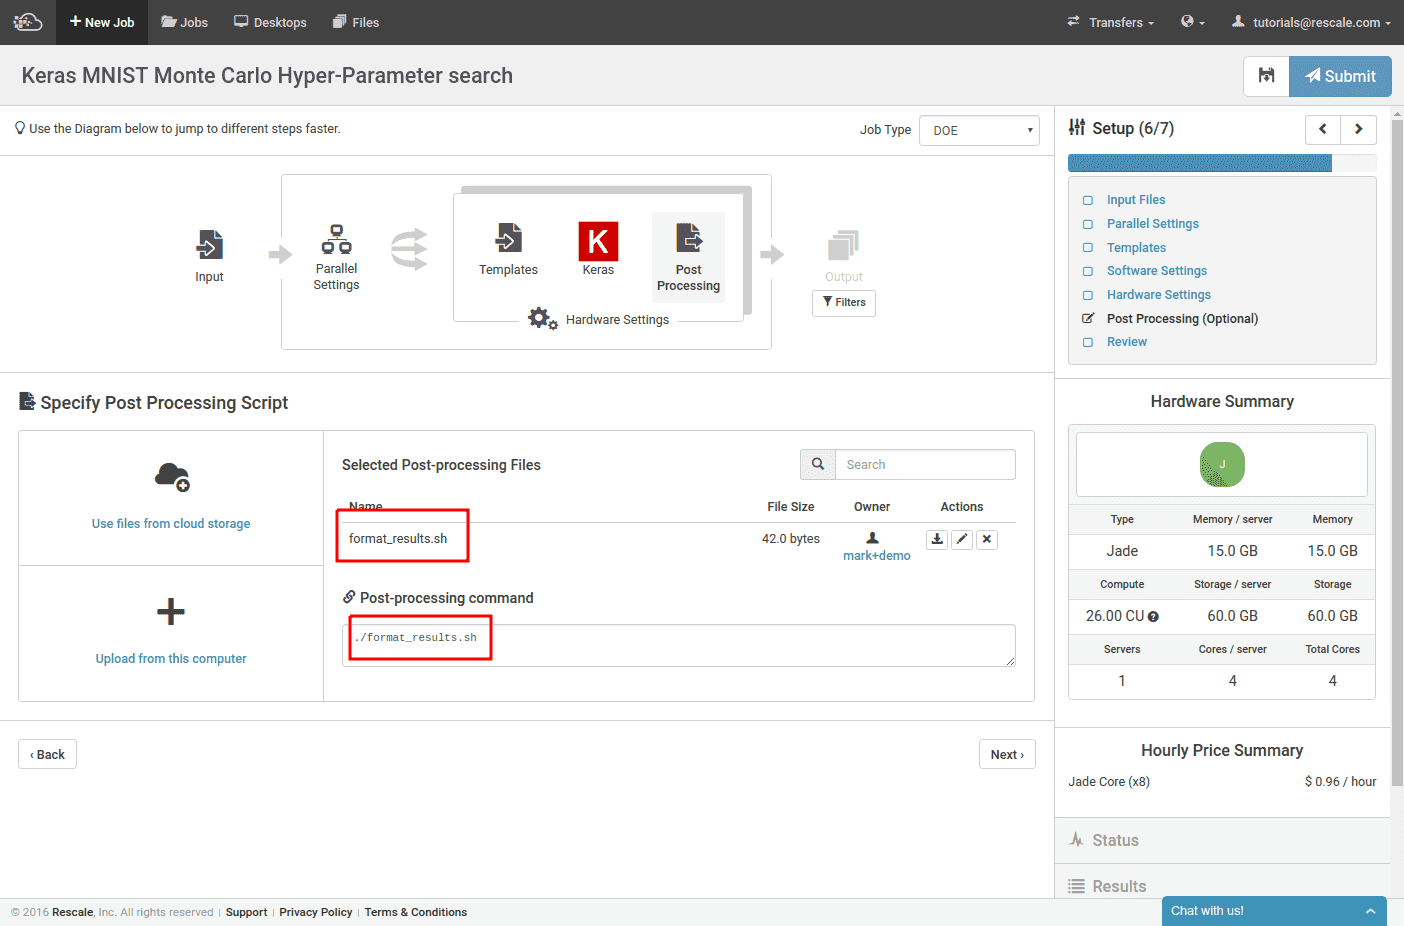
Der letzte Schritt besteht darin, das Nachbearbeitungsskript anzugeben. Dieses Skript analysiert die Ausgabe unserer Trainingsjobs und stellt Rescale alle Metriken zur Verfügung, die auf der Ergebnisseite angezeigt werden, die wir später sehen werden. Das erwartete Ausgabeformat ist eine Zeile für jeden Wert:
[Name]\t[Wert]
Da das Trainingsskript die korrekt formatierte Genauigkeit bereits als letzte Zeile seiner Ausgabe druckt, Ergebnis.out, unser Nachbearbeitungsskript muss nur diese letzte Zeile analysieren.
Sie können den Auftrag jetzt oben rechts übermitteln und wir wechseln zur Echtzeit-Clusterstatusseite.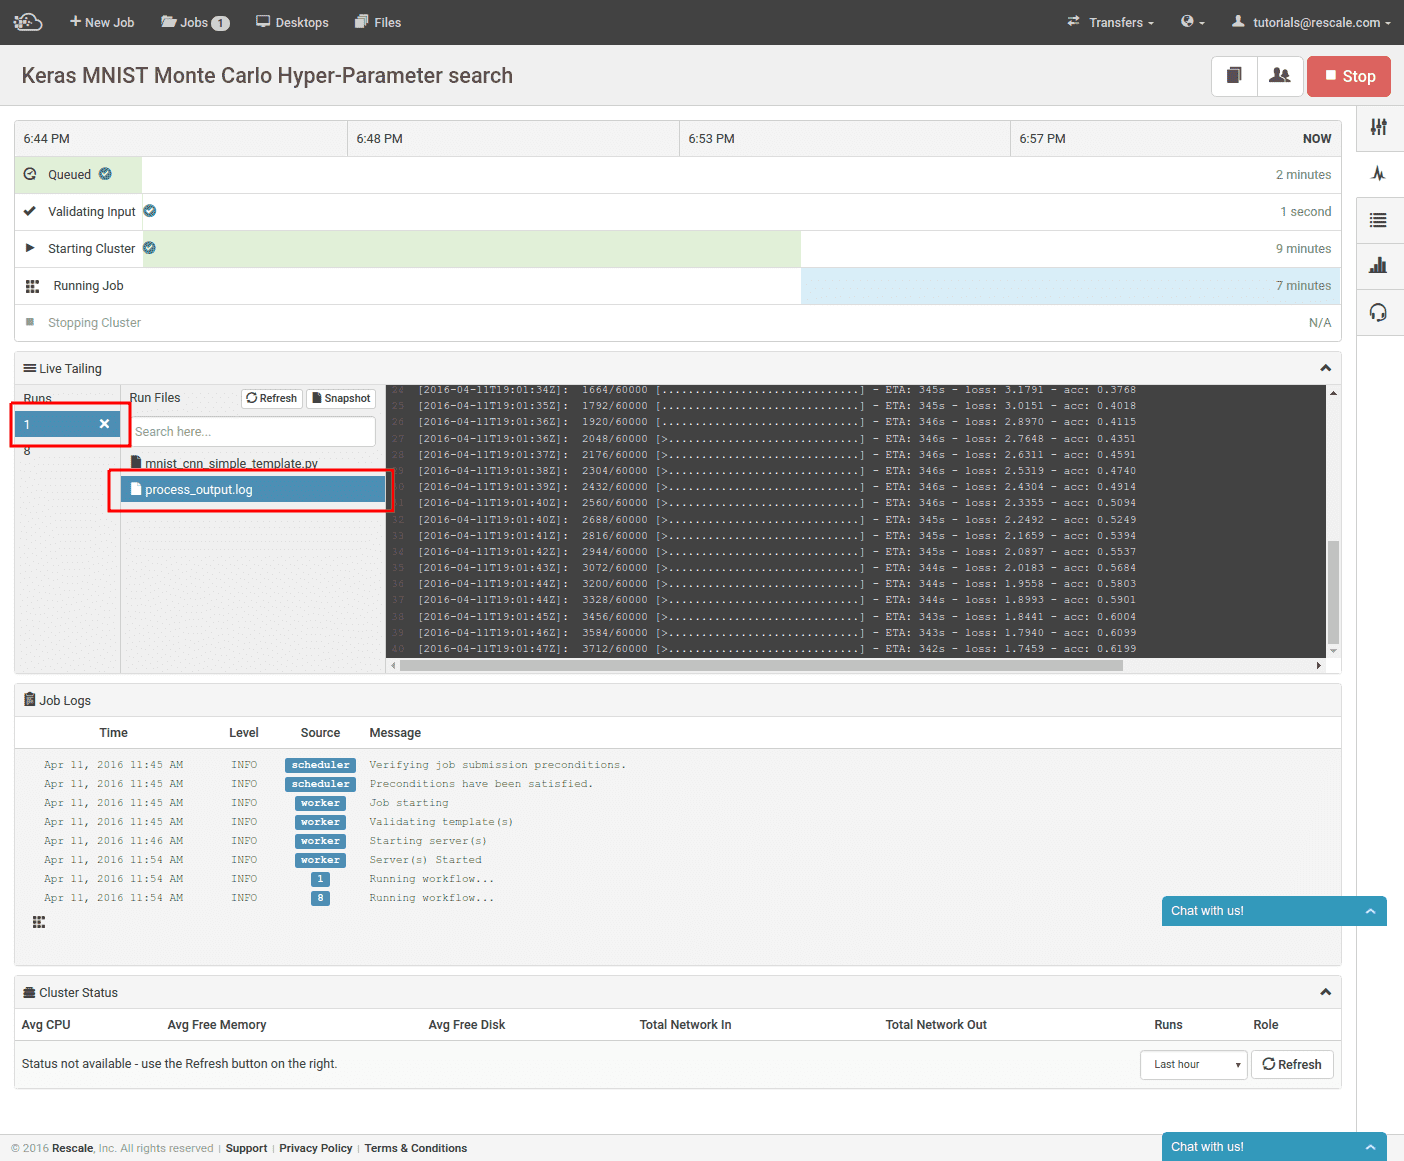
Sobald die Cluster bereitgestellt sind und der Job startet, können wir den Fortschritt unserer Trainingsjobs verfolgen. Wählen Sie im Live-Tailing-Fenster einen Lauf aus und wählen Sie process_output.log. Wenn das Training bereits begonnen hat, können Sie den Trainingsverlauf und die aktuelle Trainingsgenauigkeit einsehen. Einzelne Läufe können manuell beendet werden, indem Sie das „x“ neben der ausgewählten Laufnummer auswählen. Dies ermöglicht dem Benutzer, einen Lauf vorzeitig zu beenden, wenn die Parameter eine deutlich geringere Genauigkeit ergeben.
Nach Abschluss unseres Auftrags werden auf der Ergebnisseite die für jeden Lauf verwendeten Hyperparameter und die Genauigkeitsergebnisse zusammengefasst. Im obigen Fall hatte das ursprüngliche Modell aus den Keras-Beispielen eine Genauigkeit von 99.1 %. Das beste Ergebnis, das wir erzielt haben, liegt bei etwa 99.4 %, was eine leichte Verbesserung darstellt. Wenn wir die Gewichte für das genaueste Modell herunterladen möchten, können wir nach Genauigkeit sortieren und dann die Laufdetails auswählen.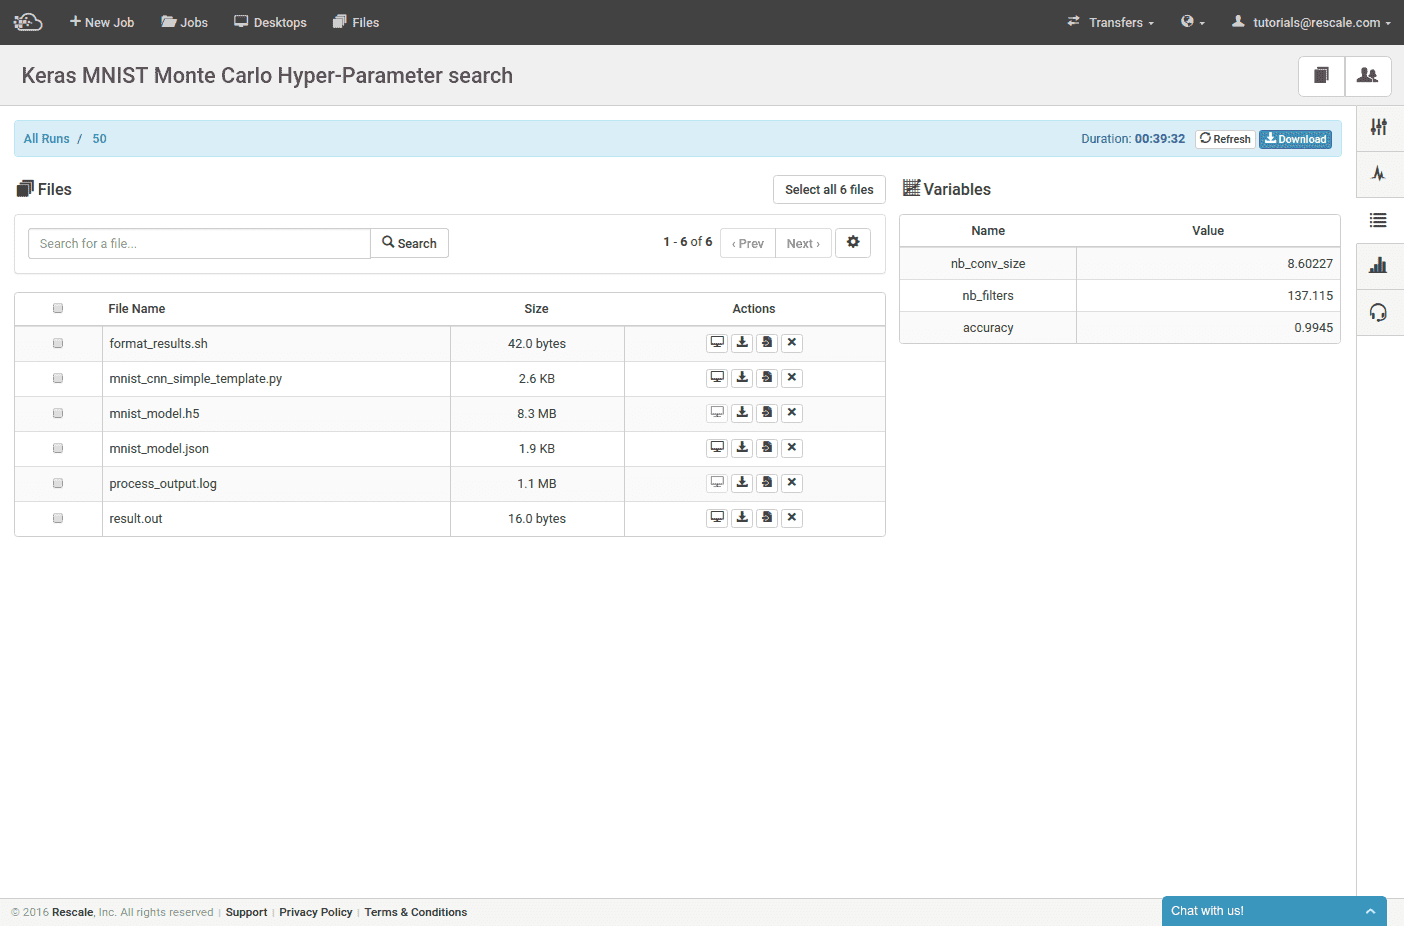
Unter anderen Ergebnisdateien ist mnist_model.json und mnist_model.h5, die die Modellarchitektur- und Modellgewichtsdateien sind, die zum erneuten Laden des Modells in Keras benötigt werden. Wir können auch alle Daten aller Läufe als ein großes Archiv herunterladen oder die Ergebnistabelle als CSV herunterladen.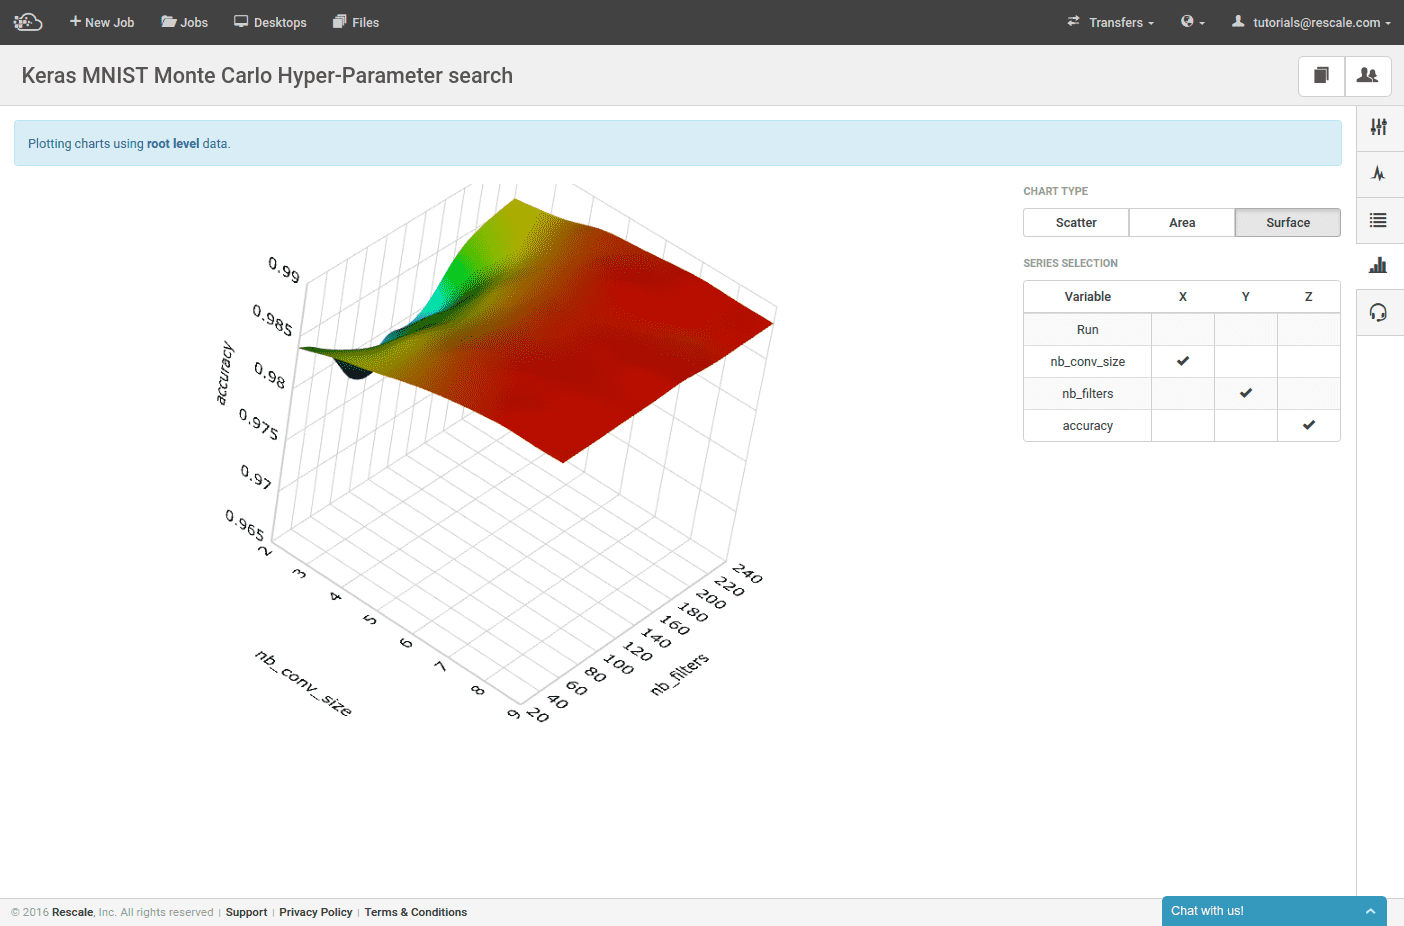
Unsere Genauigkeitsergebnisse können auch auf der Registerkarte „Diagramme“ visualisiert werden.
Bringen Sie Ihren eigenen Hyperparameter-Optimierer mit
Rescale unterstützt die Verwendung von Optimierungssoftware von Drittanbietern wie beschrieben werden auf dieser Seite erläutert. Wir werden nun die Erstellung eines Rescale-Optimierungsjobs zum Ausführen eines Black-Box-Optimierers aus der Literatur zum maschinellen Lernen besprechen.
Mit dem Rescale-Optimierungs-SDK haben wir uns entschieden, das Optimierer für die sequentielle modellbasierte Algorithmuskonfiguration (SMAC) von der University of British Columbia. Der SMAC-Optimierer erstellt ein Random-Forest-Modell der Leistung unseres neuronalen Netzwerks, basierend auf den ausgewählten Hyperparametern. Wir verwenden Version 2.10.03, verfügbar werden auf dieser Seite erläutert.
Der Optimierer ist eine Java-Anwendung, die die folgende Konfiguration annimmt:
- „Szenario“-Datei: Gibt die Befehlszeile für den auszuführenden Optimierer an, in diesem Fall ist dies unser Netzwerk-Trainingsskript
- Parameterdatei: Gibt die Namen unserer Hyperparameter und Wertebereiche an
Wenn SMAC das Trainingsskript ausführt, übergibt es die aktuellen Hyperparameter-Auswahlen zur Auswertung als Befehlszeilenflags. Es erwartet, die Ergebnisse des Laufs in stdout zu erhalten, formatiert als Zeichenfolge wie folgt:
Ergebnis dieses Algorithmuslaufs: , , , , ,
Zu Beginn erstellen wir eine Parameterdatei für die Hyperparameter, die wir in diesem Experiment variieren werden:
nb_filters integer [4, 256] [32] nb_conv integer [1, 20] [3] nb_pool integer [1, 20] [2] dropout1 real [0, 1] [0.25] dropout2 real [0, 1] [0.5]
Jetzt variieren wir zusätzlich zur Variation der Anzahl der Faltungsfilter und der Größe des Faltungskernels auch die Dropout-Anteile und die Größe der Pooling-Schicht.
Nun sehen wir uns die Änderungen an unserem vorherigen Trainingsskript an, um SMAC-Eingaben und -Ergebnisse zu berücksichtigen:
Parser = argparse.ArgumentParser() Parser.add_argument('-nb_filters', Ziel='nb_filters', Typ=int) Parser.add_argument('-nb_pool', Ziel='nb_pool', Typ=int) Parser.add_argument('-nb_conv', Ziel='nb_conv', Typ=int) Parser.add_argument('-dropout1', Ziel='dropout1', Typ=float) Parser.add_argument('-dropout2', Ziel='dropout2', Typ=float) Parser.add_argument('andere', nargs='+')
Anstatt Hyperparameterwerte als Vorlage einzufügen, verwenden wir jetzt einfach argparse, um die von SMAC bereitgestellten Flags zu analysieren.
(X_train_orig, y_train_orig), (X_test, y_test) = mnist.load_data() X_train = X_train_orig[:50000] y_train = y_train_orig[:50000] X_val = X_train_orig[50000:] y_val = y_train_orig[50000:]
Da wir Fehler in einen Optimierer einspeisen, der dann basierend auf diesem Fehler neue Parameter auswählt, führen wir nun separate Validierungs- und Testdatensätze. Oben teilen wir die ursprünglichen Trainingsdaten in einen Trainings- und einen Validierungssatz auf. Es ist wichtig, einen separaten Testdatensatz bereitzuhalten, damit wir eine Fehlermetrik zur Auswertung haben, die nicht Gefahr läuft, vom Optimierer überangepasst zu werden. Der Optimierungsalgorithmus sieht nur den Validierungsfehler.
model.fit(X_train, Y_train, batch_size=batch_size, nb_epoch=nb_epoch, show_accuracy=True, verbose=1, validation_data=(X_val, Y_val)) val_score = model.evaluate(X_val, Y_val, show_accuracy=True, verbose=0) test_score = model.evaluate(X_test, Y_test, show_accuracy=True, verbose=0) außer Ausnahme als e: print(e) print('Fehler beim Ausführen des Trainings') satisfiable = False schließlich: json = model.to_json() open('mnist_model.json', 'w').write(json) model.save_weights('mnist_model.h5') print('Testfehler:', 1 - test_score[1]) print('Val-Fehler:', 1 - val_score[1]) print('Ergebnis des Algorithmuslaufs: {0}, {1}, {2}, {3}, {4},'.format( 'SAT' falls erfüllbar, sonst 'UNSAT', time.time() - t0, 1, 1 - val_score[1], 1337 ))
Hier trainieren wir das Modell, evaluieren es anhand der Validierungs- und Testdatensätze und geben die Ergebnisse anschließend im SMAC-spezifischen Format („Ergebnis des Algorithmus…“) aus. Beachten Sie, dass wir auch alle Fehler beim Training und bei der Validierung abfangen und diesen Lauf für SMAC als „UNSAT“ kennzeichnen, damit SMAC erkennt, dass es sich um eine ungültige Parameterkombination handelt.
Damit SMAC das Rescale Python SDK aufrufen kann, schreiben wir ein Wrapper-Skript namens smac_opt.py und geben in der Szenariodatei an, dass SMAC es aufrufen soll. Der Wrapper sendet dann das auszuführende Trainingsskript.
Einige wichtige Auszüge aus dem Wrapper-Skript:
wenn __name__ == '__main__': drucke Zielfunktion(sys.argv[1:])
Zu Beginn nehmen wir alle an das Skript übergebenen Befehlszeilenflags und übergeben sie direkt an unsere Zielfunktion. Dies ist die Zielfunktion, die für jeden Satz von Hyperparametern aufgerufen wird.
def objective_function(X): iteration = os.getpid() # Geben Sie jeder Iteration ihre eigenen Dateien run_dir = 'run-{0}'.format(iteration) output_file = 'output-{0}'.format(iteration) copy_input('input', run_dir) # Lassen Sie uns packen zip_file = 'run.zip' filezip(run_dir, zip_file) # Es ist nicht nötig, das Verzeichnis auf dem Optimiererknoten beizubehalten shutil.rmtree(run_dir)
Um die Zielfunktion zu starten, packen wir die Eingabedateien für diesen Trainingslauf in eine ZIP-Datei.
BEFEHL = 'python mnist_cnn_smac.py {0} | python format_results.py > {1}' Befehl = concatenate_shell_commands( 'unzip ' + zip_file, 'rm ' + zip_file, 'cd ' + run_dir, BEFEHL.format(' '.join(X), '../' + output_file), 'cd ..' ) ausführen = rescale.submit( Befehl, input_files=[zip_file], output_files=[output_file], var_values=get_val_dict(X) ) ausführen.warten()
Hier formatieren wir den Befehl des Trainingsskripts, den wir ausführen werden. Beachten Sie, dass wir lediglich die Flags von SMAC (Variable „X“) an das Trainingsskript weitergeben. Anschließend rufen wir den Befehl „Submit“ auf, der die Eingabedateien an den Trainingscluster sendet und das Training startet. Außerdem rufen wir nun das Skript „format_results“ selbst auf.
# Holen Sie sich den Zielfunktionswert aus der Ausgabe und speichern Sie ihn in „Neu skalieren“ für Zeile in „open(output_file): if re.match('Ergebnis von .*Algorithmus ausgeführt.*', Zeile): Ergebnisse = Zeile m = re.match('Testfehler: ([\de\.-]+).*', Zeile) if m: testerr = float(m.group(1)) Qualität = Ergebnisse.split(', ')[3] run.report({'testerr': float(testerr), 'valerr': float(Qualität)}) Ergebnisse zurückgeben
Wir analysieren die Ausgabedatei des Trainingsskripts, um die erwartete SMAC-Ergebniszeile („Ergebnis des ausgeführten Algorithmus …“) sowie den Fehler im Testdatensatz zu erhalten.
Schließlich müssen wir die Szenariodatei angeben, die SMAC anweist, unser Wrapper-Skript aufzurufen.
use-instances = false runObj = QUALITÄT numberOfRunsLimit = 100 pcs-file = params.pcs algo = ./smac_opt.py check-sat-consistency = false check-sat-consistency-exception = false
Die wichtigen Teile hier sind:
- pcs-file: gibt die Parameter an
- algo: auszuführendes Wrapper-Skript
- numberOfRunsLimit: legt die Anzahl der Trainingsläufe fest
- check-sat-consistency: teilt dem Optimierer mit, dass für denselben Trainingsdatensatz unterschiedliche Parameterauswahlen zu einem realisierbaren oder nicht realisierbaren Modell führen können
- Da wir nun alle unsere Eingabedateien haben, können wir einen Job erstellen.
Sie können den Job klonen, um ihn hier selbst auszuführen:
Keras MNIST SMAC-Optimierer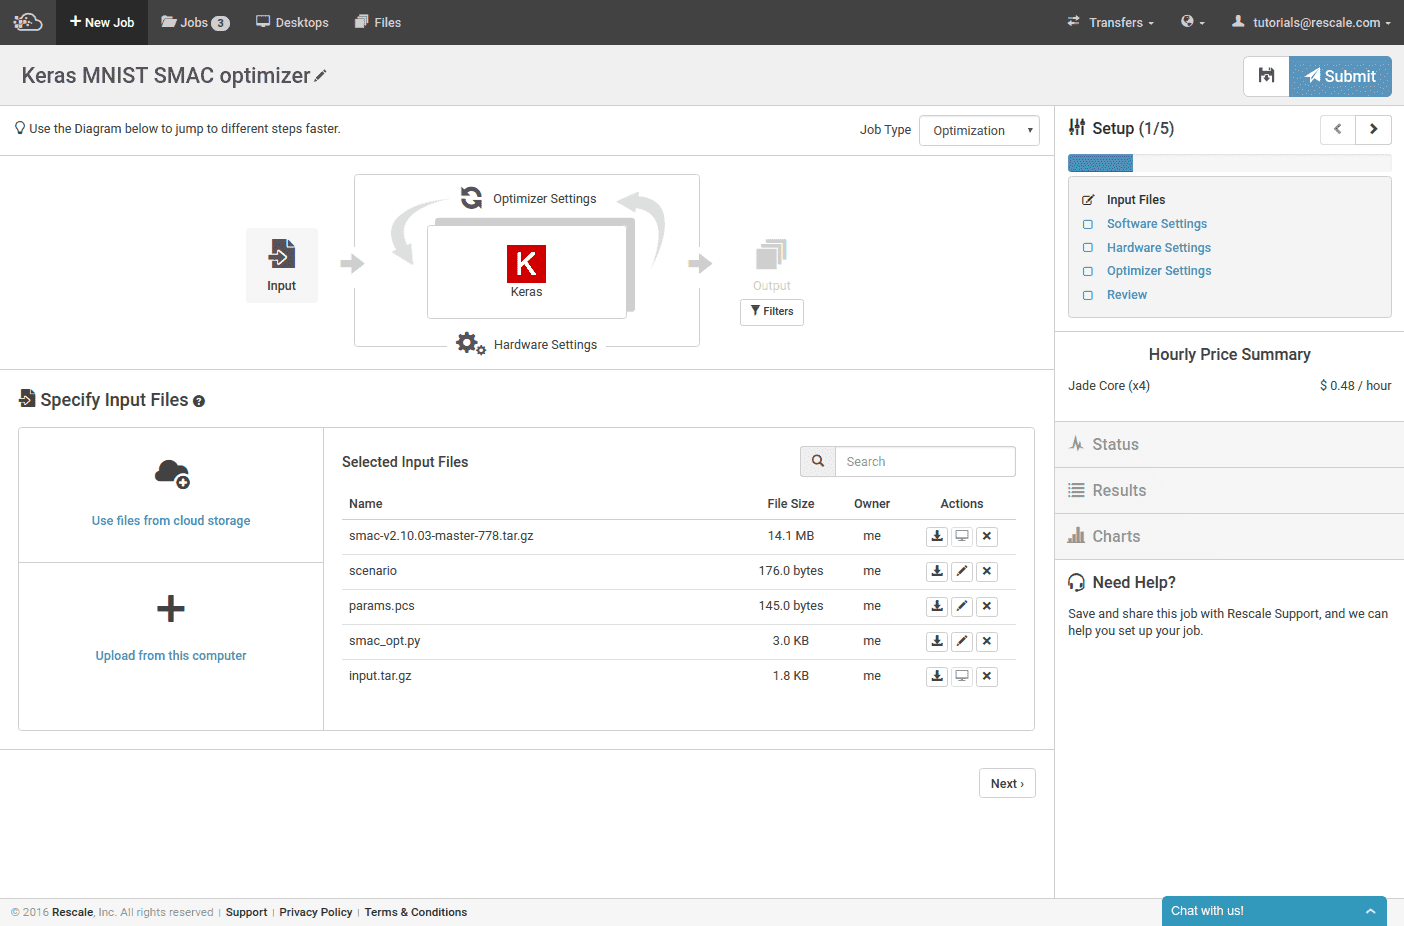
Das Archiv input.tar.gz besteht aus einem Verzeichnis input/ mit unserem Trainingsskript mnist_cnn_smac.py und dem Nachbearbeitungsskript format_results.py.
Wir wählen dieselbe Software wie zuvor, Keras, konfiguriert für Theano auf einem K520.
Auch die Hardwareauswahl ist in etwa gleich. Wir wählen wieder 2 Task-Slots aus, um 2 Netzwerke parallel zu trainieren.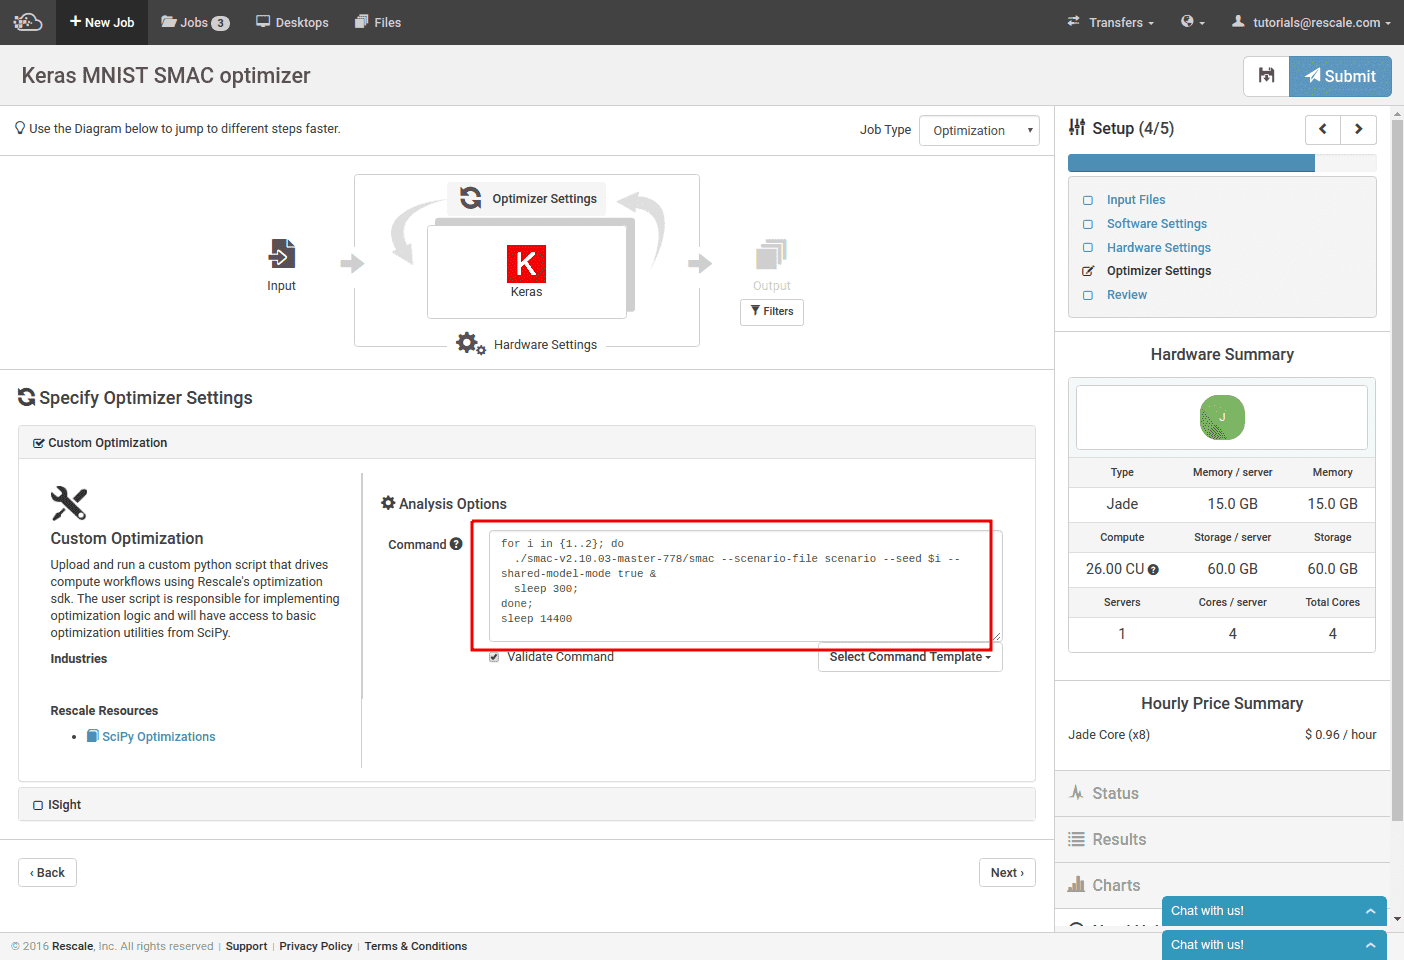
Für den Optimierer wählen wir „Benutzerdefinierte Optimierung“ und geben dann die Befehlszeile zum Ausführen von SMAC ein. Dieser Befehl wird dadurch erschwert, dass jeder SMAC-Prozess jeweils nur eine Iteration ausführt. Um mehrere Trainings parallel auszuführen, müssen wir den „Shared Model Mode“ von SMAC verwenden. Durch Aktivieren dieses Modus überprüft SMAC regelmäßig sein aktuelles Verzeichnis auf Optimierungsergebnisse anderer SMAC-Prozesse und integriert diese Ergebnisse. In diesem Modus müssen wir den „-seed“ für jeden SMAC-Prozess auf einen anderen Wert setzen.
Da wir mehrere Optimierungsprozesse gleichzeitig ausführen müssen, führen wir alle Aufrufe im Hintergrund aus und schlafen dann für die maximale Zeit, die wir diesen Optimierer ausführen möchten. In diesem Fall warten wir 4 Stunden.
Dieser Job ist nun bereit zur Übermittlung. Nach der Ausführung können Sie aktuelle Iterationen live verfolgen und am Ende die Ergebnisse wie im vorherigen randomisierten Fall anzeigen. Die Ergebnisse zeigen nun sowohl die Validierungs- als auch die Testfehler für jeden Satz von Hyperparametern.
Fazit
In diesem Artikel haben wir zwei Möglichkeiten gezeigt, den Hyperparameterraum für ein neuronales Netzwerk zu durchsuchen. Eine verwendete eine randomisierte Suche und die andere ein anspruchsvolleres Optimierungstool unter Verwendung des Rescale-Optimierungs-SDK.