
Nutzung spezialisierter Architekturen mit domänenspezifischen Hardwarebeschleunigern: Nvidia-GPUs und Arm-Chips auf Rescale

In der technischen und wissenschaftlichen Forschung steigt die Nachfrage nach High-Performance-Computing-Lösungen (HPC) kontinuierlich. Von komplexen Simulationen bis hin zu fortschrittlichen Modellen des maschinellen Lernens – die Rechenleistung moderner technischer und wissenschaftlicher Anwendungen ist immens. Um diesen Anforderungen gerecht zu werden, werden domänenspezifische Hardwarebeschleuniger benötigt, insbesondere Nvidia-GPUs und Arm chipssind von unschätzbarem Wert geworden. Zusammen mit der skalierbaren und flexiblen Infrastruktur von Cloud-Plattformen wie Rescale können diese spezialisierten Architekturen dramatisch verbessern Recheneffizienz und Leistung. Lassen Sie uns genauer betrachten, wie Ingenieure und Wissenschaftler können Nvidia-GPUs und Arm-Chips auf Rescale nutzen, um ihre schwierigsten Rechenprobleme zu lösen.
Spezialisierte Architekturen steigern die Leistung
Domänenspezifische Hardwarebeschleuniger optimieren die Leistung bestimmter Berechnungsarten. Im Gegensatz zu Standard-CPUs bieten diese Beschleuniger maßgeschneiderte Lösungen, die bestimmte Aufgaben effizienter bewältigen können. Damit eignen sie sich ideal für die komplexen und datenintensiven Workloads, die in der Ingenieur- und Wissenschaftsforschung üblich sind.

Die Leistungsentwicklung von Computerarchitekturen von 1980 bis heute verdeutlicht die Unterschiede zwischen homogenen und heterogenen Architekturen. Single-Thread-CPU-Architekturen steigerten ihre Leistung während der Ära des Mooreschen Gesetzes zunächst um das 1.5-Fache pro Jahr, verlangsamten sich jedoch um 1.1 auf das 2005-Fache pro Jahr. Im Gegensatz dazu verzeichnen spezialisierte Computerarchitekturen (z. B. GPUs, FPGAs, TPUs, ASICs, Quantum) seit ihrer Einführung eine Leistungssteigerung von zwei Mal pro Jahr, was einem prognostizierten 2-fachen Wachstum über ein Jahrzehnt entspricht [1000]. Die obige Grafik verdeutlicht den Wechsel von homogenen zu heterogenen Spezialarchitekturen, die erhebliche Leistungssteigerungen ermöglichen.
Lassen Sie uns zwei verschiedene Architekturen und ihre Anwendbarkeit auf rechenintensive Arbeitsabläufe untersuchen.
Nvidia-GPUs: Die Leistung der Parallelverarbeitung entfesseln
Nvidia-GPUs haben die Landschaft des wissenschaftlichen Rechnens mit ihren unübertroffenen Parallelverarbeitungsfähigkeiten revolutioniert. Ursprünglich für die Grafikdarstellung entwickelt, haben GPUs ihre außergewöhnliche Leistungsfähigkeit bei der Bewältigung rechenintensiver Aufgaben unter Beweis gestellt, insbesondere in den Bereichen Fluiddynamik, Molekulardynamik und … KI-Physik.
Hauptmerkmale von Nvidia-GPUs:
- Massive Parallelität: Nvidia-GPUs verfügen über Tausende von Kernen, die gleichzeitig Berechnungen durchführen können, was sie ideal für parallelisierbare Aufgaben wie Matrixmultiplikationen in neuronalen Netzwerken oder Partikelinteraktionen in molekularen Simulationen macht.
- CUDA-Programmiermodell: Nvidias CUDA (Compute Unified Device Architecture)-Framework ermöglicht Entwicklern von Ingenieur- und Forschungssoftware, Code zu schreiben, der die volle parallele Verarbeitungsleistung von GPUs ausnutzt. CUDA hat sich zum Standard im wissenschaftlichen Rechnen für die GPU-Programmierung entwickelt.
- Tensorkerne: Eingeführt in Nvidias Volta und anschließend ArchitekturenTensor Cores sind spezialisierte Einheiten, die Deep-Learning-Operationen beschleunigen. Sie bieten erhebliche Leistungssteigerungen beim Training und bei der Inferenz von Neuronale Netze.
Arm-Chips: Effizienz und Vielseitigkeit für vielfältige Anwendungen
Arm-Prozessoren sind für ihre Energieeffizienz und Vielseitigkeit bekannt, die sie in einer Vielzahl von Geräten beliebt gemacht haben, vom Mobiltelefon bis zum Supercomputer. In wissenschaftliche und technische Für Anwendungen bieten Arm-Chips ein ausgewogenes Verhältnis zwischen Leistung und Energieeffizienz, das insbesondere für groß angelegte Simulationen und Datenanalysen von Vorteil ist.
Hauptmerkmale von Arm Chips:
- Energieeffizienz: Die Architektur von Arm ist auf maximale Leistung pro Watt ausgelegt und macht sie zu einem wichtigen Konkurrenten für Green Computing. Sie eignet sich für stromsparende Anwendungen und groß angelegte Implementierungen, bei denen die Energiekosten eine wichtige Rolle spielen, wie die Verwendung von LPDDR (Low Power DDR) für den Speicher der Grace-CPUs von NVIDIA Grace zeigt.
- Skalierbarkeit: Arm-Prozessoren lassen sich von stromsparenden Embedded-Systemen bis hin zu Hochleistungs-Rechenclustern skalieren und bieten so Flexibilität für verschiedene Anwendungsfälle. Leistungsmäßig erreichen Arm-Prozessoren die Leistung von x86-Prozessoren und/oder übertreffen diese sogar – was für lizenzgebundene Simulationstools attraktiv ist.
- Kosten-Leistung: Arm-Chips sind im Vergleich zu anderen Prozessoren oft kostengünstiger, da führende Hyperscaler ihre eigenen Arm-CPUs bauen. Dies ermöglicht ihren Nutzern eine höhere Recheneffizienz und sorgt für ein günstiges Preis-Leistungs-Verhältnis, was insbesondere für Forschungsprojekte und groß angelegte Implementierungen von Vorteil ist.
Rescale: Eine Plattform, die auf Hochleistungsrechnen zugeschnitten ist
Neu skalieren ist eine Cloud-Plattform, die skalierbare HPC-Ressourcen bereitstellt und es Forschern und Ingenieuren ermöglicht, komplexe Simulationen und Datenverarbeitungsaufgaben auf einer Vielzahl von Hardwarearchitekturen auszuführen, darunter Nvidia-GPUs und Arm-Prozessoren.
Hauptvorteile der Verwendung von Rescale:
- Skalierbarkeit: Rescale bietet Zugriff auf praktisch unbegrenzte Rechenressourcen, sodass Benutzer ihre Arbeitslasten je nach Bedarf dynamisch skalieren können.
- Diverse Hardwareoptionen: Benutzer können aus einer breiten Palette von Hardwarekonfigurationen auswählen, darunter die neuesten Nvidia-GPUs und Arm-Chips, um ihren spezifischen Rechenanforderungen optimal gerecht zu werden.
- Benutzerfreundlich: Die Plattform bietet eine intuitive Benutzeroberfläche zum Verwalten und Bereitstellen von Workloads sowie robuste Unterstützung für eine Vielzahl wissenschaftlicher und technischer Anwendungen.
- Flexibilität: Durch die Nutzung Cloud-basierter Ressourcen können Forscher die Kosten optimieren, indem sie nur für die Rechenressourcen zahlen, die sie tatsächlich nutzen, und so erhebliche Vorabinvestitionen in die Hardware vermeiden.
Optimierung der technischen und wissenschaftlichen Arbeitslasten bei Rescale
Beim traditionellen HPC verwendet ein homogenes Setup statische Ressourcen, wobei ein Scheduler die Auftragsreihenfolge bestimmt. Dies führt zu verzögerten Erkenntnissen und längeren Auftragsdauern. Umfangreiche Jobs mit Ansys Fluent, Siemens CCM+ und LS-Dyna müssen auf geeignete Ressourcen warten. Im Gegensatz dazu nutzt Rescale Optimised Cloud HPC einen heterogenen Ansatz mit spezialisierter Hardware, sodass Jobs sofort und effizient ausgeführt werden können. Dieses Setup nutzt spezifische, auf die Anforderungen jedes Jobs zugeschnittene Architekturen und beschleunigt so Erkenntnisse, verbessert die Leistung und optimiert die Auftragskosten.
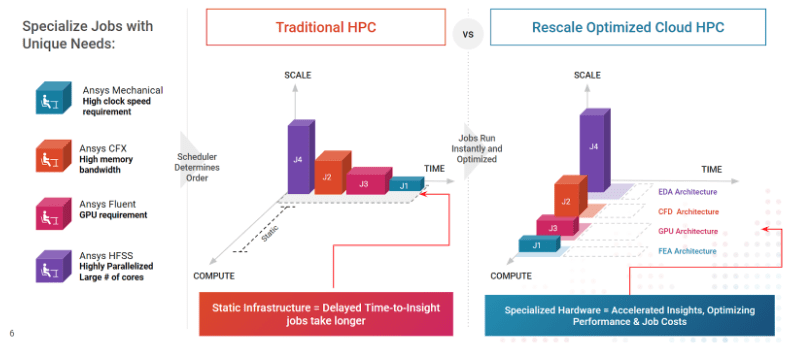
Um die Leistungsfähigkeit von Nvidia-GPUs und Arm-Chips auf Rescale voll auszuschöpfen, ist es entscheidend, Workloads effektiv zu konfigurieren und zu optimieren. So erzielen Sie optimale Leistung für technische und wissenschaftliche Anwendungen
Optimieren von Workloads für Nvidia-GPUs
Beim Bereitstellen von Anwendungen auf Nvidia-GPUs können verschiedene Best Practices zur Leistungsmaximierung beitragen:
- Parallelisieren Sie Ihren Code: Identifizieren Sie Teile Ihres Codes, die parallelisiert werden können. Verwenden Sie CUDA oder andere Frameworks für parallele Programmierung, um diese Aufgaben auf die GPU auszulagern.
- Tensorkerne nutzen: Stellen Sie bei Deep-Learning-Aufgaben sicher, dass Ihre Modelle für die Nutzung von Tensor Cores optimiert sind. Dies kann Trainings- und Inferenzprozesse erheblich beschleunigen.
- Profilieren und optimieren: Nutzen Sie Optimierungstools wie die Performance-Profile und die Recommendation Engine von Rescale, um die Leistung Ihres Jobs zu analysieren und Engpässe zu identifizieren. Optimieren Sie Ihren Workflow auf Basis dieser Erkenntnisse.
- Nutzen Sie vorab trainierte Modelle: Erwägen Sie für Anwendungen des maschinellen Lernens die Verwendung vortrainierter Modelle, die über Nvidias NGC (verfügbar auf Rescale) verfügbar sind. Diese sind für Nvidia-GPUs optimiert und können die Entwicklung beschleunigen.
Optimierung der Arbeitslasten für Arm-Chips
Berücksichtigen Sie bei der Verwendung von Arm-Prozessoren auf Rescale die folgenden Strategien:
- Optimierung für Energieeffizienz: Gestalten Sie Ihren Workflow so, dass Sie die Energieeffizienz von Arm nutzen, die insbesondere bei lang laufenden Simulationen und der Verarbeitung umfangreicher Daten von Vorteil ist.
- Verwenden Sie Arm-optimierte Bibliotheken: Verwenden Sie Bibliotheken und Frameworks, die speziell für die Arm-Architektur optimiert sind, z. B. Arm Performance Libraries, die hochoptimierte BLAS-, LAPACK- und FFTW-Implementierungen enthalten.
- Nutzen Sie Multithreading: Arm-Prozessoren verfügen häufig über mehrere Kerne. Stellen Sie sicher, dass Ihre Anwendungen Multithreading nutzen, um den Rechendurchsatz zu maximieren. Viele auf Rescale verfügbare Anwendungen sind bereits dafür geeignet.
- Profil und Feinabstimmung: Nutzen Sie Tools zur Leistungsprofilierung wie das Leistungsprofil von Rescale, um Leistungsengpässe zu identifizieren und zu beheben und die Kosten in Ihrem Arbeitsablauf zu optimieren.
Anwendungsfall: Beschleunigung der numerischen Strömungsmechanik mit Nvidia-GPUs auf Rescale
Diese Fallstudie untersucht die praktischen Vorteile der Nutzung von Nvidia-GPUs auf Rescale zur drastischen Beschleunigung Ihrer CFD-Workloads (Computational Fluid Dynamics). Erfahren Sie, wie diese leistungsstarke Kombination erhebliche Zeiteinsparungen und Effizienzsteigerungen ermöglicht.
Problem Statement
Ein F1-Ingenieurteam entwickelt ein CFD-Modell zur Simulation des Luftstroms über die gesamte Geometrie eines Rennwagens. Das Modell erfordert die Lösung umfangreicher Gleichungssysteme, was rechenintensiv ist und auf Standard-CPUs sehr lange dauern würde.
Lösung
Das Team nutzt Nvidia-GPUs für Rescale, um den Simulationsprozess zu beschleunigen. So wurde das erreicht:
- Datenaufbereitung: Das Team verarbeitet die Geometrie- und Netzdaten vor und lädt sie dann in den Cloud-Speicher von Rescale hoch.
- Hardware-Auswahl: Sie wählen einen Rescale-Coretyp, der mit Nvidia A100-GPUs ausgestattet ist, die für ihre hohe Leistung bei parallelen Rechenaufgaben bekannt sind.
- Simulationsausführung: Das Team wählt einen CFD-Solver-Code aus, der CUDA für die parallele Verarbeitung nutzt. Der ANSYS Fluent-Solver ist so konfiguriert, dass er die Fähigkeiten der GPU optimal nutzt.
- Optimierung und Skalierung: Mit den Performance Profile-Tools von Rescale identifizieren sie Leistungsengpässe und optimieren den Workflow. Zusätzlich skalieren sie die Simulation über mehrere GPUs, um die Rechenzeit weiter zu reduzieren und eine kosteneffiziente Lösung zu schaffen.
Ergebnisse
Durch den Einsatz von Nvidia-GPUs in Rescale reduzierte das Team die Simulationszeit von mehreren Tagen auf wenige Stunden und ermöglichte so schnellere Iterationen und tiefergehende Analysen. Diese Beschleunigung ermöglicht es dem Team, mehr Designvarianten zu untersuchen und die Gesamteffizienz seiner Simulationen zu verbessern. Die folgende Grafik zeigt, dass es eine nahezu 8X Leistungssteigerung beim Wechsel von herkömmlichen CPU-Workflows zu Nvidia-GPUs.

Zukünftige Trends und Überlegungen zu HPC in Ingenieurwesen und Wissenschaft
Da sich der Bereich HPC ständig weiterentwickelt, werden mehrere Trends und Überlegungen die Zukunft der Computertechnik und der wissenschaftlichen Forschung prägen:
- Entstehung neuer Architekturen: Neue Architekturen wie Quantencomputer und neuromorphe Chips werden die Möglichkeiten für domänenspezifische Beschleunigung weiter erweitern
- Integration von KI und HPC: Die Konvergenz von KI und HPC wird die Entwicklung spezialisierterer Hardwarebeschleuniger vorantreiben. Plattformen wie Rescale werden für den Zugang zu diesen hochmodernen Ressourcen von entscheidender Bedeutung sein.
- Fokus auf Nachhaltigkeit: Energieeffizienz und Nachhaltigkeit werden im HPC-Bereich immer wichtiger. Dank seiner stromsparenden Architektur ist Arm bestens für diese Anforderungen gerüstet, und kontinuierliche Innovationen werden die Energieeffizienz der Rechenressourcen weiter verbessern.
Fazit
Die Nutzung domänenspezifischer Hardwarebeschleuniger wie Nvidia-GPUs und Arm-Chips auf Plattformen wie Rescale bietet erhebliche Vorteile für technische und wissenschaftliche Berechnungen. Durch die Optimierung der Workloads für diese spezialisierten Architekturen können Forscher und Ingenieure ein beispielloses Leistungs- und Effizienzniveau erreichen und so komplexere Probleme bewältigen und Innovationen beschleunigen. Mit dem technologischen Fortschritt wird der nahtlose Zugriff auf diese leistungsstarken Rechenressourcen und ihre Nutzung zu einem entscheidenden Erfolgsfaktor für wissenschaftliche und technische Vorhaben.
Referenzen
NVIDIA beachtet Huangs Gesetz: Video zeigt, wie Ingenieure die Geschwindigkeit weiter steigern https://blogs.nvidia.com/blog/huangs-law-dally-hot-chips/
Möchten Sie mehr über die Nutzung spezialisierter Architekturen erfahren?
Vereinbaren Sie eine Demo mit einem unserer Experten
