
Einer der Hauptkritikpunkte an HPC in der Cloud ist die relativ langsame Verbindungsgeschwindigkeit zwischen Knoten im Vergleich zu lokalen Clustern. Während einige Nischenanbieter InfiniBand-Konnektivität anbieten, um diese Lücke zu schließen, ist Microsoft der erste große Anbieter, der diese Art von Verbindung mit hoher Bandbreite und geringer Latenz mit seinem neuen Große Rechenleistung Lösung. Das sind tolle Neuigkeiten, denn es gibt relativ wenige Unternehmen, die über die notwendigen Ressourcen verfügen, um Rechenzentren in großem Maßstab zu verwalten und gleichzeitig die Sicherheits-Compliance-Probleme und Zertifizierungen zu bewältigen, die Unternehmen benötigen, um ihre Workloads in die Cloud zu verlagern. Ob fair oder nicht, die Unterstützung von Microsoft, Amazon oder Google kann einen großen Unterschied machen, wenn es darum geht, die Zustimmung der Unternehmens-IT zu gewinnen.
Gemäß Spezifikation, die neuen Instance-Größen A8 und A9 bieten InfiniBand-Konnektivität mit RDMA. Dieser letzte Punkt ist besonders wichtig, da diesem Blog-Post Wie er richtig anmerkt, reicht InfiniBand allein nicht aus. Der verwendete Transport macht einen entscheidenden Unterschied, und TCP bietet eine sehr schlechte Leistung. Die Big Compute-Instanzen unterstützen virtualisiertes RDMA, das laut Microsoft eine nahezu Bare-Metal-Leistung bietet. Diese Ankündigung dürfte für Benutzer, die eng gekoppelte Simulationen in der Cloud ausführen möchten, von Vorteil sein. Diese Art von „gesprächiger“ MPI-Anwendung reagiert sehr empfindlich auf die Latenz des zugrunde liegenden Netzwerks. Nachdem ich die Plattform jedoch getestet habe, denke ich, dass es in ihrer aktuellen Version einige Markteintrittsbarrieren gibt.
Erstens werden die RDMA-Funktionen über eine Schnittstelle namens Network Direct bereitgestellt, die derzeit nur von MS-MPI – der MPI-Implementierung von Microsoft – unterstützt wird. Anwendungen müssen mit diesen Bibliotheken neu kompiliert werden. Dies ist kein allzu großes Problem, da MPI ein klar definierter Standard ist und MS-MPI auf dem weit verbreiteten MPICH basiert. Ein größeres Problem besteht jedoch darin, dass Anwendungen für die Ausführung unter Windows geschrieben werden müssen. Glücklicherweise gibt es für viele der heute gängigen Engineering-Anwendungen bereits Windows-Versionen, die MS-MPI unterstützen. Zumindest anekdotisch scheint es, als könnten Anwendungen mit geringer Aufwand.
Zweitens ist die Konfiguration eines MPI-Clusters in der Windows-Welt ganz anders als in der Linux-Welt. Während Windows sicherlich in der Lage ist, beeindruckende MPI-Benchmark Zahlen zufolge arbeitet die überwiegende Mehrheit der HPC-Anwender derzeit unter Linux. Die Konfiguration eines MPI-Clusters in der Cloud für Linux läuft im Allgemeinen auf Folgendes hinaus: „Starten Sie Ihre Instanzen, installieren Sie mit dem Paketmanager die MPI-Variante Ihrer Wahl, richten Sie passwortloses SSH zwischen allen Knoten in Ihrem Cluster ein und erstellen Sie eine Maschinendatei.“ Unter Windows empfiehlt es sich, HPC Pack auf einem Windows Server (entweder vor Ort oder in der Cloud) zu installieren und zu konfigurieren. Dies kann für jemanden, der mit Linux vertraut ist und sich nicht mit den Feinheiten der Windows-Serveradministration auskennt, schwierig sein. Obwohl die HPC Pack-Lösung robust und voll funktionsfähig ist, wirkt sie etwas schwerfällig, wenn Sie nur ein paar Benchmarks oder eine einfache einmalige Simulation durchführen möchten. Schön wäre ein Tool wie Sternenhaufen um die Benutzer so schnell wie möglich zum Laufen zu bringen, ohne Active Directory konfigurieren, SQL Server installieren oder Powershell und REST-APIs herausfinden zu müssen.
Es stellt sich heraus, dass Sie MS-MPI auf Azure installieren können, ohne HPC Pack, aber es scheint nicht viele Anleitungen dazu zu geben. Darüber hinaus gibt es eine Reihe von SSH-Servern und UNIX-Dienstprogrammen, die auf Windows portiert wurden. Wir suchten nach einer einfacheren Möglichkeit, einen MPI-Cluster unter Windows zu starten, ohne eine separate HPC Pack-Instanz installieren, konfigurieren und verwalten zu müssen. Schließlich experimentierten wir mit dem PaaS-Angebot, um einen Cloud-Dienst mit einer Reihe von Startaufgaben bereitzustellen, die auf jedem Knoten die folgenden Vorgänge ausführen:
- Installieren Sie MS-MPI (ein eigenständiges Installationsprogramm ist verfügbar werden auf dieser Seite erläutert)
- Starten Sie SMPD
- Installieren und konfigurieren Sie einen OpenSSH-Server und einen Standardsatz von UNIX-Befehlszeilenprogrammen
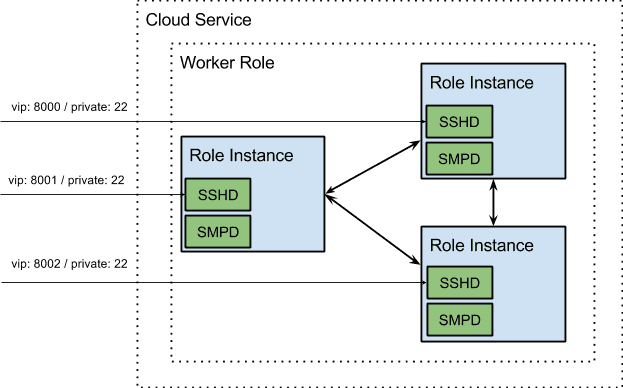
. Der Cloud Service ist eine einzelne virtuelle IP (VIP) zugewiesen. Um dies zu umgehen, haben wir interne Endpunkte der Instanz verwendet, um Benutzern den SSH-Zugriff auf einzelne Knoten über verschiedene Ports zu ermöglichen. Interne Endpunkte werden geöffnet, sodass jede Rolleninstanz eine Verbindung zum SMPD-Daemon der anderen herstellen kann. Das Endergebnis ist eine einfach zu implementierende .cspkg-Datei und die zugehörige Konfigurations-XML. Benutzer können per SSH auf Rolleninstanzen zugreifen und die ihnen bekannten und vertrauten UNIX-Befehle verwenden.
Wir wollten einige Latenz- und Bandbreiten-Benchmarks mit zwei A2-Instanzen durchführen. Zunächst haben wir die Benchmarks osu_latency und osu_bibw aus der OSU Microbenchmark-Bibliothek mit MS-MPI neu kompiliert. Anschließend haben wir den oben genannten Cloud-Dienst bereitgestellt und die Benchmark-Datei per SCP auf die einzelnen Rechner kopiert (beachten Sie, dass SCP keine praktikable Lösung ist, wenn Sie große Dateien verschieben müssen, aber für kleinere Dateien wie diese Benchmark-Dateien funktioniert es einwandfrei). Schließlich haben wir uns per SSH mit einem der Knoten verbunden und die Dateien gestartet:
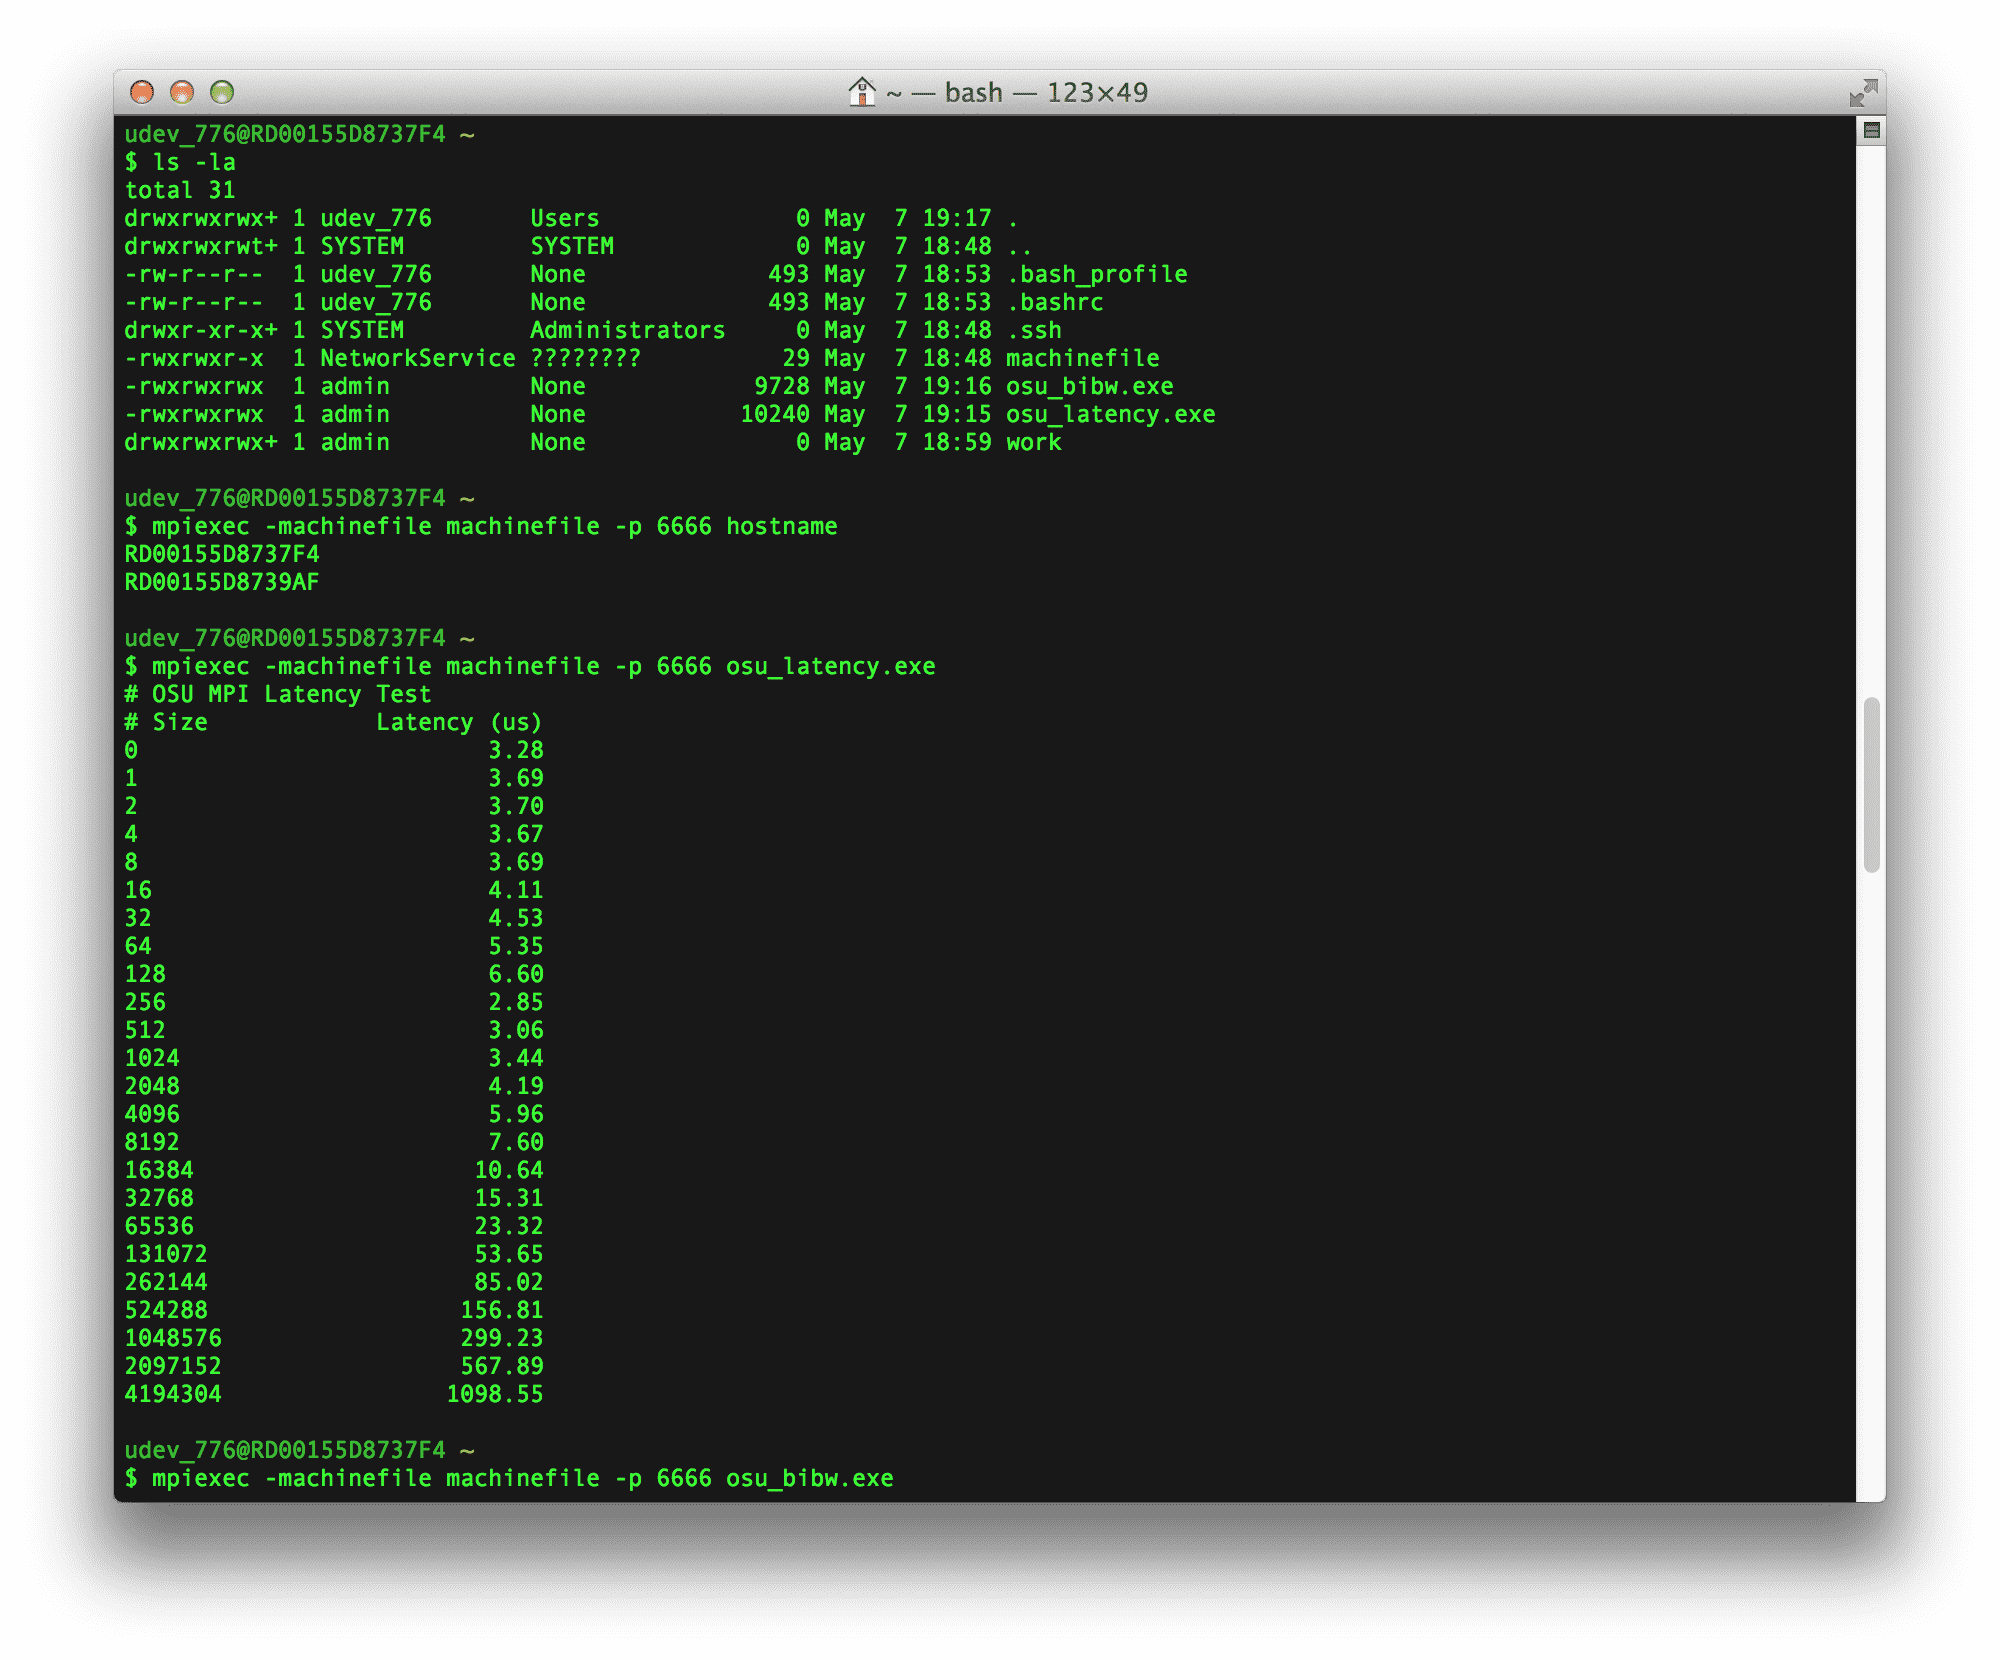
Die Ergebnisse der Benchmarks finden Sie unten. Wie Sie sehen, liegen die 0-Byte-Latenzwerte bei ca. 3 µs und im bidirektionalen Bandbreitentest für größere Nachrichtengrößen werden ca. 7.5 GB/s übertragen, was ziemlich nahe an der vollständigen Sättigung liegt.
# OSU MPI Latency Test

# Size         Latency (us)

0                      3.28

1                      3.69

2                      3.70

4                      3.67

8                      3.69

16                     4.11

32                     4.53

64                     5.35

128                    6.60

256                    2.85

512                    3.06

1024                   3.44

2048                   4.19

4096                   5.96

8192                   7.60

16384                 10.64

32768                 15.31

65536                 23.32

131072                53.65

262144                85.02

524288               156.81

1048576              299.23

2097152              567.89

4194304             1098.55

# OSU MPI Bi-Directional Bandwidth Test

# Size Bi-Bandwidth (MB/s)

1                      0.43

2                      0.87

4                      1.69

8                      3.35

16                     6.82

32                    13.69

64                    18.64

128                   29.12

256                  486.75

512                 1174.69

1024                2170.21

2048                3844.66

4096                5982.22

8192                2873.87

16384               7078.87

32768               6669.85

65536               4926.26

131072              4878.30

262144              5853.30

524288              6674.26

1048576             7066.08

2097152             7344.74

4194304             7479.30
Das sind beeindruckende Leistungswerte. Ich vermute jedoch, dass der entscheidende Wendepunkt für die Nutzung von Big Compute erreicht sein wird, sobald Microsoft mit seiner IaaS-Lösung Unterstützung für Linux-VMs hinzufügt. Aus der Online-Dokumentation geht nicht hervor, wie der Zeitplan dafür derzeit aussieht (IaaS-Unterstützung für Windows Server wurde erst kürzlich hinzugefügt). Es wird interessant sein zu sehen, wie sich der neue Wettbewerb um die niedrigste Latenzzeit im Jahr 2014 entwickelt. Rescale möchte wie immer anbieterunabhängig bleiben und seinen Kunden die beste verfügbare Hardware anbieten.
