
Eine der größten Herausforderungen bei Cloud-HPC minimiert die Menge an frustrierten die zwischen lokalen Maschinen und Maschinen in der Cloud übertragen werden müssen. Im Gegensatz zu herkömmlichen lokalen Systemen erfolgt diese Übertragung über ein viel langsameres und weniger zuverlässiges Wide Area Network. Wie bereits erwähnt vorher, ist es am besten, die Nachbearbeitung aus der Ferne durchzuführen und unnötige Datenübertragungen zu vermeiden.
Ein häufiges Szenario für viele Benutzer ist jedoch die Ausführung eines Simulation und übertragen Sie dann alle Ausgabedateien des Auftrags zurück auf ihre Workstation.
Nach Abschluss eines Auftrags wird jede Datei im Arbeitsverzeichnis verschlüsselt und in die Cloud hochgeladen HPC-SpeicherDies bietet Flexibilität für Benutzer, die nur einen kleinen Teil der Ausgabedateien auf ihren Computer herunterladen müssen. Der Nachteil besteht jedoch darin, dass jede Datei zusätzlichen Overhead bei der Übertragung verursacht. Bei der Datenübertragung über ein Netzwerk ist es umso besser, je mehr Daten in eine einzelne Datei gepackt werden können. Außerdem geben viele technische Codes stark komprimierbare Dateien aus. Obwohl das Komprimieren einer Datei zusätzliche Zeit in Anspruch nimmt, kann dies dennoch ein Nettogewinn sein, wenn die für das Komprimieren und Übertragen einer kleineren Datei benötigte Zeit kürzer ist als die für das Hochladen des größeren, unkomprimierten Archivs benötigte Zeit. Auch wenn die Komprimierung und die anschließende Übertragung insgesamt länger dauern, ist der eigentliche Engpass im gesamten Übertragungsprozess der letzte Hop zwischen dem Cloud-Speicher und der Workstation des Benutzers. Je nach Geschwindigkeit der Internetverbindung des Benutzers kann die Übertragung einer kleineren komprimierten Datei hier einen enormen Unterschied machen.
Wenn Sie im Voraus wissen, dass Sie alle Ausgabedateien für einen Auftrag herunterladen müssen, empfiehlt es sich in der Regel, zunächst eine einzelne komprimierte Archivdatei zu erstellen, anstatt jede Datei einzeln zu übertragen. Der Linux-Befehl „tar“ bietet eine einfache Möglichkeit, ein komprimiertes Archiv zu erstellen, nutzt jedoch nicht die zusätzliche Rechenleistung des MPI-Clusters zur Erstellung des Archivs.
Jeff Gilchrist hat einen benutzerfreundlichen bz2-Kompressor entwickelt, der auf MPI-Clustern läuft (https://compression.ca/mpibzip2/). Wir haben eine Linux-Binärdatei mit einer statischen bzip2-Bibliotheksreferenz kompiliert und sie verfügbar gemacht werden auf dieser Seite erläutert zum Download, um die Integration in eigene Projekte zu erleichtern. Die Binärdatei wurde mit dem OpenMPI 1.6.4 mpic++ Wrapper-Compiler erstellt. Bitte beachten Sie, dass je nach verwendeter MPI-Variante eine Neukompilierung erforderlich sein kann.
Um es zu verwenden, laden Sie die ausführbare Datei mpibzip2 als zusätzliche Eingabedatei für Ihren Job hoch. Anschließend sollten die folgenden Befehle an das Ende des Analysebefehls auf der Seite mit den Jobeinstellungen angehängt werden.
tar cf files.tar –exclude=mpibzip2 *
mpirun -np 16 mpibzip2 -v files.tar
finden ! -name 'files.tar.bz2' -type f -exec rm -f {} +
Zunächst wird eine Tar-Datei namens files.tar erstellt, die alles außer dem parallelen bzip-Dienstprogramm enthält. Anschließend starten wir die ausführbare Datei mpibzip2 und generieren ein komprimiertes Archiv namens files.tar.bz2. Abschließend werden alle Dateien außer files.tar.bz2 gelöscht. Dadurch wird verhindert, dass sowohl einzelne Dateien als auch das komprimierte Archiv in den Cloud-Speicher hochgeladen werden.
Beachten Sie, dass das Argument -np beim mpirun-Aufruf die Anzahl der Kerne im Cluster widerspiegeln sollte. Hier werden die Befehle auf einem 16-Nickel-Core-Cluster ausgeführt.
Darüber hinaus sollten Sie beachten, dass Windows standardmäßig keine BZ2- oder TAR-Dateien unterstützt. 7-Zip kann installiert werden, um Unterstützung für dieses und viele andere Formate hinzuzufügen.
Als Schnelltest haben wir komprimierte Archive aus einem OpenFOAM-Job erstellt, der 2.1 GB Ausgabedaten verteilt auf 369 Dateien enthielt, und die resultierende Datei in den Cloud-Speicher hochgeladen.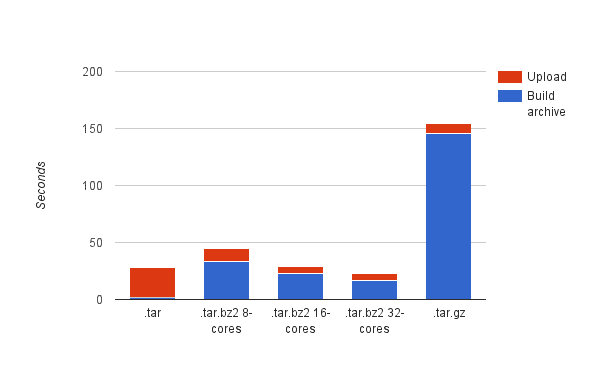
Als Basis haben wir eine unkomprimierte Tar-Datei erstellt. Wir haben außerdem versucht, eine gzip-komprimierte Tar-Datei mit dem Flag -z im Tar-Befehl zu erstellen. Abschließend haben wir versucht, ein bz2-komprimiertes Archiv mit 8, 16 und 32 Nickel-Cores zu erstellen.
Wenig überraschend dauert der Aufbau des Archivs im Basisfall kaum, da der Großteil der Gesamtzeit für das Hochladen der größeren Datei aufgewendet wird. Beim Komprimieren der Datei ist die Zeitaufteilung umgekehrt: Der Großteil der Zeit wird stattdessen für das Komprimieren der Datei aufgewendet. Wenig überraschend bietet die Nutzung mehrerer Kerne eine deutliche Beschleunigung gegenüber der Single-Core-Gzip-Unterstützung des Tar-Befehls. Bei etwa 16 Kernen entspricht die Gesamtzeit in etwa der des Basisfalls.
Der wahre Nutzen des Komprimierungsschritts wird jedoch deutlich, wenn ein Benutzer versucht, die Ausgabe auf seine lokale Arbeitsstation herunterzuladen, da die komprimierte BZ2-Datei fast fünfmal kleiner ist als die unkomprimierte TAR-Datei (5 MB gegenüber 439 GB).
Wir sind überzeugt, dass die Verlagerung eines Großteils Ihrer Nachbearbeitung und Visualisierung in die Cloud der beste Weg ist, den Datentransfer zu minimieren. Bei großen Mengen an Ausgabedateien können Sie die Übertragungszeiten jedoch oft drastisch reduzieren, indem Sie vorab ein komprimiertes Archiv vorbereiten. Wir planen, viele der in diesem Beitrag beschriebenen manuellen Schritte zu automatisieren und den Prozess in Zukunft reibungsloser zu gestalten. Bleiben Sie dran!
