
ANSYS Fluent Batch-Tutorials
Dieses Tutorial zeigt Ihnen, wie Sie ANSYS-Jobs stapelweise an die Rescale-Plattform übermitteln. Wir erstellen eine Eingabedatei aus der jeweiligen ANSYS-Software, starten einen Rescale-Job, übermitteln ihn und übertragen die Ergebnisse zurück an ANSYS.
Vorverarbeitungsaktivitäten (z. B. Geometrie, Mesh/Modell) sind bereits abgeschlossen und alle LöserEin Solver ist ein numerischer Algorithmus oder ein Softwaretool, das … Mehr Die Setup-Einstellungen sind bereits festgelegt. Im Gegensatz zur Auftragsübermittlung über RSM müssen Sie Rescale Desktops nicht starten. Sie können Ihre eigene ANSYS-Software und -Lizenz verwenden oder sich an uns wenden und Elastic License Units (ELUs) erwerben.
In diesem Abschnitt lösen wir einen ANSYS Fluent-Job im Batch-Verfahren. Um die für dieses Tutorial benötigten Dateien zu erhalten, besuchen Sie bitte [Link einfügen]. Öffnen Sie ein Support-Ticket mit Rescale-Unterstützung.
Erstellen von Fall- und Journaldateien
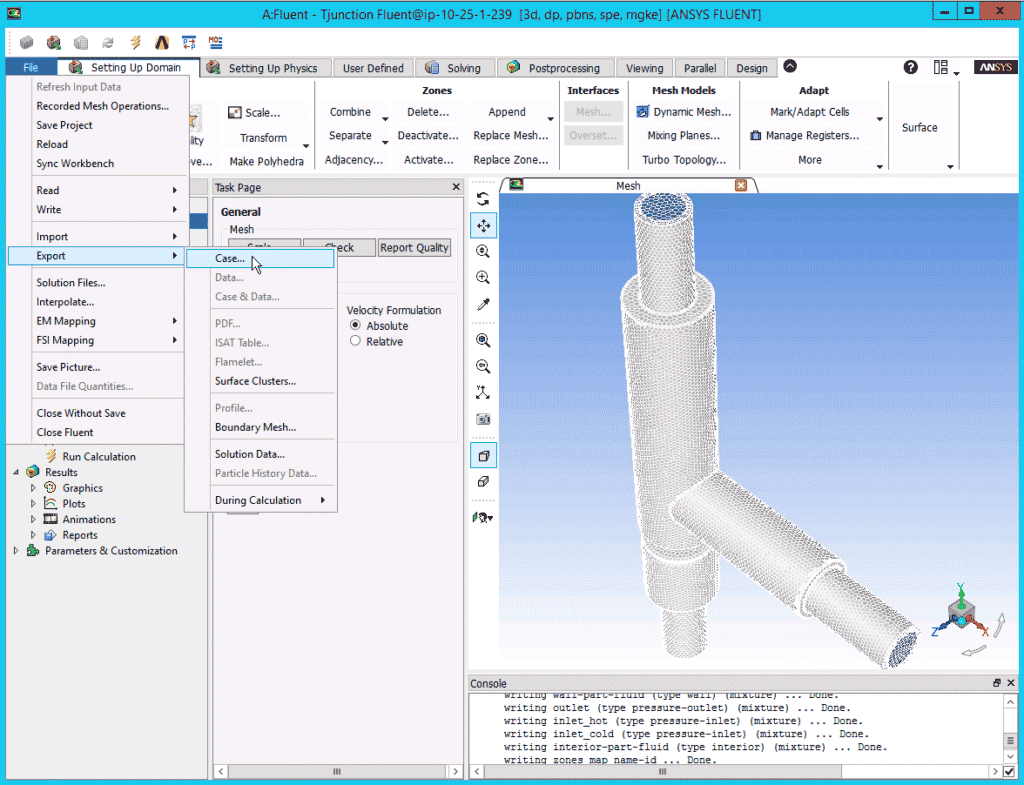
Das Tutorial-Beispiel ist eine T-Verbindung zweier Flüssigkeiten mit unterschiedlichen Temperaturen unter Verwendung von ANSYS Fluent Version 18. Die Fallakte tjunction_plot.cas.gz steht Ihnen bereits zur Verfügung. Die Schritte zum Erstellen einer Fallakte sind:
- Gehen Sie auf Fluent zu Reichen Sie das Registerkarte, wählen Sie dann Exportieren > Fall…, und dies öffnet ein Fenster Browser
- Benennen Sie die Datei mit a .Fall or .cas.gz Erweiterung und wählen Sie den Speicherort aus, an den diese Datei exportiert werden soll.
Diese Datei enthält alle Vorverarbeitungseinstellungen sowie die Solver- und Physikeinstellungen, die gemäß Ihrem Standard-Workflow in der GUI konfiguriert wurden.
Sie benötigen außerdem eine Journaldatei, die alle notwendigen Befehle enthält, die Sie mit Fluent während eines Batchlaufs ausführen möchten. Die Journaldatei run_plot.jou steht Ihnen bereits zur Verfügung. Die Schritte zum Erstellen einer Journaldatei sind:
- Klicken Sie in einem Windows Explorer-Fenster mit der rechten Maustaste auf > Neu > Textdokument (oder ähnlich für andere Betriebssysteme).
- Geben Sie der Datei einen Namen mit Erweiterung .dein. Akzeptieren Sie die Änderung der Dateierweiterung.
- Doppelklicken Sie auf die Datei, um sie zu öffnen, geben Sie die Journalbefehle ein und speichern Sie dann die Datei.
Die Journaldatei sieht folgendermaßen aus:
/file/set-batch-options no yes yes no
/file/read-case tjunction_plot.cas
/solve/initialize/initialize/
/solve/iterate 500
/file/write-case-data tjunction_plot%i.cas.gz
/exit yes
Die oben gezeigte Journaldatei liest die Falldatei, legt die Batchoptionen fest, initialisiert, führt die Berechnung für 500 Iterationen aus und schreibt schließlich einen Fall und eine Datendatei, wenn die Lösung zu einem vorgeschriebenen Grenzwert konvergiert ist.
Diese Datei wird mit dem ANSYS Fluent Text-Benutzeroberfläche (TUI)Weitere Informationen zur Verwendung bestimmter Textschnittstellenbefehle finden Sie in der ANSYS-Onlinedokumentation. werden auf dieser Seite erläutert.
Auftragseinrichtung neu skalieren
Nachdem wir die notwendigen ANSYS Fluent-Dateien erhalten haben, werden wir nun eine Plug-and-Play-Betrieb Job auf Rescale. Weitere Informationen zum Starten eines einfachen Jobs finden Sie im Tutorial werden auf dieser Seite erläutert.
Setup: Eingabedatei(en)
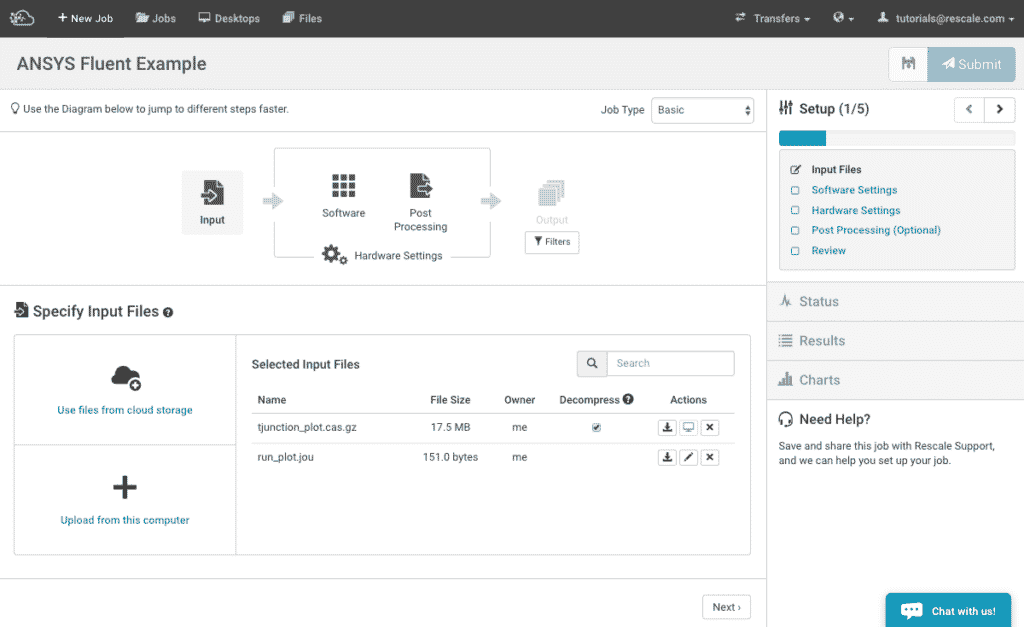
- Gehen Sie auf die Rescale-Plattform, klicken Sie auf + Neuer Job oben links. Benennen Sie Ihren Job und stellen Sie sicher, dass die Anstellungsart eingestellt ist Plug-and-Play-Betrieb.
- Laden Sie als Nächstes die Journal- und Falldateien als Eingabedateien hoch.
Setup: Softwareeinstellungen
Klicken Sie auf Weiter weitergehen auf die Softwareeinstellungen Abschnitt des Setups.
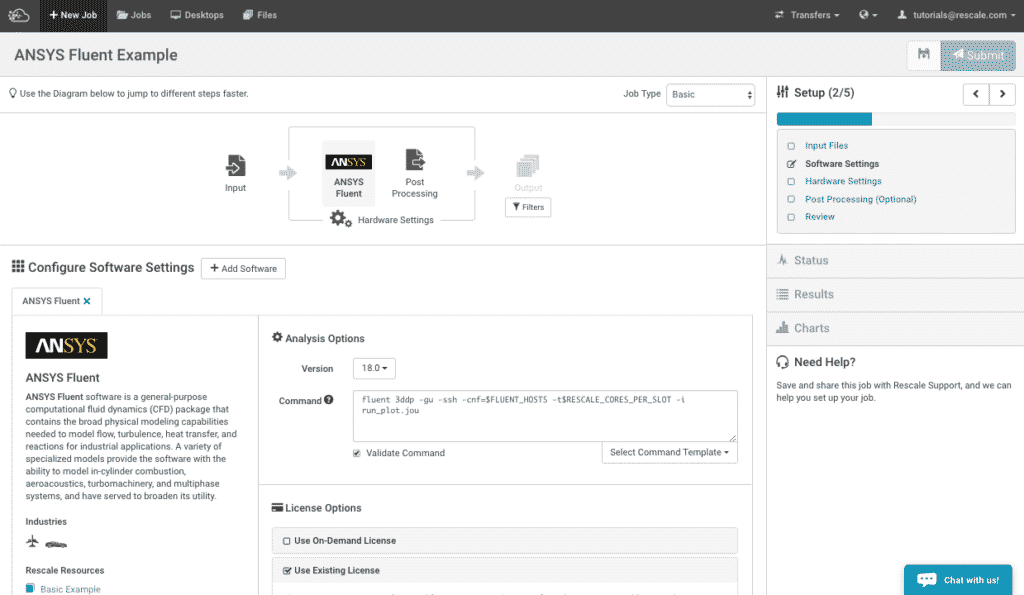
- Sie können nach unten scrollen oder die Suchleiste verwenden, um ANSYS Fluent auszuwählen. Die Analyseoptionen wird Version 18.0 angezeigt und ausgewählt.
- Im Befehlsfenster müssen Sie den Namen der Journaldatei unter der spitzen Klammer angeben . Wir möchten auch den Lösungsrest sehen. Dazu befehlen wir, die Grafikfenster mit dem -gu .
- Weiter unter LizenzierungDie Lizenzierung ist ein rechtliches Instrument, das Benutzern Nutzungsrechte einräumt, ... Mehr OptionenWählen Vorhandene Lizenz verwenden und geben Sie Ihr ANSYS ein ServerEin Server ist ein Computerprogramm, das Dienste für andere bereitstellt. Mehr Verbindungsportnummern unter Lizenz und ANSYS-Lizenz InterconnectDie von den Rechenknoten zur Kommunikation verwendeten Kabel und Switches ... Mehr beziehungsweise.
Für dieses Tutorial sieht die Seite mit den Softwareeinstellungen wie unten gezeigt aus.
Setup: Hardwareeinstellungen
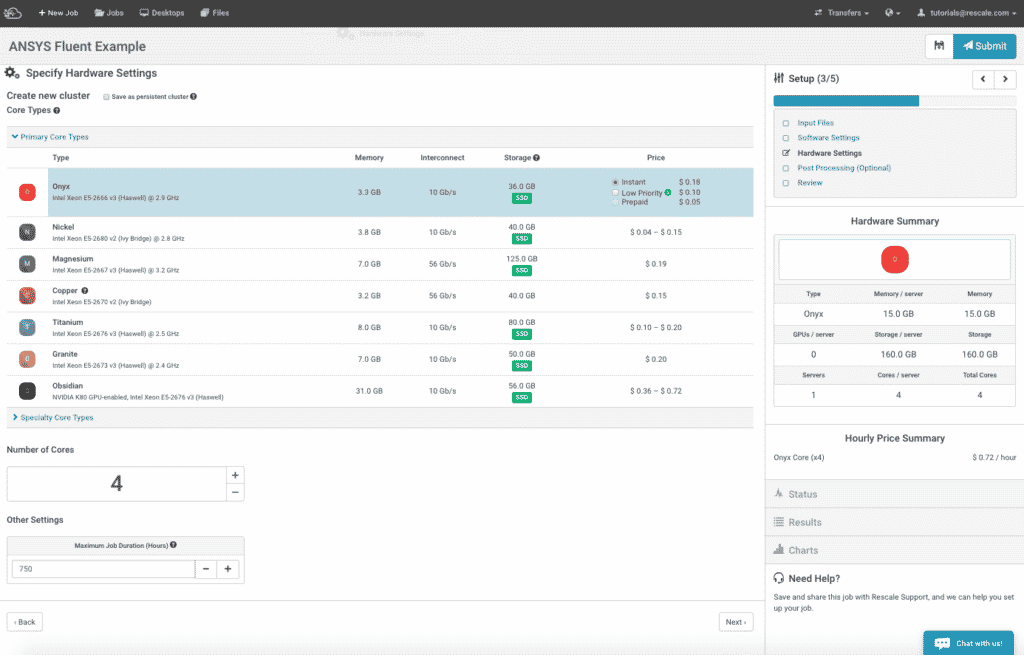
Im nächsten Schritt wählen Sie die gewünschte Hardware für den Job aus. Klicken Sie auf das Hardwareeinstellungen klicken.
- Wählen Sie Ihren Wunsch Coreeine einzelne Verarbeitungseinheit innerhalb eines Mehrkernprozessors oder ... Mehr Typ und Anzahl der Kerne, die Sie für diesen Job verwenden möchten. Wählen Sie für dieses Tutorial Emerald und 4 Kerne.
Ihre Hardwareeinstellungen Der Bildschirm sollte folgendermaßen aussehen:
Setup: Überprüfung
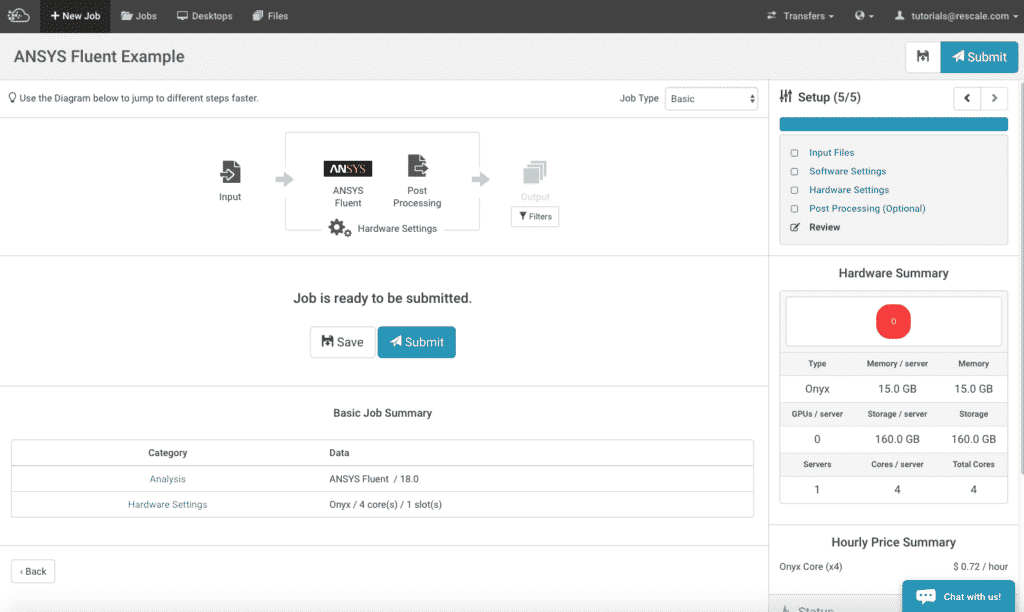
In diesem Tutorial gibt es keine Nachbearbeitungseinstellungen. Klicken Sie auf das Bewertung Symbol. Überprüfen Sie, ob die Einrichtung korrekt ist, indem Sie die Grundlegende Jobzusammenfassung Tabelle. Sie sollte folgendermaßen aussehen:
Auftragsübermittlung und -überwachung
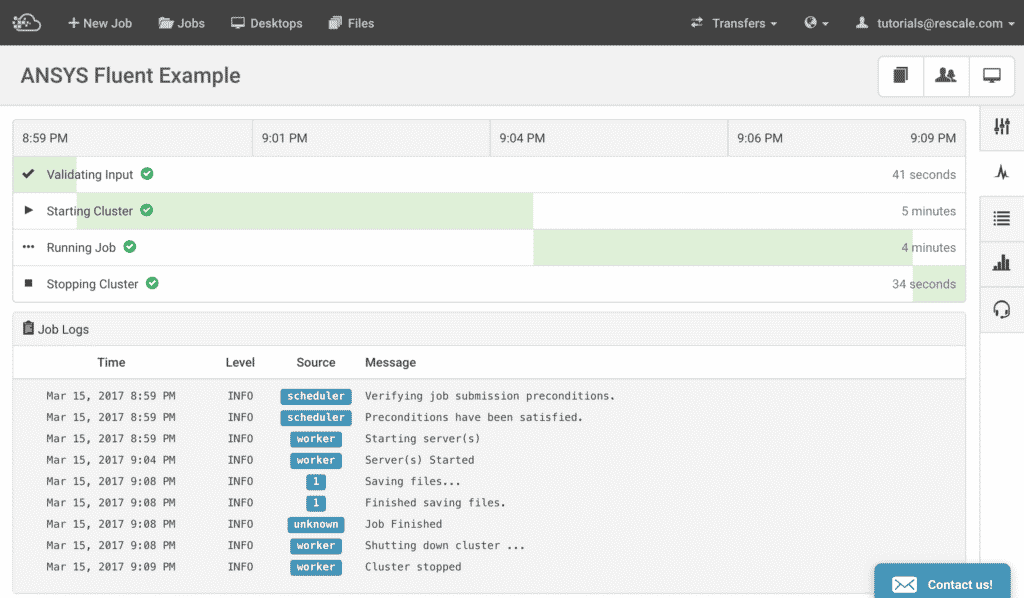
Nachdem Sie Ihre Einstellungen überprüft haben, können Sie Ihren Auftrag absenden. Klicken Sie auf Absenden und Sie werden weitergehen von der Einrichtung Seite zur Status Seite in der Rescale-Plattform. Hier können Sie den Auftragsfortschritt in einem Gantt-Diagramm-ähnlichen Format überwachen, ein Protokoll mit Datums- und Zeitstempel anzeigen und den Status und die Ausgabe Ihres Auftrags mithilfe der Lebender Schwanz Fenster. Eine Anleitung zum „Überwachungsstatus“ bei Rescale finden Sie werden auf dieser Seite erläutert.
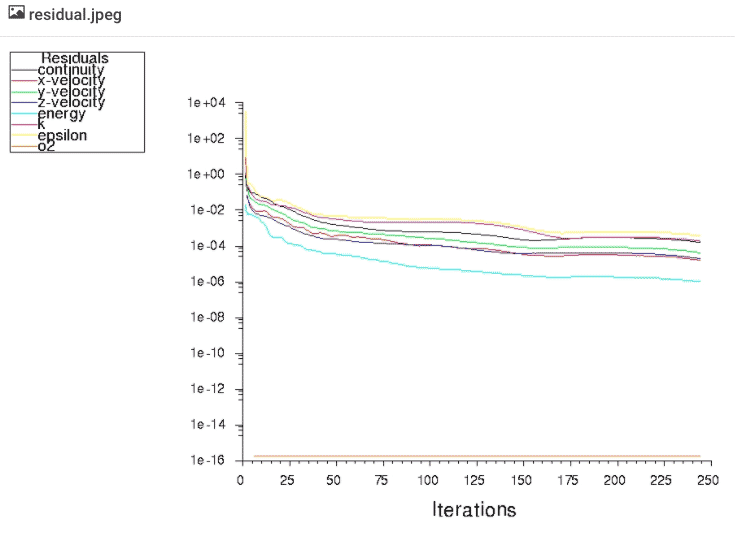
In diesem Beispiel haben wir die SimulationSimulation ist Experimentieren, Testen von Szenarien und Erstellen von … Mehr um bei jeder Iteration ein Residuendiagramm auszugeben, das unter dem Lebendschwänzenauch als Echtzeit-Protokollüberwachung oder Live-Protokollüberwachung bezeichnet … Mehr Fenster als residual.jpeg Datei. Sie können dieses Diagramm jederzeit öffnen, um den Konvergenzfortschritt der Lösung zu überwachen.
Ergebnisse anzeigen
Sobald der Auftrag abgeschlossen ist, können Sie die Ergebnisse entweder auf Ihrem lokalen ArbeitsplatzEine Workstation ist ein leistungsstarkes Computersystem, das für professionelle Zwecke entwickelt wurde. Mehr oder auf einem Rescale-Desktop. Beide Methoden werden im Folgenden vorgestellt:
Auf Ihrer lokalen Workstation
Sobald der Auftrag abgeschlossen ist, können Sie die Datei(en) auswählen, die Sie herunterladen möchten.
Hinweis: Wenn Sie große Ausgabedateien haben, wird Windows-Benutzern empfohlen, Rescale Transfer Manager (RTM), um Dateien schneller auf Ihre lokale Workstation herunterzuladen. Weitere Informationen zu RTM finden Sie werden auf dieser Seite erläutert. Linux- oder Mac-Benutzer können verwenden CLI neu skalieren um größere Ausgabedateien herunterzuladen.
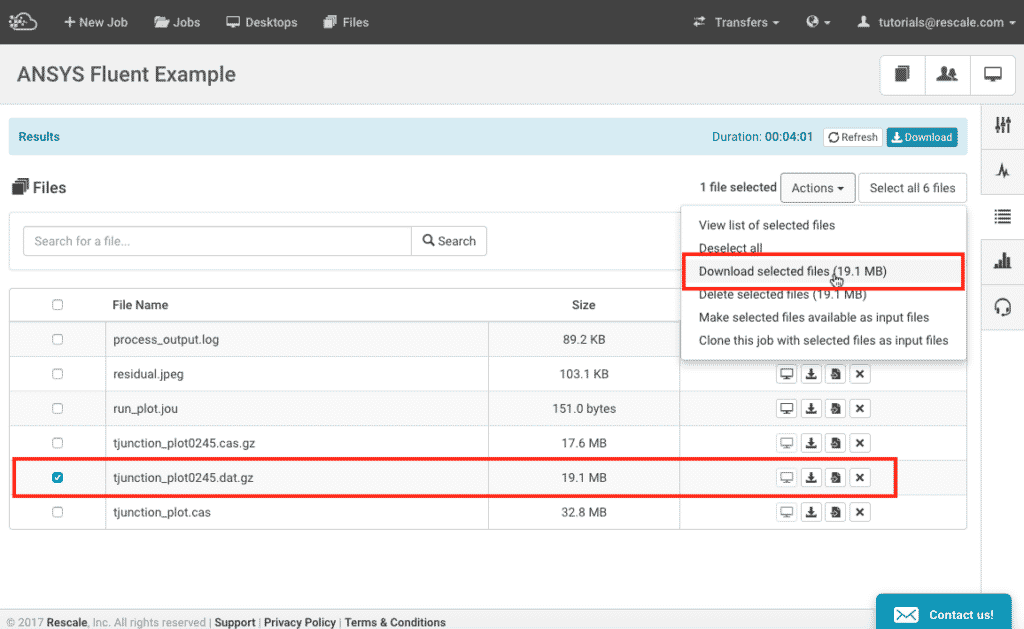
- Gehen Sie zur Ergebnisseite des abgeschlossenen Auftrags, suchen und wählen Sie die
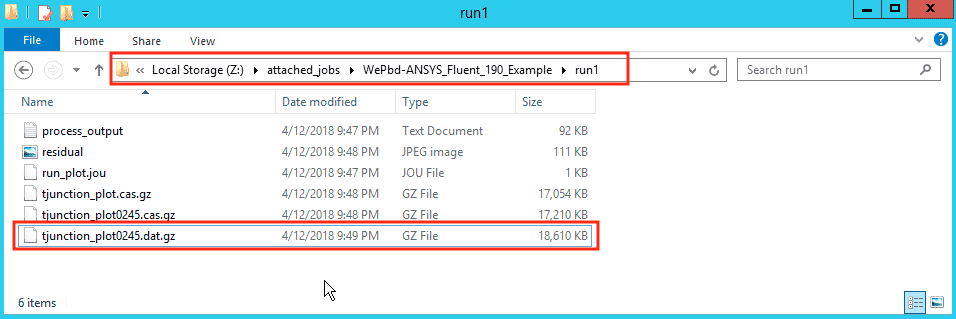
tjunction_plot0245.dat.gz - Zurück Nach Aktion und klicken Sie auf Ausgewählte Dateien herunterladen, warten Sie ein paar Sekunden, bis es auf Ihren Computer heruntergeladen ist
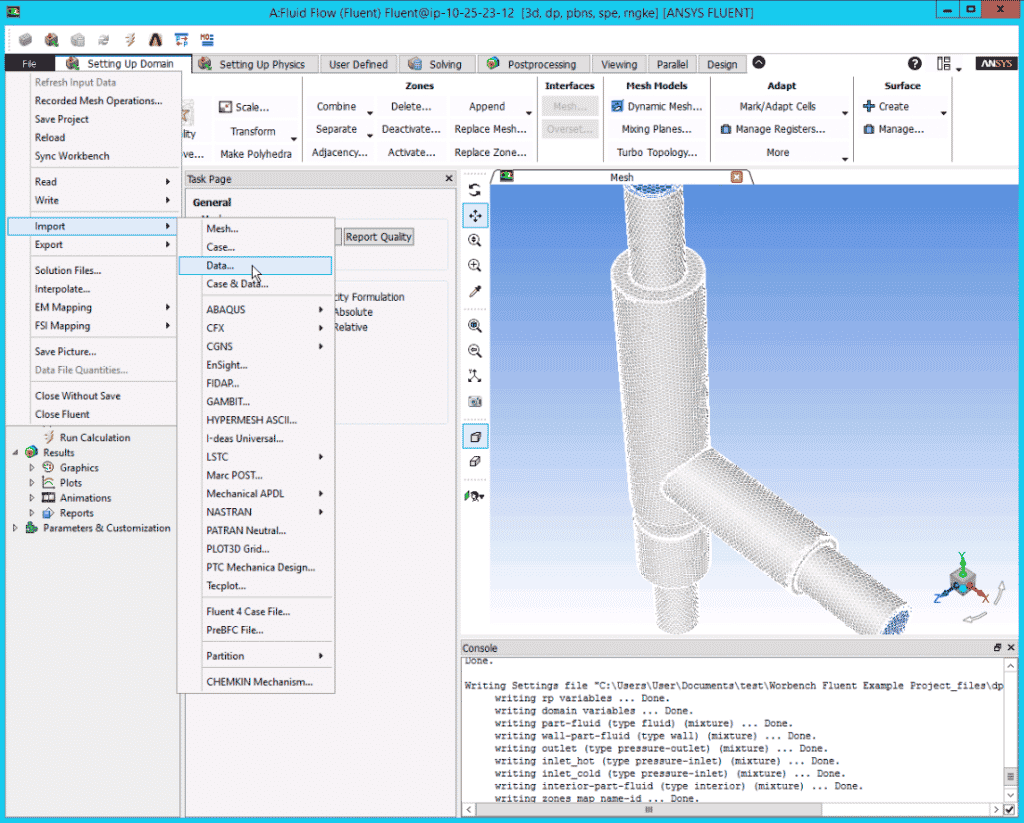
- Start Fließend . Gehe zu Reichen Sie das Registerkarte, und wählen Sie Importieren > Daten… , um die Lösungsdatendatei zu laden
Auf einem neu skalierten Desktop
Führen Sie nach Abschluss des Auftrags die folgenden Schritte aus, um die Ergebnisse auf einem Rescale-Desktop anzuzeigen:
Richten Sie ein Desktop-Sitzung:
- Der 1.Konfiguration auswählen Wählen Sie im Dropdown-Menü die Hardware für Ihr Desktop-Sitzung
- Der 2.Software hinzufügen Dropdown, wählen Sie ANSYS Fluids Desktop
- Der 3.Jobs Suchen Sie in der Dropdown-Liste nach dem Job, den Sie hinzufügen möchten, indem Sie den Namen eingeben und/oder die Liste durchsuchen. Klicken Sie auf Speichern um einen Job zum Desktop hinzuzufügen
- Sobald die Desktop-Sitzung gestartet ist, starten Sie Fließend
- Gehen Sie auf Fluent zu Reichen Sie das Registerkarte, und wählen Sie Importieren > Daten… Navigieren Sie zu den zugeordneten Verzeichnissen. Normalerweise wird das Laufwerk Z: zugeordnet, der angehängte Job kann sich aber auch auf den Laufwerken X: oder Y: befinden, abhängig von Ihrer Konfiguration. Klicken Sie auf
tjunction_plot0245.dat.gzDatei, um die Lösungsdatendatei zu laden, und klicken Sie auf Öffne
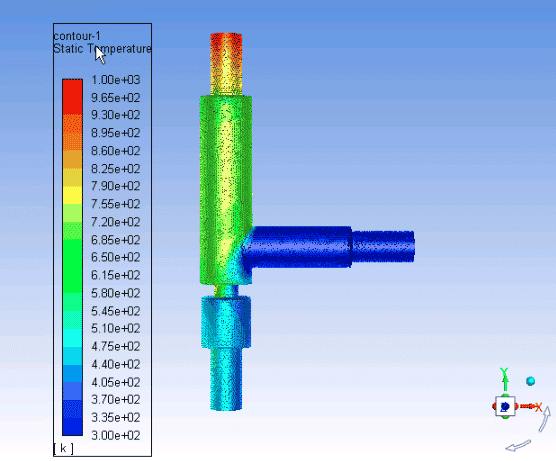
An diesem Punkt können Sie mit Ihren Nachbearbeitungsaktivitäten fortfahren, wie Sie es normalerweise nach dem interaktiven Lösen einer Ansys Fluent-Simulation tun würden.
ANSYS Fluent ermöglicht es Benutzern außerdem, das Verhalten der Physik und des Solver-Setups zu ändern oder zu erweitern. Benutzerdefinierte Funktionen (UDF) können verwendet werden, um Aktionen wie das Auferlegen von Randbedingungen, physikalische und chemische Prozesse, Wärmeübertragung und Phasenänderungen durchzuführen.
In diesem Abschnitt präsentieren wir Anweisungen zur Verwendung von Fluent User Defined Functions (UDF) im Batchmodus auf der Rescale-Plattform.
Diese Anleitung geht davon aus, dass Sie bereits eine UDF entwickelt haben, die für die Kompilierung in einem Fluent-Job bereit ist. Für Unterstützung beim Erstellen oder Debuggen von UDFs wenden Sie sich bitte direkt an den ANSYS-Support. Hier ist eine Entwicklung von ANSYS zur Verwendung von UDFs in Fluent.
Kompilierung von UDFs im Batch
Um eine UDF während eines Batch-Laufs zu verwenden, muss der UDF-Quellcode zunächst kompiliert und für Fluent zugänglich sein. Wir demonstrieren einen Workflow, der die UDF zur Laufzeit vor dem eigentlichen Lösungs- oder Iterationsprozess kompiliert. Dies erreichen wir durch das Hinzufügen von Befehlen zu einer vorhandenen Beispiel-Journaldatei. Abhängig von Ihrem Workflow und der Größe der Kompilierungsbibliotheken ist es möglich, diese UDF-Bibliotheken vorkompiliert und als Eingabedateien in Ihren Batch-Job einzubinden. Da UDFs im Allgemeinen unkomplizierter Code sind, ist die Laufzeitkompilierung ein kurzer Vorgang und vermeidet Plattforminkonsistenzen.
Beispiel einer Journaldatei
Das folgende Beispiel ist eine Journaldatei, die eine vom Benutzer erstellte custom_UDF.c Datei im aktuellen Verzeichnis (mit der Journaldatei) und lädt die resultierenden UDF-Bibliotheken. Die UDF wird mit dem Standardbibliotheksnamen kompiliert libudf und erstellt eine entsprechend benannte Verzeichnisstruktur mit den gemeinsam genutzten Bibliotheken.
Hier werden die Kompilierungs- und Ladebefehle (siehe fett) sind sequenziell und finden vor der Initialisierung der Lösung statt. Sie können diese Vorgänge jedoch überall dort ausführen, wo sie in Ihren Arbeitsablauf passen.
/file/set-batch-options nein ja ja nein /file/read-case example.cas
/define/user-defined/compiled-functions kompiliere libudf ja custom_UDF.c "" /define/user-defined/compiled-functions lade libudf
/lösen/initialisieren/initialisieren /lösen/iterieren 1000 /parallel/timer/verwendung /datei/schreibe-falldaten-beispiel-%i.cas /exit ja
Hier sind zwei spezifische Syntaxaspekte zu beachten. Erstens stehen nach dem Namen der UDF-Quellcodedatei zwei doppelte Anführungszeichen "" vorhanden. Die zweite ist die Leerzeile nach dem compile Befehl. Dadurch wird sichergestellt, dass die Kompilierfunktion die folgenden Zeilen nicht als zusätzliche Dateinamen behandelt, die in die Kompilierfunktion einbezogen werden sollen. Die Leerzeile ist nach dem Kompilierbefehl erforderlich, muss aber nicht vor oder nach dem Ladebefehl stehen.
Einen expliziten UDF-Aufruf durchführen
Gelegentlich müssen Sie vor oder nach einem Lösungsprozess eine UDF-Funktion aufrufen, um eine Randbedingung festzulegen oder einen Nachbearbeitungsschritt durchzuführen. Sie können diese UDF-Funktion explizit in Ihrer Journaldatei mit einem execute-on-demand Rufen Sie gegebenenfalls an:
/define/benutzerdefiniert/bei Bedarf ausführen "Funktionsname::libudf"
Ausführung auf mehreren Knoten
Beachten Sie außerdem, dass aufgrund der Art der UDF-Funktionsaufrufe alle Knoten Zugriff auf die kompilierten UDF-Bibliotheken benötigen. Standardmäßig werden ANSYS Fluent-Jobs so eingestellt, dass sie im ~/work Verzeichnis, das lokal zum Kopf ist KnotenIn der herkömmlichen Datenverarbeitung ist ein Knoten ein Objekt in einem Netzwerk. ... Mehr. Abhängig vom Verhalten der Funktion müssen die Worker-Knotenprozesse möglicherweise auf eine gemeinsame Datei oder Bibliothek zugreifen. In diesem Fall sollte der Job aus dem NFS-gemounteten Verzeichnis ausgeführt werden. ~/work/shared. Stellen Sie daher einfach die Befehle zum Verschieben und Ändern des Verzeichnisses auf der Seite „Softwareeinstellungen“ voran, bevor Sie Fluent starten (nicht in der Journaldatei):
mv * geteilte CD geteiltes fließendes 3ddp -gu -ssh -cnf=$FLUENT_HOSTS -t$RESCALE_CORES_PER_SLOT -i example.jou
Wenn Sie also mehrere Kerne auf einem Single Knoten ist dieser Schritt nicht erforderlich, da auf das lokale Dateisystem von allen Kernen auf diesem Knoten zugegriffen werden kann.