
LS-DYNA
Rescale bietet eine benutzerfreundliche Kommandozeilenschnittstelle zum Ausführen von LS-DYNA-Jobs. Hier werden wir die Befehle zum Ausführen von LS-DYNA in den drei verschiedenen Umgebungen erläutern. LöserEin Solver ist ein numerischer Algorithmus oder ein Softwaretool, das … Mehr Modi:
- Gemeinsam genutzter Speicher parallel (SMP)
- Verteilter Speicher parallel (DMP)
auch bekannt als Message Passing Parallel (MPP) - Hybrid-MPP
Jeder Solver benötigt unterschiedliche Argumente, um erfolgreich ausgeführt zu werden. Die folgenden Beispiele zeigen Vorlagen für die drei verschiedenen Solver-Modi. Dabei gilt:
-i ist das Eingabedateiargument
-p ist die Gleitkommagenauigkeit
-n ist ein DMP-Rangargument
-s ist ein SMP-Thread-Argument
Hinweis: Ersetzen Sie in den folgenden Beispielen bitte den Namen der Eingabedatei inklusive Erweiterung. Entfernen Sie unbedingt die Klammern < >.
SMP-Modus
Wenn Sie im SMP-Modus arbeiten möchten, konfigurieren Sie Ihren Job auf einem einzelnen Server. KnotenIn der herkömmlichen Datenverarbeitung ist ein Knoten ein Objekt in einem Netzwerk. ... Mehr Hardwareseitig. Dadurch wird der Job automatisch im SMP-Modus ausgeführt. Wenn Sie den SMP-Modus mit mehreren Kernen erzwingen möchten, folgen Sie dieser Befehlsvorlage:
ls-dyna -s $RESCALE_CORES_PER_SLOT -i -P
Beachten Sie hier, wir verwenden die RESCALE_CORES_PER_SLOT Die Umgebungsvariable gibt die Anzahl der SMP-Threads an, die immer der Anzahl der Kerne Ihres Einzelknotens entspricht. GruppeEin Computercluster besteht aus einer Reihe von lose oder eng miteinander verbundenen ... Mehr.
DMP-Modus
Wenn Sie in DMP Nur kann der Job mit dem folgenden Befehl ausgeführt werden:
ls-dyna -i -P
Beachten Sie, dass in diesem Fall die Anzahl der DMP-Ränge automatisch aus der Hardwareauswahl übernommen wird.
Der Befehl für einfache Genauigkeit lautet:
ls-dyna -i -p einzeln
Der Befehl für doppelte Genauigkeit lautet:
ls-dyna -i -p doppelt
Hybridmodus
Der Befehl zum Angeben eines Hybride Parallelisierung Konfiguration ist:
ls-dyna -n -S -ich -P -A
woher
-n ist ein DMP-Rangargument
-s ist ein SMP-Thread-Argument
Wenn Sie beispielsweise einen Job mit 16 Kernen (16 SMP-Threads) starten, können Sie eine hybride Parallelisierungskonfiguration angeben, indem Sie 8 Knoten (DMP-Ränge) mit jeweils 2 Kernen/Threads (16/8 = 2) verwenden: -n 8 -s 2
Der vollständige Befehl für LS-DYNA-Jobs lautet wie folgt:
ls-dyna -n -S -ich -P -A
Zusätzliche Befehlszeilenoptionen können verwendet werden, indem Sie den -a Flag zur Befehlszeile. Diese zusätzlichen Argumente werden direkt an die ausführbare LS-DYNA-Datei übergeben.
Wenn Sie beispielsweise die Speichernutzung für einen bestimmten Lauf angeben müssen:
ls-dyna -i input.k -p single -a "Speicher=600m Speicher2=60m"
or
ls-dyna -i input.k -p single -a "memory=30000 memory2=20000 p=my-pfile"
Speicher: Speicher, der vom Kopfprozessor zur anfänglichen Zerlegung verwendet wird ModellEine numerische, symbolische oder logische Darstellung eines Systems ... Mehr
memory2: Von allen Prozessoren zur Lösung des zerlegten Problems verwendeter Speicher (einschließlich Kopfknoten)
Eine P-Datei kann verwendet werden, indem man die -a Flag zur Befehlszeile hinzufügen. Beispiel:
ls-dyna -i input.k -p single -a "p=meine-p-Datei"
Zuerst müssen Sie SSH in Ihren laufenden Cluster.
Sobald Sie sich auf der Bash-Oberfläche der virtuellen Maschine befinden, navigieren Sie bitte in den richtigen Ordner mit cd work/shared. Geben Sie anschließend den folgenden Befehl ein echo <switch> > d3kil, Ersetzen <switch> mit dem Switch-Befehl, den Sie ausführen möchten. Zum Beispiel: echo sw2 > d3kil
Bitte beachten Sie, dass die d3kil-Datei nach der Ausführung verbraucht und entfernt wird.
Hier ist die Liste der Sense-Schalter und ihre Reaktion für LS-DYNA:
- sw1 – Eine Neustartdatei wird geschrieben und LS-DYNA wird beendet (Cluster wird heruntergefahren)
- sw2 – LS-DYNA antwortet mit Zeit und Zyklusnummern (Ausgabe in ls-dyna.log)
- sw3 – Eine Neustartdatei wird geschrieben und LS-DYNA fährt fort
- sw4 – Ein Plotstatus wird geschrieben und LS-DYNA fährt fort
- swa – LS-DYNA leert alle Ausgabe-E/A-Puffer
- Stopp/Beenden – Ausführung anhalten (Cluster wird heruntergefahren)
Wenn Sie eine Version von LS-DYNA verwenden müssen, die nicht im Dropdown-Menü enthalten ist, können Sie die Build-Dateien zusammen mit Ihren Eingabedateien in einen Rescale-Job hochladen und als Benutzerdefinierte Version.
Bitte stellen Sie sicher, dass der Build von LS-DYNA:
- 64-Bit-Linux
- MPP-Version
Die Schritte sind wie folgt:
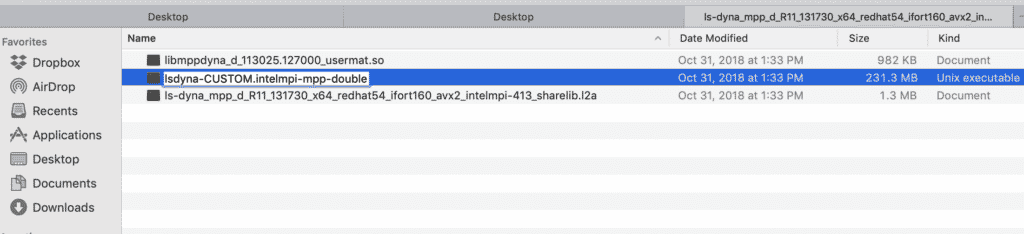
- Laden Sie die benutzerdefinierten Build-Dateien auf Ihren Computer herunter
- Gehen Sie zu dem Ordner, in dem sich die Build-Dateien befinden
- Identifizieren Sie die ausführbare Datei und benennen Sie sie um.
Damit benutzerdefinierte Builds funktionieren, muss die ausführbare Datei umbenannt werden in lsdyna-CUSTOM.<mpi-flavor>-mpp-<precision>Ein Beispiel wäre: lsdyna-CUSTOM.platformmpi-mpp-single. Bitte stellen Sie sicher, dass Ihr benutzerdefinierter Build der von Ihnen benannten MPI-Variante entspricht, sonst schlägt Ihr Job fehl.
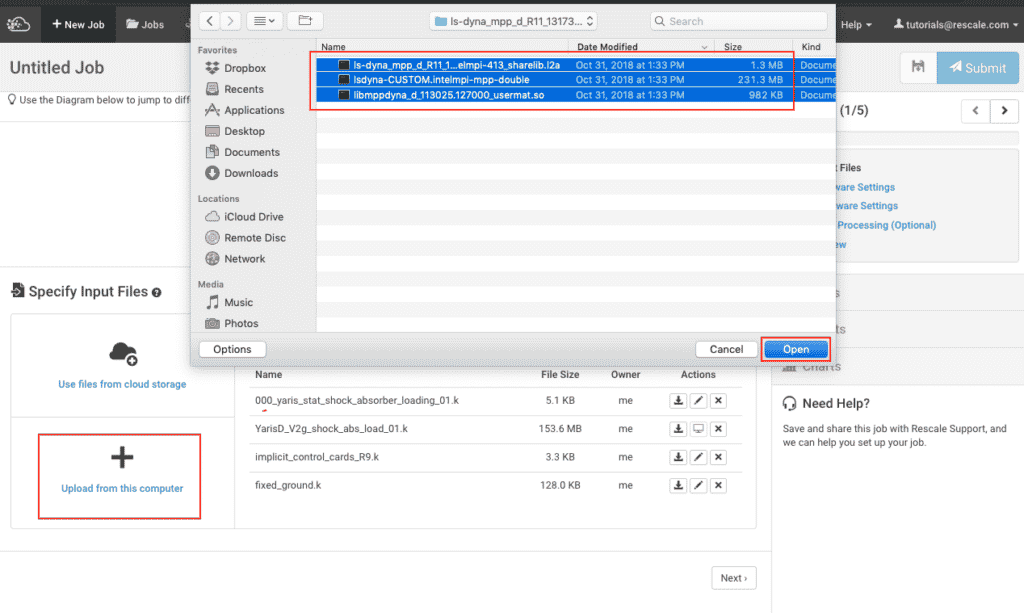
Laden Sie auf der Rescale-Plattform die Build-Dateien zusammen mit den Eingabedateien in den Job hoch.
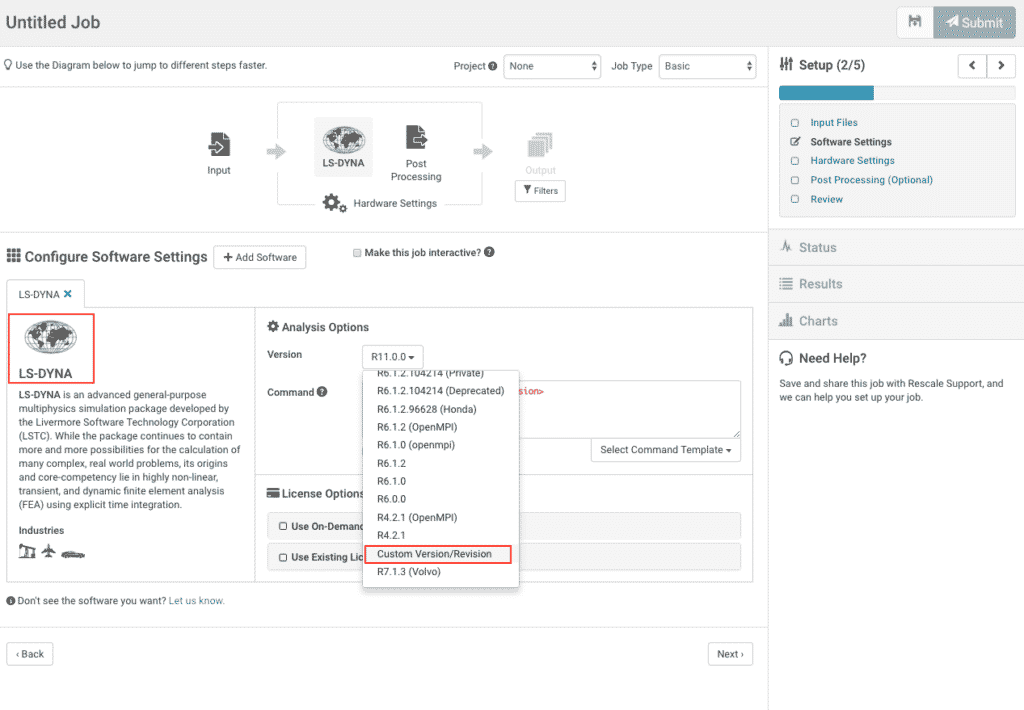
- Auf dem Software Seite, wählen Sie LS-DYNA
- Der Version, wählen Sie Benutzerdefinierte Version/Revision
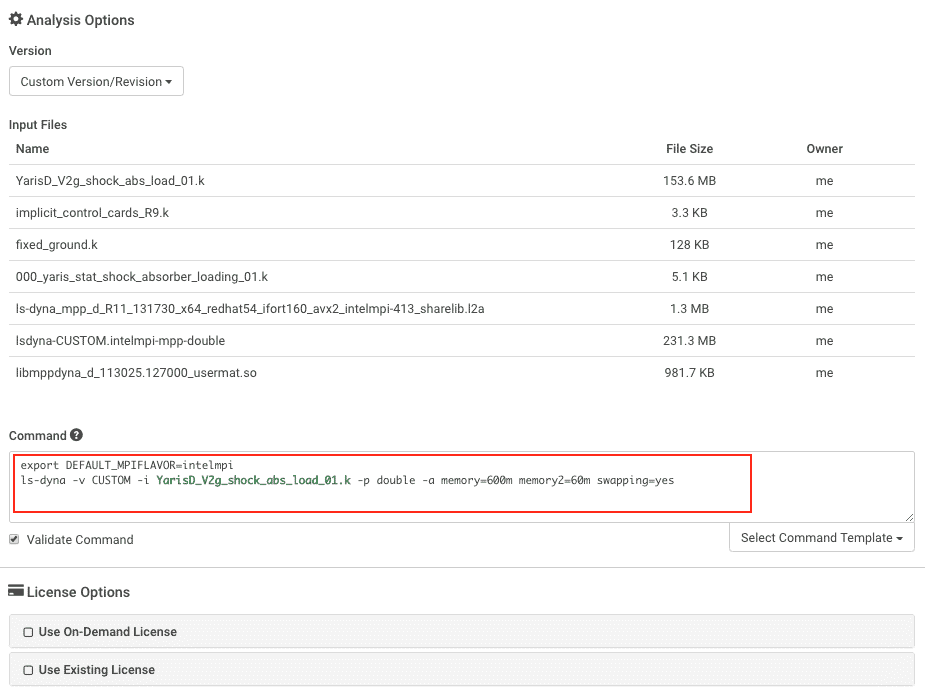
- Geben Sie im Befehlsfenster Folgendes an:
export MPI_FLAVOR=intelmpi ls-dyna -v -ich -P -A
Beispiel:
export MPI_FLAVOR=intelmpi ls-dyna -v CUSTOM -i YarisD_V2g_shock_abs_load_01.k -p double -a memory=600m memory2=60m swapping=yes
In diesem Beispiel:
MPI-Variante für den Custom Build ist Intel mpi
Eingabedatei is YarisD_V2g_shock_abs_load_01.k
Präzision is doublememory ist der vom Hauptprozessor für die anfängliche Zerlegung des Modells verwendete Speicher (MB).memory2 ist der Speicher (MB), der von allen Prozessoren zur Lösung des zerlegten Problems verwendet wird (einschließlich Kopfknoten)
Ersetzen Sie diese Felder im Befehlsfenster entsprechend Ihrer Aufgabe.
Ihr Job wird jetzt auf Ihrer benutzerdefinierten LS-DYNA-Version ausgeführt.