
Hochdurchsatz-Computing (HTC)
Bitte beachten Sie, dass sich diese Funktion derzeit in der Betaphase befindet und nicht standardmäßig aktiviert ist. Wenden Sie sich an den Solution Architect oder Account Executive Ihres Unternehmens, um den Zugriff zu aktivieren.
Übersicht
Neu skalieren Hochdurchsatz-Computing (HTC) ist ein API-basiertes Rescale-Produkt zum Ausführen einer großen Anzahl (z. B. Hunderte bis Millionen) gleichzeitiger kleiner und entkoppelter Jobs (z. B. einstellige Kerne bis einstellige Instanzen und kein MPI mit mehreren Knoten).
Hochleistungsrechnen (HPC) verwendet Cluster zur Lösung komplexer Rechenaufgaben. Große Aufgaben werden in Teilaufgaben aufgeteilt und parallel auf einem Mehrknoten- GruppeEine HPCDie Verwendung der Parallelverarbeitung zum Ausführen erweiterter Anwendungen ... Mehr GruppeEin Computercluster besteht aus einer Reihe von lose oder eng miteinander verbundenen ... Mehr ist eine Menge homogener, miteinander verbundener Maschinen (Knoten). Jeder Knoten führt eine Kopie eines vorinstallierten Programms aus, das Daten verarbeitet, die einen Teil einer Aufgabe darstellen. Um eine globale Lösung zu erreichen, müssen die Knoten in einem HPC-Cluster miteinander kommunizieren und sich daher in der Nähe befinden (gleiche Rechenzentrum.Eine Einrichtung, die Computerhardware, Netzwerkgeräte usw. beherbergt. Mehr, dasselbe Rack). HPC-Berechnungen sind eng gekoppelt und schlagen fehl, wenn einzelne Knoten ausfallen.
Ziel von HPC ist es, die Zeit bis zum Ergebnis einer einzelnen Berechnung zu verkürzen und die Anzahl der Operationen pro Sekunde zu maximieren. Die Lebensdauer eines On-Demand-Cloud-HPC-Clusters ist so kurz wie möglich.
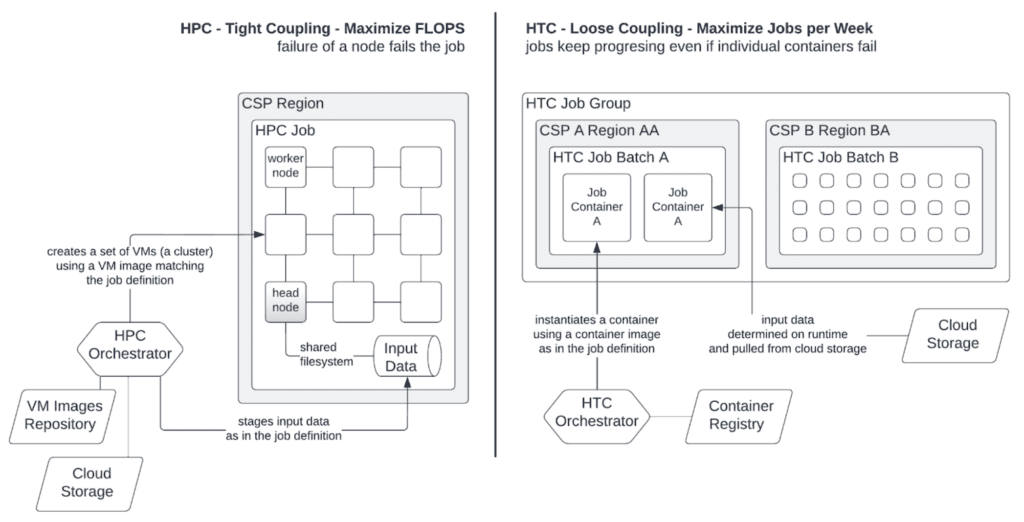
Hochdurchsatz-Computing (HTC)Im Gegensatz zum High-Performance Computing (HPC), bei dem der Schwerpunkt auf Ex... liegt, Mehr verwendet mehrere Knoten über lange Zeiträume, um mehrere Rechenaufgaben zu lösen. Jeder Job führt ein Programm aus, das in einem Container Image in einer Registry gespeichert. Ähnlich wie bei HPC wird die Rechenarbeit in viele Jobs aufgeteilt. Im Gegensatz zu HPC werden HTC-Jobs für einen einzelnen Benutzer PensumUnter Arbeitslast versteht man die Menge und Art der Computeraufgaben oder ... Mehr kann leicht in der Größenordnung von 1,000 bis 10,000 s liegen.
Organisation der Berechnung in HTC
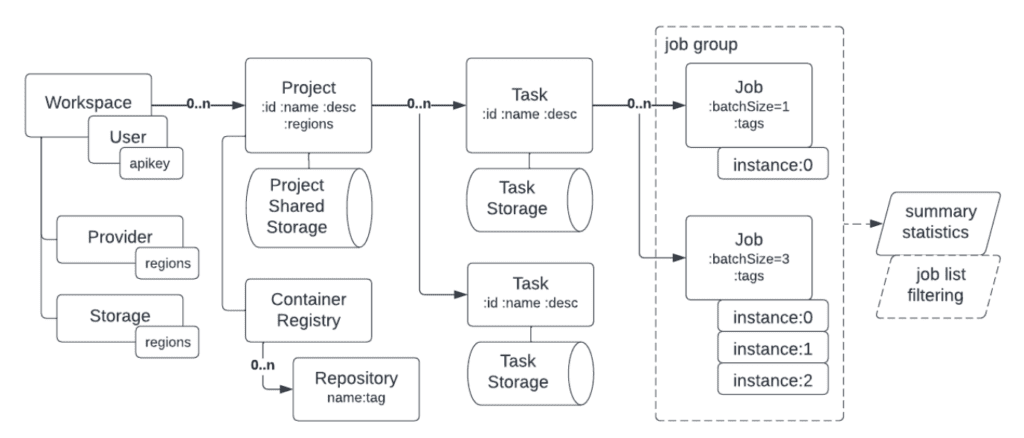
HTC-Jobs sind in einer hierarchischen Struktur organisiert, innerhalb einer ArbeitsplatzMit Workspaces können Kunden von Rescale dedizierte Teams erstellen ... Mehr Bei Verwendung von HTC ist die Hierarchie im folgenden Diagramm dargestellt und sieht wie folgt aus:
Projekt: Ein Arbeitsbereich kann ein oder mehrere Projekte enthalten. Projekte sind zwar keine Voraussetzung, aber im Allgemeinen mittelfristige Entitäten zur Organisation verschiedener Instanzen der Arbeitslasten eines oder mehrerer Benutzer.
Aufgabe: Ein Projekt kann eine oder mehrere Aufgaben enthalten. Eine Aufgabe ist im Allgemeinen flüchtig und umfasst einen „Durchlauf“ der Arbeitslast eines Benutzers.
Job: Eine Aufgabe enthält mehrere Jobs. Der Job ist die grundlegende Arbeitseinheit. Jobs sind voneinander unabhängig.
Das Ziel von HTC besteht darin, die Anzahl der abgeschlossenen Aufträge pro Woche oder Monat zu maximieren, anstatt die Zeit zu optimieren, die ein einzelner Auftrag in Anspruch nimmt. Dies ist der „Durchsatz“-Aspekt von HTC.
Organisation von Daten in HTC
Jedes Projekt verfügt über einen gemeinsam genutzten Speicher, auf den alle Aufgaben zugreifen können. Jeder Aufgabe ist außerdem ein eigener Speicher zugewiesen. Jobs innerhalb einer Aufgabe können nur auf Daten im Speicher dieser Aufgabe zugreifen, nicht auf Speicher anderer Aufgaben. Ebenso können Jobs innerhalb eines Projekts nur auf gemeinsam genutzte Daten des Projekts zugreifen, in dem sich die Aufgabe befindet.
Im Allgemeinen verwenden Benutzer den Projektspeicher für Eingabedateien, die für eine Aufgabe gemeinsam genutzt werden. Der Aufgabenspeicher wird im Allgemeinen für aufgabenspezifische Eingabedateien und Ausgabedateien der Jobs in dieser Aufgabe verwendet.
Sowohl die Projekt- als auch die Aufgabenspeicherung werden derzeit unterstützt durch ObjektspeicherObject Storage ist eine Computerdatenspeicherarchitektur, die … Mehr. Über die HTC-API wird Objektspeicherung bei mehreren Cloud-Anbietern und in mehreren Regionen bereitgestellt, sodass Daten in der Nähe des Computers, der sie verbraucht und produziert, gemeinsam gespeichert werden können.
Die Rescale HTC API
Das folgende Diagramm stellt alle Ressourcen dar, die von der Rescale HTC API bereitgestellt werden. In den folgenden Abschnitten werden diese detaillierter beschrieben. Die vollständige Beta-HTC-API-Dokumentation finden Sie werden auf dieser Seite erläutert.
Zugriff auf die HTC-API
Der Zugriff auf die HTC-API muss zunächst in einem bestimmten Rescale-Arbeitsbereich von einem Rescale-Lösungsarchitekten aktiviert werden. Sobald der Zugriff gewährt wurde, muss ein Rescale-API-Schlüssel zur Authentifizierung verwendet werden. Informationen zum Generieren oder Zugreifen auf einen API-Schlüssel finden Sie hier. in Ihrem HTC-fähigen Arbeitsbereich.
Authentifizierung mit der HTC-API
Dieser Rescale-API-Schlüssel dient dem Zugriff auf HTC-APIs auf der Rescale-Plattform über die öffentliche Rescale-API. Mit diesem Schlüssel können Sie dann ein HTC-API-Benutzer-Bearer-Token generieren. Dieses Bearer-Token dient dem Zugriff auf die restlichen HTC-APIs. Sie geben den Rescale-API-Schlüssel im Autorisierungsheader einer HTTPS-Anfrage wie folgt an, um ein Bearer-Token über die /auth/token/ Endpunkt:
curl -H „Autorisierung: Token ” https://htc.rescale.com/api/v1/auth/token
In der Nutzlast wird ein temporärer Tokenwert bereitgestellt. Dieser Token wird für alle nachfolgenden HTC-API-Zugriffe verwendet. Jeder Token läuft 6 Stunden nach der Ausgabe ab. Daher müssen nach Ablauf neue Token mit dem Rescale-API-Schlüssel abgerufen werden.
Um das Bearer-Token zur Authentifizierung von HTC-API-Aufrufen zu verwenden, geben Sie es im Header an:
curl -H „Autorisierung: Inhaber ” https://htc.rescale.com/api/v1/htc/…
Projekte verwalten
HTC-Projekte dienen der Verwaltung von Rechenleistung und Daten über mehrere Workloads hinweg. Projekte können erstellt, mit neuen verfügbaren Regionen und Limits aktualisiert und Dateien im Projektspeicher empfangen werden. Die verschiedenen projektbezogenen API-Endpunkte sind dokumentiert. werden auf dieser Seite erläutert.
Projekte werden von Arbeitsbereichsadministratoren erstellt und können im Allgemeinen nicht von HTC-Benutzern mit Administratorzugriff verwaltet werden.
Projektcontainer-Registrierungen
Jedes Projekt hat seine eigene ContainerEin Paket aus selbsterhaltenden Anwendungs- und Betriebssystemen ... Mehr Registrierung. Auf die Bilder in der Projektcontainerregistrierung greifen alle HTC-Jobs zu, die in Aufgaben dieses Projekts ausgeführt werden. Die Containerregistrierung ist praktisch der für dieses Projekt verfügbare Anwendungskatalog.
Ein Projekt kann mehrere Repositorys haben, wobei jedes Repository mehrere Container-Images enthalten kann, sofern diese über eindeutige Tags verfügen. Jobs geben den Repository-Namen und alle gewünschten Image-Tags in der Definition an, um festzulegen, welcher Container für einen Job ausgeführt werden soll.
Derzeit ist es nicht möglich, Container-Images in Registern projektübergreifend zu teilen.
Aufgaben verwalten
Eine HTC-Aufgabe enthält im Allgemeinen die Arbeitslast eines einzelnen Benutzers. Jeder Benutzer innerhalb eines Arbeitsbereichs kann Aufgaben in einem bestimmten Projekt erstellen, wie dokumentiert werden auf dieser Seite erläutert.
Auftragsübermittlung und -verwaltung
HTC-Jobs werden in „Batches“ an eine Aufgabe übermittelt, indem diese API-EndpunktJeder Job-Batch besteht aus den folgenden übergeordneten Komponenten:
Jobname: Der von diesem Auftragsstapel gemeinsam genutzte Name
BatchSize: Die Anzahl der Jobs in diesem Batch. Alle Jobs in einem Batch verwenden dieselbe Jobdefinition
htcJobDefinition: Alle Parameter, die für mehrere Jobs in diesem Stapel gemeinsam genutzt werden, bestehen aus Folgendem:
Bildname: Das zu verwendende Container-Image. Dies kann auch ein Tag für ein bestimmtes Container-Image-Repository enthalten.
maxVcpus: Die maximale Anzahl an vCPUs, die voraussichtlich von jedem Job verwendet werden
maxMemory: Die maximale Anzahl an MiB DRAM-Speicher, die jeder Job nutzen kann
maxDiskGiB: Die maximale Anzahl an GiB an temporärem Speicherplatz, die jeder Job nutzen kann
Befehle: Der Befehl, der ausgeführt werden soll, wenn der Container ausgeführt wird
execTimeoutSeconds: Die maximale Anzahl von Sekunden, die ein Container ausgeführt werden darf, bevor er zwangsweise beendet wird
ArchitekturDie für die Ausführung des Jobs verwendete CPU-Architektur; aktuell stehen X86 oder AARCH64 zur Verfügung.
Prioritätsliste: Ob die Jobs als On-Demand-Priorität oder On-Demand-Economy ausgeführt werden sollen