La prochaine opportunité de plus de 100 milliards de dollars dans le cloud computing et sa première application phare : le Deep Learning
Alors que nous entamons l’année 2017, l’industrie des logiciels d’entreprise est au point d’inflexion vers l’adoption omniprésente du cloud dans le cadre de la transformation du marché informatique d’entreprise de 4 6 milliards de dollars. Les raisons qui poussent l’informatique d’entreprise à adopter le cloud sont convaincantes, et nombreux sont ceux qui supposent que ce changement s’est déjà produit. Nous ne sommes cependant qu’au tout début de ce changement et son impact transforme fondamentalement tous les éléments de l’informatique. Les experts du secteur estiment que nous n’en sommes aujourd’hui qu’à environ XNUMX % de pénétration du cloud d’entreprise. [1. Tendances et avenir des infrastructures] La plupart des entreprises n’ont pas encore pris conscience de la pleine valeur de cette transformation. Il est clair que l’adoption du cloud dans les activités principales de l’entreprise par les acteurs de l’informatique matérielle et logicielle d’entreprise est fortement corrélée à l’amélioration des performances commerciales et de la valeur actionnariale.
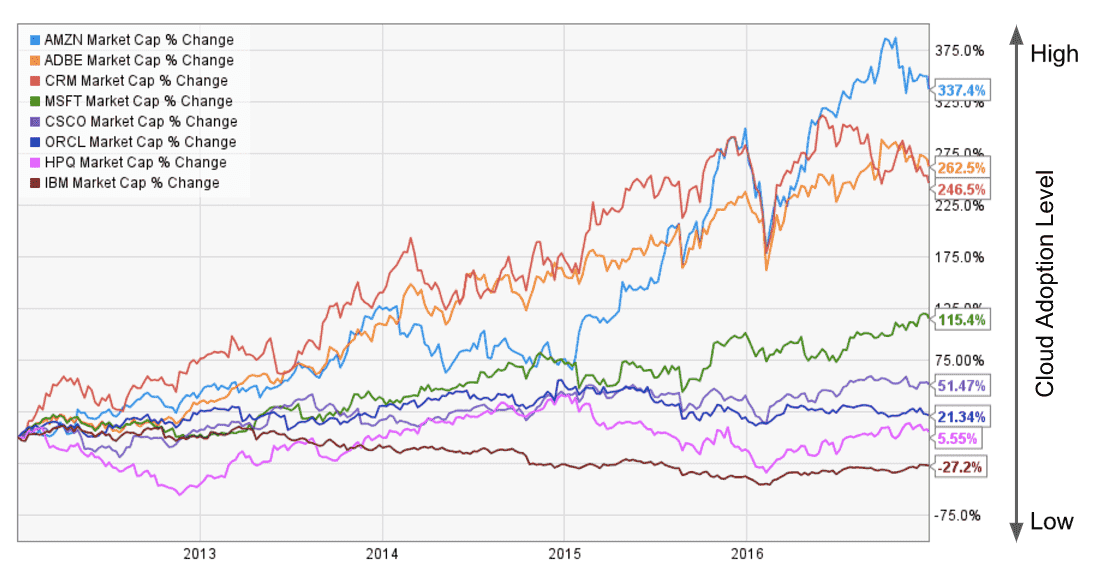
Par exemple, si l’on examine l’évolution de la capitalisation boursière au cours des cinq dernières années, les entreprises qui ont pleinement adopté le cloud (Amazon [AMZN], Adobe [ADBE], Salesforce [CRM]) ont connu un grand succès. De même, les entreprises qui ont récemment adopté le cloud (Microsoft (MSFT)) commencent à connaître une forte croissance récente et celles qui n'ont pas réussi à adopter ou à exécuter sur le cloud (Oracle [ORCL], HP [HPQ] et IBM [IBM]) sont du mal à créer davantage de valeur commerciale. Certes, il existe de nombreux autres facteurs de croissance de la capitalisation boursière de ces entreprises, mais le niveau de produits cloud, les modèles commerciaux et l'expertise ont été un facteur de réussite évident, tandis que la capacité cloud est désormais devenue un enjeu majeur pour chaque entreprise de logiciels d'entreprise.
Au cours de cette transition de plusieurs décennies vers l’adoption du cloud d’entreprise, plusieurs macro-phases importantes se déroulent, délivrant ensemble la promesse et la valeur commerciale du cloud dans l’entreprise. Les deux premières phases fondamentales sont le SaaS (Cloud 1.0) qui transforme la prestation et le modèle commercial, et le Big Data (Cloud 2.0) qui libère la valeur d'ensembles de données massifs. Le SaaS et le Big Data ont déjà chacun créé plus de 100 milliards de dollars de valeur dans l'entreprise. Aujourd’hui, le Big Compute, construit sur ces couches fondamentales critiques, est à un point d’inflexion et est sur le point de devenir le troisième.
Infrastructure cloud et infrastructure en tant que service (IaaS) constitue la couche sous-jacente essentielle permettant la transformation du cloud informatique d'entreprise. Amazon Web Services, Microsoft Azure et Google Cloud Platform ont ouvert la voie en fournissant l'épine dorsale technologique et infrastructurelle pour le SaaS, le Big Data et maintenant le Big Compute. Comme pour le SaaS et le Big Data, le Big Compute entraînera une rupture technologique ainsi qu'une nouvelle vague d'entreprises définissant les catégories pour saisir l'énorme opportunité dans cette nouvelle catégorie en petits groupes. En outre, les leaders actuels de la catégorie génèrent des milliards de dollars de revenus liés aux charges de travail lourdes dans le domaine du calcul haute performance sur site (HPC) le marché est confronté au dilemme de l'innovateur qui doit réinventer l'ensemble de son activité pour fournir des solutions Big Compute efficaces dans ce domaine, offrant ainsi une opportunité unique aux entreprises les plus innovantes de devenir leaders de leur catégorie.
Cloud 1.0 : SaaS
Transformation du business model et livraison de logiciels d’entreprise
Les entreprises SaaS natives telles que Salesforce, NetSuite et Journée de travail ont construit des solutions SaaS de référence et de pointe pour le CRM, l'ERP et les RH, respectivement, grâce à l'innovation du modèle commercial et à la fourniture de logiciels sans friction. Ces leaders du SaaS ont exploité le cloud pour bouleverser les acteurs traditionnels qui dominent historiquement ces catégories de logiciels d'entreprise.
Les acteurs historiques ont également eu l’opportunité de réinventer leur activité et de mettre en œuvre le SaaS pour leur gamme de produits. Par exemple, Adobe a réinventé sa stratégie et a réussi à transformer son organisation en leader du SaaS. Même sous les contraintes liées à son fonctionnement en tant qu'entreprise publique, Adobe a réussi à passer d'un logiciel sur site existant à un modèle d'abonnement et de livraison SaaS dans le cloud.
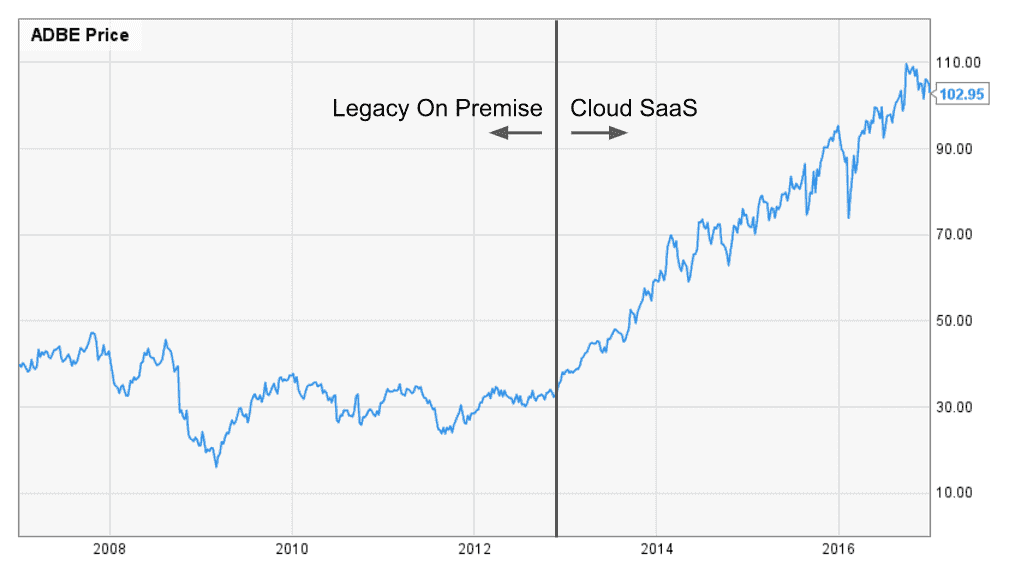
Adobe a fait évoluer le modèle économique de sa gamme de produits phare, passant d'une licence annuelle de 2,500 50 $ à un abonnement mensuel de 100 à XNUMX $/mois..[4. Adobe tue Creative Suite et passe uniquement par abonnement] L'équipe produit a également transformé le modèle de livraison de son logiciel en une solution basée sur un navigateur avec des mises à jour continues. Pour faire court, les clients étaient ravis. Tout en sacrifiant des revenus significatifs à court terme, Adobe a créé beaucoup plus de valeur future. Avec la transformation SaaS, Adobe a élargi ses opportunités de marché en démontrant un attrait plus large sur le marché et une volonté de payer accrue grâce à une meilleure valeur client, ainsi qu'une capacité essentielle à capter cette valeur sur le long terme.
Cloud 2.0 : Mégadonnées
Activation de la mise à l'échelle et de la connectivité pour la couche de données full-stack
À mesure que l'infrastructure cloud mûrissait pour soutenir la croissance rapide des entreprises SaaS, l'infrastructure en tant que service (IaaS) fournissait une couche fondamentale de stockage et de bases de données évolutives et omniprésentes. Cette vaste capacité d'infrastructure a permis une innovation spectaculaire au niveau de la couche de données et stimule le Big Data la transformation.
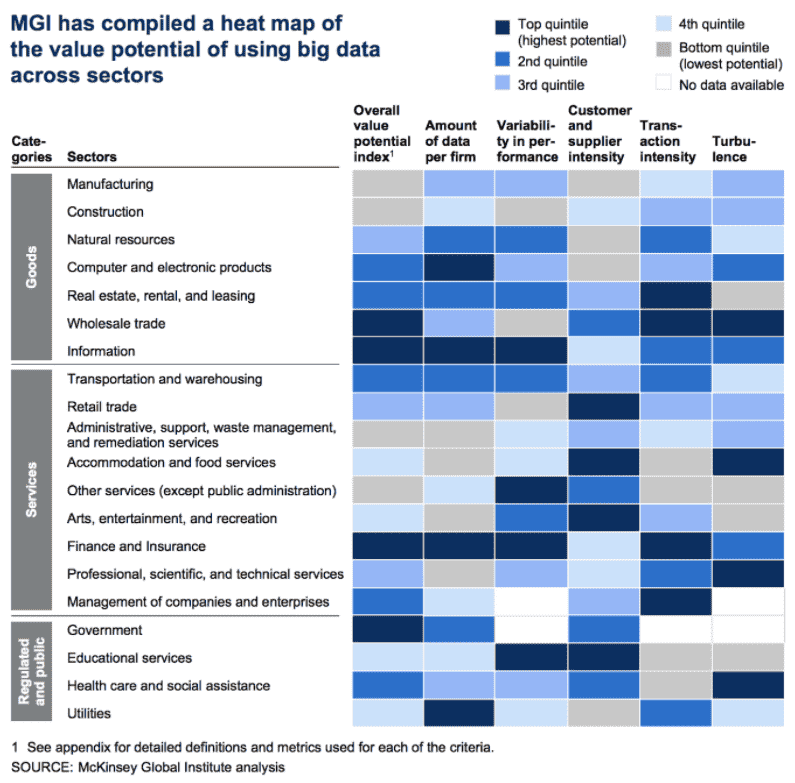
Leaders dans la catégorie Big Data tels que Splunk, Cloudera et Palantir ont transformé notre capacité à extraire des informations du passé en mettant à l'échelle, en manipulant et en connectant des ensembles de données d'entreprise. À un niveau de base, Splunk offre la possibilité d'exploiter des informations à partir de journaux d'applications d'entreprise volumineux et disparates, Cloudera est passé au niveau supérieur avec la possibilité de déployer des clusters de stockage et de traitement distribués pour l'entreprise, et enfin Palantir a développé des piles propriétaires pour se connecter. ensembles de données cloisonnés et non structurés dans les secteurs public et privé. Fondamentalement, le Big Data est une capacité horizontale qui peut être appliquée dans toute l’entreprise pour extraire des informations à partir d’ensembles de données existants.
Cloud 3.0 : le gros calcul
Mise à l'échelle et activation de la charge de travail pour la couche de calcul full-stack
Le Big Compute est le prochain changement transformationnel pour le cloud computing d'entreprise. Tout comme le Big Data a supprimé les contraintes sur les données et transformé les principales catégories de logiciels d'entreprise, le Big Compute élimine les contraintes sur le matériel de calcul et offre la possibilité d'adapter les charges de travail de calcul de manière transparente sur des configurations d'infrastructure optimisées pour les charges de travail, sans sacrifier les performances.
Idée fausse du « superordinateur dans votre poche »
La loi de Moore et le cloud computing IaaS ont donné l’impression que « tout le monde a un superordinateur dans sa poche » et que la puissance de calcul omniprésente est universellement accessible à tous. Cependant, alors que les capacités de calcul ont augmenté à un rythme exponentiel et sont devenues beaucoup plus accessibles, les exigences informatiques pour les applications ont également augmenté considérablement pour répondre à la demande insatiable d'algorithmes complexes de nouvelle génération. En fait, le « superordinateur dans votre poche » de l’iPhone est en réalité un superordinateur datant d’il y a plus de 25 ans.,[6. Comparaison de la puissance de traitement] et dans le même temps, les besoins informatiques de l'écosystème logiciel ont augmenté à un rythme égal ou supérieur à la loi de Moore.
De nombreux problèmes et innovations critiques d’entreprise sont encore liés au calcul
Malgré la croyance populaire, bon nombre des problèmes logiciels les plus complexes au monde restent liés au calcul. Depuis l'avènement des logiciels d'entreprise, les limitations de calcul ont fortement limité à la fois les applications et la portée du travail en raison des dépenses de plusieurs millions de dollars et de l'expertise requise pour la mise en œuvre de superordinateurs et de systèmes informatiques hautes performances dans l'entreprise.
Le calcul haute performance est largement utilisé dans la plupart des grandes entreprises du Fortune 500, y compris dans des secteurs verticaux tels que l'aérospatiale, l'automobile, l'énergie, les sciences de la vie et les semi-conducteurs. Dans presque tous ces secteurs verticaux, les entreprises sont confrontées à des contraintes importantes en matière de capacité de calcul. Par exemple, dans la conception aérospatiale, les problèmes à grande échelle ont une dynamique des fluides computationnelle complexe (CFD) des algorithmes dont la résolution peut prendre des jours ou des semaines sur de grands clusters de calcul haute performance. Dans l'analyse de simulation d'essais de collision automobile, la mise à l'échelle Analyse des éléments finis (FEA) la physique à des millions de composants et d'interactions crée un énorme problème informatique. Et dans les sciences de la vie, les exigences informatiques massives de la dynamique moléculaire (MD) la simulation restreint la découverte informatique de médicaments, l'une des plus grandes opportunités de perturbation pour les sociétés pharmaceutiques.
Les innovations en matière de cloud computing telles que le SaaS, le Big Data et l'IaaS sont les éléments constitutifs de la catégorie Big Compute. Une pile Big Compute complète permet désormais une mise à l'échelle sans friction, une spécialisation du matériel informatique centrée sur les applications et des charges de travail optimisées en termes de performances de manière transparente pour les développeurs de logiciels et les utilisateurs finaux. Plus précisément, Big Compute transforme un large ensemble de services logiciels complets au-dessus du matériel spécialisé en une couche définie par logiciel, qui met à portée de main des capacités de calcul programmatique hautes performances, ou plus probablement, en tant qu'évaluations de fonctions back-end faisant partie du logiciel. vous touchez tous les jours. Cette approche renverse l'approche traditionnelle d'un cluster de calcul unique pour un large ensemble d'applications, en une solution à la carte où les charges de travail de calcul sont profilées et déployées sur une solution matérielle spécialisée optimale pour des besoins personnalisés. à la charge de travail. Big Compute transforme un cluster homogène plein de compromis en termes de performances et de coûts en une solution hétérogène sans compromis.
Fragmentation matérielle et spécialisation permettant le Big Compute
Big Compute est une technologie horizontale qui permet aux entreprises de faire évoluer des algorithmes et des charges de travail complexes sur une infrastructure informatique flexible et spécialisée. Une infrastructure de calcul spécialisée est un élément essentiel du succès, car il existe un écart de performances de plusieurs ampleurs entre l'infrastructure de base et les serveurs spécialisés. De nombreux composants des serveurs peuvent être spécialisés, tels que les processeurs, la mise en réseau, la mémoire, le stockage, etc. Le Big Compute démocratise l'accès à ce niveau de matériel spécialisé d'un point de vue défini par logiciel, permettant ainsi de faire tourner un ordinateur. Un cluster de calcul haute performance de 10 millions de dollars pour seulement quelques milliers de dollars par heure et intégrer cette capacité dans n'importe quelle application logicielle d'entreprise tout en répondant, surtout, aux attentes de performances de pointe pour les applications haut de gamme.
Au sein du centre de données, il existe de nombreux domaines de réglage et d'optimisation, depuis les racks physiques jusqu'à la mise en réseau et jusqu'aux composants spécifiques du serveur. Par exemple, il existe déjà un large éventail de capacités de processeurs qui se fragmentent à un rythme croissant. Les capacités spécialisées de ces processeurs sont essentielles pour les charges de travail spécifiques du Big Compute qui doivent être mappées aux bonnes architectures, en fonction de leurs algorithmes et de leur implémentation.
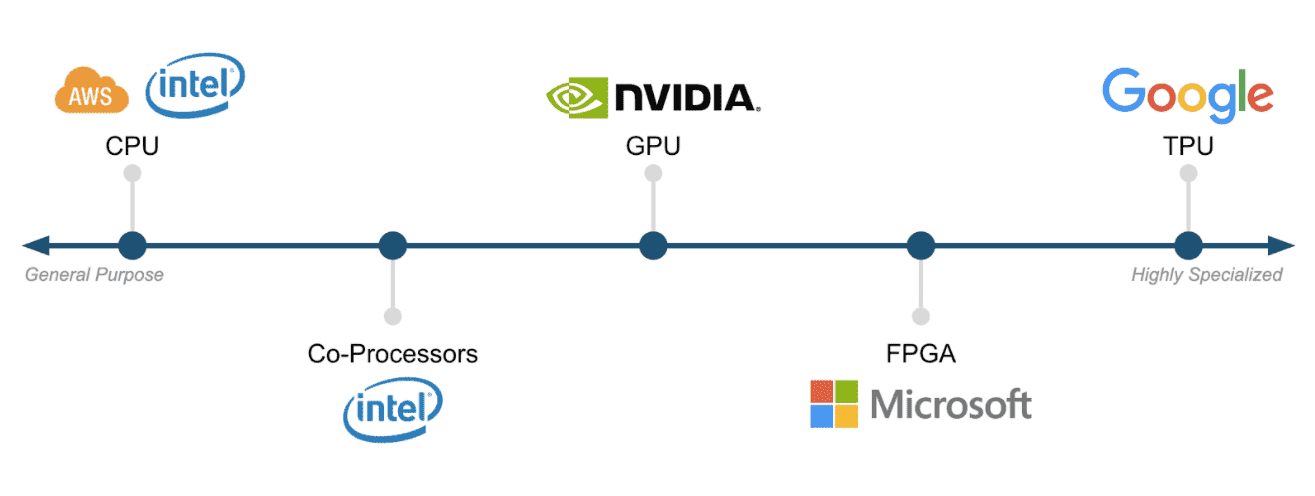
Big Compute permet aux utilisateurs, aux applications logicielles et aux algorithmes de tirer parti de ces fonctionnalités de manière transparente sans avoir besoin de comprendre ou de déployer le middleware et les bibliothèques requis. Cela accélère le cycle d’adoption et le déploiement de capacités matérielles spécialisées dans les IaaS et les centres de données, mais permet surtout de créer une nouvelle catégorie spectaculaire d’applications et d’outils logiciels d’entreprise Big Compute.
Fondamentalement, le Big Compute fournit la couche de calcul défini par logiciel qui permet une approche de calcul plus centrée sur les applications dans l'entreprise, apportant une optimisation et une évolutivité transparentes de la pile, tout en démocratisant à terme la capacité du Big Compute auprès des développeurs et des utilisateurs finaux. Cette capacité entraîne une transformation radicale au sein de l'entreprise, passant d'équipes multidisciplinaires d'experts hautement qualifiés en matériel, middleware et algorithmes logiciels spécifiques à un domaine soutenus par d'importants investissements en ressources informatiques, à un service transparent qui permet à l'utilisateur moyen l'utilisateur d'entreprise de se concentrer sur la couche d'application tout en s'appuyant sur une couche Big Compute très complexe mais transparente pour l'exécution. Cette transformation permet aux organisations de passer à un niveau d'abstraction supérieur, depuis la formulation de charges de travail pour répondre aux capacités matérielles sous-jacentes, jusqu'à la résolution de problèmes de niveau supérieur sans aucune contrainte de calcul.
L'essor du Big Compute ne constitue pas seulement une nouvelle fonctionnalité fondamentale pour toutes les applications logicielles d'entreprise, mais il offre également la possibilité de passer d'une analyse rétrospective (comme c'est généralement le cas pour le Big Data) à des analyses et simulations prospectives pour générer des informations prédictives. et les prédictions des états futurs. En fait, le Big Compute peut fournir des simulations qui génèrent des ensembles de données qui exploitent les outils Big Data pour évaluer la qualité potentielle d'un état futur généré par une simulation. Un processus asynchrone fonctionnera pour les problèmes les plus importants, mais il évoluera vers le temps réel, où la pile Big Compute pourra traiter plus rapidement que le temps de réponse requis. Par exemple, dans la formation Deep Learning (asynchrone) et l'inférence (en temps réel), toutes deux exécutées sur une pile de fonctionnalités Big Compute locales en périphérie, ou centralisées dans le cloud si les latences le permettent.
Deep Learning, la première application qui tue le Big Compute
La première véritable percée dans le Big Compute a été la catégorie des l'apprentissage en profondeur logiciel. L'apprentissage profond est un sous-ensemble d'algorithmes d'apprentissage automatique qui nécessite des calculs massivement parallèles et convient donc parfaitement au matériel GPU, historiquement conçu pour le traitement de threads graphiques parallèles. Les algorithmes d'apprentissage profond existent depuis des décennies, mais leur succès récent est attribuable au matériel GPU hautement spécialisé adapté à cette charge de travail ainsi qu'à la capacité de créer une solution full-stack clé en main sur laquelle les algorithmes logiciels fonctionnent sans avoir besoin d'être un expert en la matière. la mise en œuvre, la parallélisation et l'orchestration des algorithmes sur le matériel spécialisé.
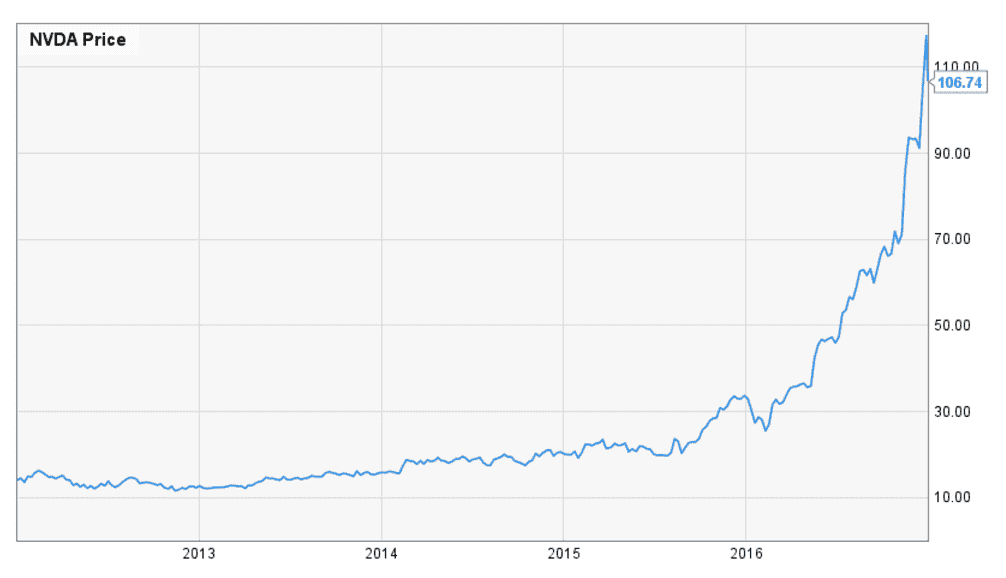
Les outils de Deep Learning sont désormais reconnus comme une solution horizontale incontournable pour l’entreprise. Ces outils fournissent des capacités d'analyse, d'informations et de renseignement qui étaient auparavant inaccessibles sans des investissements massifs et une expertise dans l'ensemble de la pile, mais sont désormais universellement accessibles grâce à une pile Big Compute composée de matériel spécialisé, de middleware et d'algorithmes intégrés. Ces algorithmes d'apprentissage automatique sont désormais universellement accessibles sur la dernière génération de GPU évolutifs spécialisés et peuvent rapidement être mis en œuvre en tant que solution pour compléter les capacités logicielles existantes avec une intelligence algorithmique dans toute l'entreprise, améliorant ainsi les capacités internes. En tant que leader sur le marché des GPU, NVIDIA a « vendu des pioches pendant une ruée vers l’or » et a connu une croissance et une adoption considérables alimentées par la couche Big Compute, rendant ces capacités matérielles spécialisées rapidement et facilement accessibles à toute personne souhaitant utiliser des outils d’apprentissage en profondeur.
Google (Alphabet) considère le deep learning comme une capacité fondamentale pour rester le leader en matière de recherche. Il a été considéré comme si essentiel à leurs efforts de recherche et de développement qu'ils ont mis en œuvre le TensorFlow algorithme de manière générale dans leur vaste portefeuille d’activités sans rapport avec la recherche. Tellement instrumental qu'ils ont même développé leur propre puce Tensor Processing Unit (TPU) personnalisée pour accélérer les performances à des niveaux impossibles à atteindre avec les chipsets standard. Cela illustre clairement l’importance cruciale du matériel spécialisé dans la pile Big Compute pour des performances algorithmiques optimales afin de générer de nouvelles capacités et l’innovation.
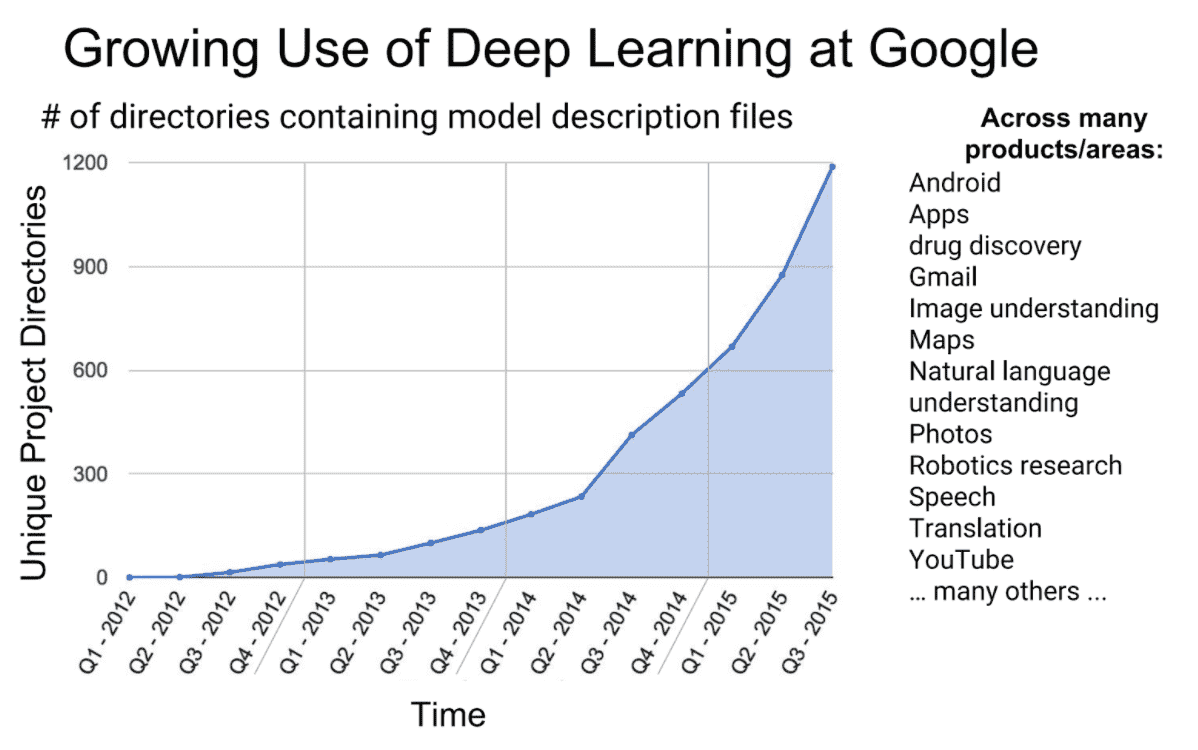
Au début de l’année 2017, l’apprentissage profond est probablement au sommet de son cycle de battage médiatique, mais une valeur fondamentale à long terme est clairement créée. Au minimum, l’apprentissage profond crée de la valeur en tant que processus back-end permettant d’optimiser des situations très complexes dans lesquelles les ensembles de données sont trop volumineux pour les algorithmes déterministes. Par exemple, il est probable que Google ait récupéré son acquisition de DeepMind pour 500 millions de dollars grâce à une seule implémentation de ses outils d'apprentissage automatique pour améliorer le refroidissement de son centre de données.[9. DeepMind AI réduit la facture de refroidissement de Google Data Center de 40%] Il est également probable que l'apprentissage profond offrira de nouvelles capacités et accélérera l'innovation dans les domaines de la conduite autonome, de la découverte de médicaments, de l'imagerie médicale, de la robotique et de nombreux autres domaines passionnants. Le Deep Learning n’est qu’une seule catégorie d’applications logicielles alimentée et activée par la pile Big Compute.
La nouvelle pile Big Compute
La pile Big Compute est la couche critique permettant d'apporter les fonctionnalités Big Compute à n'importe quelle application logicielle et de gérer la complexité des frais de gestion afin d'exécuter de manière transparente les charges de travail sur une large sélection d'infrastructures spécialisées. Il existe des catégories d'applications entièrement nouvelles qui n'ont pas encore été déverrouillées avec la pile Big Compute et, comme pour l'apprentissage en profondeur, les algorithmes ont été historiquement liés au calcul, nécessitant du matériel spécialisé, un middleware complexe, ainsi qu'un réglage et une optimisation complets de la pile pour devenir commercialement viable pour l’entreprise.
Le Big Compute a le potentiel d’avoir un impact fondamental bien plus important sur l’ensemble du paysage économique, au-delà de celui qu’a déjà le Big Data. Non seulement le Big Compute apportera les capacités de calcul et algorithmiques nécessaires pour amplifier la puissance et l’impact des outils d’analyse du Big Data, mais le Big Compute entraînera également une toute nouvelle catégorie de fonctionnalités qui n’étaient pas possibles auparavant.
Le succès de l’apprentissage profond en tant que première application phare du Big Compute signale une inflexion vers une utilisation exponentiellement plus grande de l’informatique spécialisée à grande échelle. Comme pour le Big Data, les capacités de la pile Big Compute seront indispensables dans l’entreprise.
Chez Rescale, nous pensons que le Big Compute est la base sur laquelle les nouvelles innovations futures seront construites – pilotées par des algorithmes et des logiciels qui ont été historiquement fortement contraints par une expertise approfondie et un investissement initial important, mais qui ont maintenant été libérés avec la pile Big Compute. Nous construisons la plate-forme universelle pour apporter les capacités Big Compute à l'entreprise – une capacité essentielle qui, selon nous, sera nécessaire pour piloter la plupart des nouvelles innovations majeures dans les principales entreprises Fortune 500 dans tous les secteurs verticaux. De l'exploration spatiale aux véhicules électriques en passant par la découverte informatique de médicaments, nous travaillons avec les leaders des industries qui mettent en œuvre la pile Big Compute comme avantage concurrentiel dans leurs secteurs verticaux respectifs.
L’essor du Big Compute débloquera un large spectre d’innovation et une valeur commerciale incroyable dans l’entreprise, auparavant limitée par la capacité matérielle spécialisée, l’accessibilité et l’évolutivité. Alors que les derniers utilisateurs des capacités de Big Compute seront confrontés à une concurrence plus rude pour des capacités indifférenciées, les premiers dirigeants trouvent l'occasion unique de tirer parti de l'expertise interne existante et des compétences de base de leur organisation et de les doter de capacités de Big Compute pour créer les innovations futures qui transformeront notre société. monde.
Nous attendons avec impatience une année très excitante de Big Compute en 2017 et au-delà !
-Joris Poort, PDG, Rescale
Voir la vidéo de la Rescale Night à San Francisco ! S'inscrire pour la communauté Big Compute.
Apprendre encore plus à propos de Rescale. Suivez-nous sur LinkedIn, Twitter, Facebook et YouTube.