Comment augmenter les performances HPC tout en réduisant les coûts et la consommation d'énergie
Calcul haute performance est désormais la pierre angulaire de la recherche et de l’ingénierie modernes. Les organisations de tous les secteurs se tournent vers la modélisation et les simulations numériques pour raccourcir les cycles de développement de produits. En particulier en ingénierie, automatisation de la conception électronique (EDA) et l’expansion rapide de l’Internet industriel des objets (IIoT) stimulent la demande de HPC.
Alors que les entreprises se tournent vers le HPC pour des simulations et d’autres tâches de plus en plus complexes, elles doivent également continuer à contrôler les coûts et à réduire la consommation d’énergie.
Qu'est-ce que le calcul haute performance (HPC) ?
Par rapport à l’informatique générale, le HPC offre un débit plus élevé pour traiter des problèmes informatiques complexes à des vitesses extrêmement élevées. Systèmes HPC comprennent trois composants principaux : le calcul, le réseau et le stockage. Ils regroupent la puissance de calcul grâce à un traitement massivement parallèle.
Les clusters HPC sont constitués d'un grand nombre de serveurs connectés en réseau. Chaque ordinateur composant est considéré comme un « nœud ». Les systèmes HPC contiennent souvent de 16 à 64 nœuds avec deux processeurs par nœud.
Le besoin en calcul haute performance est motivé par les logiciels de plus en plus sophistiqués d'aujourd'hui et par les ensembles de données massifs utilisés dans les simulations et les analyses. Ce logiciel est utilisé pour améliorer les performances des produits dans diverses disciplines, notamment l'aérodynamique des avions, la conduite autonome, la découverte de médicaments et la modélisation météorologique. Par exemple, les applications logicielles de simulation de Ansys, Siemens, Dassault et Sciences convergentes s'appuyer sur des architectures HPC spécialisées pour effectuer Dynamique des fluides computationnelle pour le développement d'avions commerciaux, d'avions militaires et d'engins spatiaux. Les organisations de R&D maintiennent également généralement larges portefeuilles d'applications, y compris ceux commerciaux, open source et ceux avec des codes développés en interne. S'assurer qu'ils fonctionnent efficacement sur Infrastructure HPC est un défi, car ils ont tous des besoins différents. Dans le même temps, le paysage des éditeurs de logiciels indépendants (ISV) continue de s'étendre, compliquant encore davantage la manière dont les organisations doivent prendre en charge l'utilisation de logiciels de R&D avancés.
Clusters HPC spécialisés
HPC tire parti des clusters HPC spécialisés pour optimiser les flux de travail pour des types spécifiques d'applications et de charges de travail.
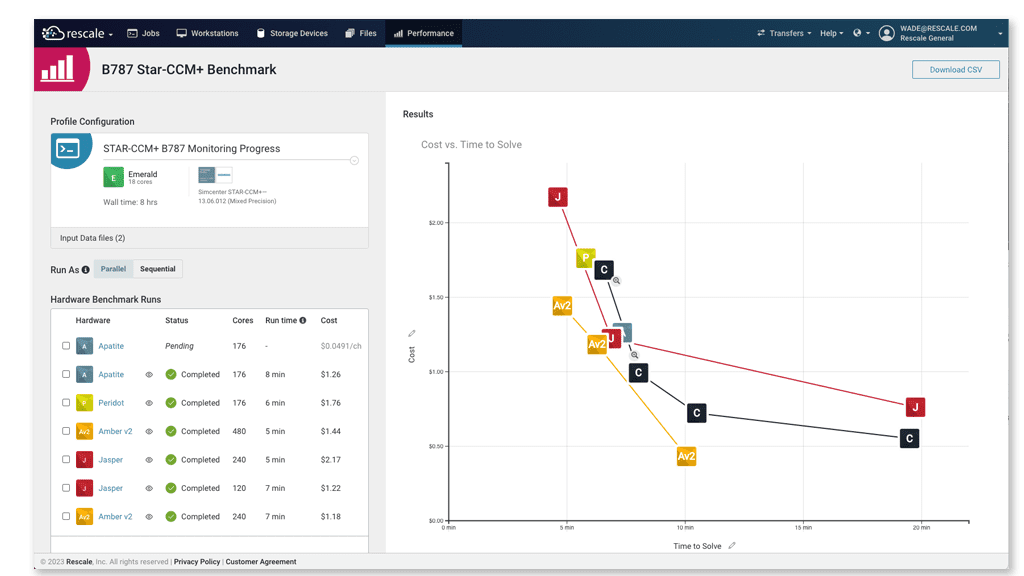
Certaines tâches nécessitent davantage de communication entre les nœuds, ainsi que du matériel et des logiciels spécialisés. Les exigences de calcul d'une charge de travail donnée déterminent le nombre de nœuds nécessaires dans le cluster. Certains logiciels et tâches informatiques fonctionnent également mieux avec certains types de puces semi-conductrices. Un outil d'évaluation comparative automatisé comme Redimensionner les profils de performances peut être incroyablement utile pour faire correspondre la meilleure architecture de puce à une tâche informatique donnée.
Une interconnexion hautes performances pour les clusters répond au besoin de faible latence et de faible bande passante. Il suit la charge de travail et la réachemine si nécessaire. Une façon de gérer de grands ensembles de données consiste à empaqueter des applications HPC et à les exécuter sur plusieurs clusters. Un gestionnaire de cluster exécute des vérifications de capacité et d'état pour rechercher et utiliser les ressources disponibles.
La conteneurisation
Certaines organisations abordent également la gestion des charges de travail HPC avec des conteneurs optimisés pour le GPU, qui sont de plus en plus répandus avec les déploiements d'IA. Apptainer open source (Singularity) est le système de conteneurs le plus largement utilisé pour le HPC. Shifter et Docker sont d'autres options. Ils permettent l’intégration transparente des principales applications d’IA. Les applications conteneurisées augmentent la portabilité, rendant possible l'utilisation d'applications internes et commerciales depuis n'importe où.
La virtualisation est une alternative à la conteneurisation. Il génère un environnement virtuel au-dessus du système d'exploitation hôte. Les machines virtuelles (VM) sont programmées avec leurs propres systèmes d'exploitation, permettant une isolation complète les unes des autres. Hyper-V, vSphere et OpenStack en sont quelques exemples.
Pourquoi le HPC est-il important ?
Le HPC fournit des informations et des analyses critiques en beaucoup moins de temps que l'informatique traditionnelle. La rapidité du HPC offre des avantages à de nombreux rôles, des ingénieurs et data scientists aux concepteurs de produits et chercheurs.
Cela amène également la modélisation et la simulation (M&S) à un tout autre niveau. Par exemple, les modèles à plus haute résolution fournissent des informations plus granulaires sur un nouveau produit, ce qui réduit ou élimine le besoin de prototypes et de tests réels. Pensez aux simulations d'accidents automobiles plutôt qu'aux véritables crash-tests, ou à la formation des pilotes sur des simulateurs de vol plutôt que dans de vrais avions.
Avec le cloud HPC, un large éventail d'entreprises peuvent rapidement faire évoluer leurs besoins informatiques à la demande.
Certains exemples sont:
- Firmes d'ingénierie
- Laboratoires de recherche
- Technologie financière (fintech)
- Développement produit
- Gouvernement et défense
Même les startups et les petites entreprises peuvent profiter du Cloud HPC hautement évolutif.
Comprendre les performances HPC
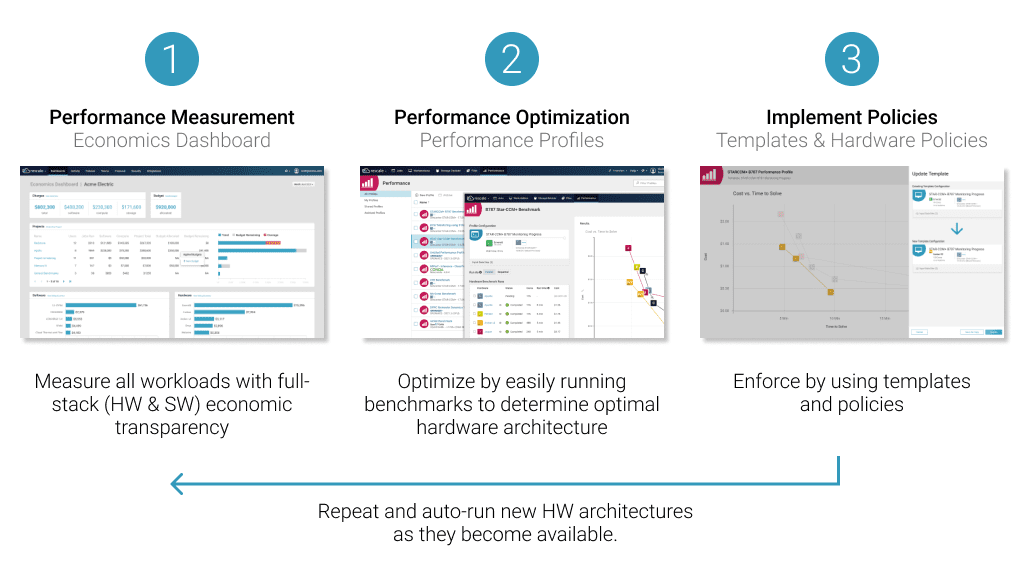
L'optimisation HPC répond aux complexités liées à la fourniture de la bonne architecture informatique pour une charge de travail donnée. C’est également essentiel pour rendre les systèmes plus économes en énergie. Une charge de travail HPC est une tâche gourmande en données répartie sur des ressources système situées sur site ou dans le cloud.
Les systèmes HPC d'aujourd'hui peuvent gérer des charges de travail incroyables, notamment l'IA, l'apprentissage automatique et l'apprentissage profond. Ils exécutent des millions de scénarios simultanément tout en traitant d’énormes quantités de données.
Indicateurs de performance clés
Les analystes mesurent la puissance des systèmes HPC en flops par seconde. À l'heure actuelle, la machine Frontier du laboratoire national d'Oak Ridge se trouve au sommet du TOP500 liste des supercalculateurs les plus puissants, délivrant 1.102 Eflop/s (un exaflop équivaut à un quintillion de calculs).
Une autre mesure clé est efficacité d'utilisation de l'énergie (PUE), qui détermine l'efficacité énergétique de l'ensemble du centre de données. Vous pouvez calculer le PUE en divisant la puissance totale entrant dans un centre de données par la puissance utilisée pour faire fonctionner tous les équipements informatiques. Plus le nombre est proche de 1.0, meilleure est l’efficacité globale. Une autre norme d'analyse comparative est efficacité de l'infrastructure du centre de données (DCiE). Cette mesure d'efficacité énergétique est calculée en divisant la puissance de l'équipement informatique par la puissance totale de l'installation.
Enfin, les mesures sont importantes, mais seulement jusqu'à un certain point. En fin de compte, les utilisateurs se soucient avant tout des performances réelles qui permettent à leurs tâches de calcul de s'exécuter plus rapidement. Il peut être difficile d'évaluer pleinement les performances HPC pour tous les types de logiciels et de charges de travail. Certains types de puces semi-conductrices fonctionnent mieux sur certains types de logiciels que sur d’autres.
Goulots d'étranglement informatiques
Pour certaines entreprises, l’infrastructure sur site constitue en soi un goulot d’étranglement. Ce type d'investissement dans les infrastructures est généralement calculé pour une utilisation à 100 %, de sorte que la demande instantanée dépasse l'offre, il y a un goulot d'étranglement car il n'y a plus de capacité. En comparaison, le Cloud HPC est élastique et évolue en fonction de l’évolution des besoins. Les organisations peuvent simplement s'abonner pour bénéficier de plus de puissance de calcul. En conséquence, le HPC dans le cloud permet une utilisation complète sans se heurter aux contraintes de capacité plafonnée.
De nombreux autres goulots d'étranglement potentiels existent au sein des systèmes HPC, notamment la capacité de mémoire, le débit d'E/S et la vitesse/capacité de stockage. Les cœurs de processeur, la vitesse d'horloge ou la mise en cache peuvent également limiter les performances, tandis que d'autres inhibiteurs peuvent inclure la bande passante du commutateur réseau.
La capacité de mémoire est un autre problème, car des taux de transfert de données plus élevés nécessitent davantage de mémoire pour la mise en mémoire tampon et le stockage. La mémoire DDR3, DDR4 et même DDR5 traditionnelle peut devenir un goulot d'étranglement. Cependant, la mémoire à large bande passante (HBM) est une solution possible, car elle offre huit fois la bande passante de la mémoire DDR5.
Pour éviter les goulots d'étranglement, il est également important d'aligner les spécifications logicielles sur les configurations HPC qui optimisent les performances.
Efficacité énergétique HPC
L'efficacité énergétique des systèmes HPC, mesurée en flops par watt, continue de s'améliorer. Un exemple en est le Henri système au Flatiron Institute de New York, avec un score d'efficacité de 65.09 GFlops/Watts.
Les opérateurs de centres de données continuent d’améliorer l’efficacité énergétique de diverses manières. Par exemple, les chipsets de nouvelle génération à faible consommation réduisent la consommation d’énergie et dissipent mieux la chaleur. Les cœurs IP optimisés en termes de puissance réduisent également la consommation d'énergie et le transport de données via mémoire à large bande passante. Certains opérateurs se sont tournés vers des méthodes alternatives de durabilité, comme refroidissement par liquide et recyclage de la chaleur.
Les centres de données se tournent de plus en plus vers sources d'énergie renouvelables comme l’hydroélectricité, l’éolien, le solaire, la biomasse et l’hydrogène vert. Des progrès significatifs sont réalisés, comme en témoigne le fait que la consommation électrique des centres de données s'est stabilisée à 191 térawattheures entre 2015 et 2021. Cependant, des migrations ponctuelles depuis les centres de données sur site ont quelque peu masqué la croissance globale de la demande HPC.
Répondre à la demande de calcul HPC
Pour répondre à la demande, l’industrie répond avec des machines plus puissantes que jamais. Les systèmes passent d’une capacité pétaflopique à une capacité exaflopique et au-delà. Un superordinateur doté d’une capacité exaflopique a besoin d’une seconde pour effectuer un quintillion de calculs. Il faudrait plus que 31 milliards d'années pour effectuer ce nombre de calculs avec un seul calcul par seconde.
Les innovations visant à accroître l’efficacité du HPC incluent de nouvelles architectures et de nouveaux matériels. Par exemple, la connectivité 3DIC et die-to-die répond aux dernières exigences de performances. Et une commutation plus flexible est possible lorsque les FPGA, GPU, CPU et autres architectures de traitement sont intégrés dans un seul nœud.
Le nouveau matériel favorise souvent le HPC basé sur le cloud. Par conséquent, les centres de données sur site existants ne peuvent pas toujours profiter de chipsets plus économes en énergie. La migration vers le cloud est un moyen de répondre efficacement à la demande croissante de vitesse, d'évolutivité et de durabilité.
Cependant, une simple migration « lift and shift » du système sur site vers le cloud ne répond pas toujours aux besoins émergents en HPC d'une entreprise. Parfois, l'infrastructure existante ne peut pas répondre aux besoins changeants de l'entreprise, car il s'agit généralement d'un cycle de rafraîchissement de quatre à cinq ans. Un cycle aussi long ne peut pas suivre les changements rapides de l’écosystème HPC. L’adoption du cloud offre également un degré relativement élevé de flexibilité financière. Transition des modèles de coûts HPC d’entreprise du long terme CapEx aux OpEx à plus court terme. Ils n’mobilisent pas autant de capital et peuvent mieux adapter les différents modèles de coûts Cloud HPC aux besoins actuels.
Points clés à retenir
Pour ceux qui disposent de centres de données sur site, la migration vers le cloud est un moyen important d'augmenter l'efficacité énergétique tout en réduisant les coûts. Le Cloud HPC offre aux entreprises de toutes tailles un moyen de bénéficier des dernières avancées technologiques.
L'optimisation des performances HPC nécessite un alignement entre les spécifications logicielles et le matériel disponible. De plus, les clusters HPC spécialisés et la conteneurisation peuvent également augmenter les performances HPC et l'efficacité énergétique.
À mesure que l’utilisation de l’IA se répand, les systèmes HPC deviendront encore plus économes en énergie.
En savoir plus sur Rescale
Découvrez comment Rescale peut aider votre organisation à contrôler les coûts tout en favorisant une plus grande innovation. Avec Profils de performance, il est facile d'identifier la meilleure architecture cloud HPC pour vos besoins.
Apprenez-en davantage dans notre webinaire à la demande « Optimisez le coût et les performances des charges de travail dans le cloud. »