Aujourd'hui, nous allons discuter de la façon d'utiliser plusieurs GPU pour former un seul réseau neuronal à l'aide du Torche bibliothèque d'apprentissage automatique. Il s'agit du premier d'une série d'articles sur les techniques permettant d'augmenter les charges de travail de formation des réseaux neuronaux profonds (DNN) afin d'utiliser plusieurs GPU et plusieurs nœuds.
Dans cette série, nous nous concentrerons sur la parallélisation de la formation d'un réseau unique. Pour en savoir plus sur le problème parallèle embarrassant de la formation efficace de plusieurs réseaux pour optimiser les paramètres de configuration, voir ce post précédent sur l'optimisation des hyper-paramètres.
À propos de Torche
Torch est une bibliothèque de tenseurs légère et flexible construite sur le langage de programmation Lua. Torch est populaire auprès des chercheurs en apprentissage automatique, c'est pourquoi de nombreuses nouvelles idées de réseaux neuronaux profonds sont d'abord implémentées dans Torch et mises à disposition sous forme d'extensions open source. Ainsi, l’état de l’art en matière d’apprentissage profond est souvent disponible pour la première fois dans Torch.
L'inconvénient est que la documentation de Torch est souvent en retard sur la mise en œuvre, donc à moins que vous ne trouviez un exemple sur github pour exactement ce que vous voulez faire, il peut être difficile de déterminer quels modules Torch vous devriez utiliser et comment les utiliser.
Un exemple de ceci est de savoir comment demander à Torch d'entraîner vos réseaux de neurones à l'aide de plusieurs GPU. La recherche de « multi gpu torch » sur Internet donne des résultats ce problème de github comme l'un des meilleurs résultats. À partir de là, nous savons que nous pouvons accéder à plus d’un GPU à partir de l’environnement Torch, mais comment utiliser cette construction de bas niveau pour former un réseau complexe ?
Parallélisme entre données et modèles
Lors de la parallélisation du travail de formation d'un seul réseau neuronal, nous avons 2 choix sur la façon de diviser le travail : le parallélisme des modèles et le parallélisme des données.
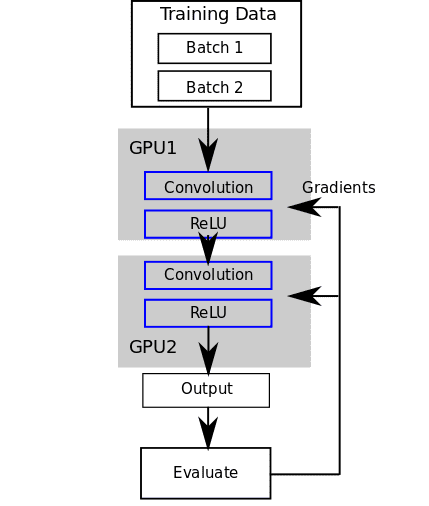
Avec le parallélisme modèle, chaque GPU exécute une partie des nœuds du réseau pour un lot de données donné.
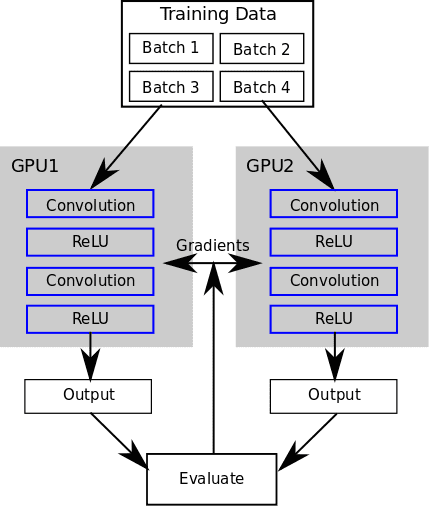
Avec le parallélisme des données, chaque GPU gère l'ensemble du réseau pour différents lots de données.
Cette distinction est discutée en détail Dans cet article, mais le choix entre utiliser l’un ou l’autre a un impact sur le type de synchronisation requis entre les GPU. Le parallélisme des données nécessite la synchronisation des paramètres du modèle, le parallélisme du modèle nécessite la synchronisation des valeurs d'entrée et de sortie entre les morceaux.
Exemple de torche simple
Nous allons maintenant examiner un exemple simple de formation d'un réseau de neurones convolutifs basé sur un test unitaire dans Torch lui-même. Ce réseau comporte 2 couches de convolutions et 2 couches de redresseurs. Nous effectuons un simple passage en avant et en arrière sur le réseau. Au lieu de calculer réellement les gradients d'erreur pour la formation, nous les définissons simplement sur un vecteur aléatoire pour simplifier les choses.
nécessite un modèle 'nn' = nn.Sequential() modèle:add(nn.SpatialConvolution(3, 3, 3, 5)) modèle:add(nn.ReLU(true)) modèle:add(nn.SpatialConvolution(3, 3 , 3, 5)) modèle:ajouter(nn.ReLU(true)) entrée = torch.round(torch.Tensor(16, 3, 10, 10):uniform(0, 255)) sortie = modèle:avant(entrée ) fakeGradients = sortie:clone():uniform(-0.1, 0.1) modèle:backward(input, fakeGradients)
Convertissons-le maintenant pour qu'il s'exécute sur un GPU (cet exemple ne s'exécutera que si vous disposez d'un GPU compatible CUDA) :
require 'cutorch' require 'cunn' cutorch.setDevice(1) modèle = nn.Sequential() modèle:add(nn.SpatialConvolution(3, 3, 3, 5)) modèle:add(nn.ReLU(true)) modèle :add(nn.SpatialConvolution(3, 3, 3, 5)) modèle:add(nn.ReLU(true)) modèle:cuda() input = torch.round(torch.CudaTensor(16, 3, 10, 10) :uniform(0, 255)) sortie = modèle:avant(entrée) fakeGradients = sortie:clone():uniform(-0.1, 0.1) modèle:arrière(entrée, fauxGradients)
Pour exécuter cela sur un GPU, nous appelons cuda()sur le réseau, puis effectuez l'entrée CudaTensor.
Distribuons maintenant le modèle sur 2 GPU (à titre d'exemple du paradigme du modèle parallèle). Nous parcourons les ID de périphérique GPU et utilisons le cutorch.withDevice pour placer chaque couche sur un GPU particulier.
require 'cutorch' require 'cunn' cutorch.setDevice(1) model = nn.Sequential() for i=1, math.min(2, cutorch.getDeviceCount()) do cutorch.withDevice(i, function() model: add(nn.SpatialConvolution(3, 3, 3, 5)) end) cutorch.withDevice(i, function() model:add(nn.ReLU(true)) end) end model:cuda() input = torch.round (torch.CudaTensor(16, 3, 10, 10):uniform(0, 255)) sortie = modèle:avant(entrée) fakeGradients = sortie:clone():uniforme(-0.1, 0.1) modèle:arrière(entrée, faux dégradés)
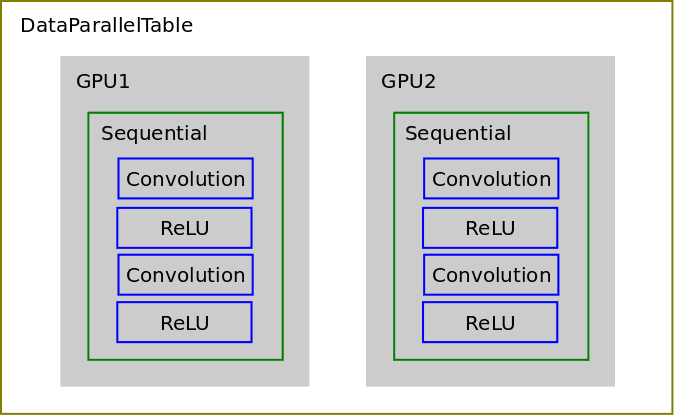
Cela place une couche convolutive et une couche ReLU sur chaque GPU. Les passes avant et arrière doivent propager les sorties entre le GPU 1 et le GPU 2.
Ensuite, nous utilisons nn.DataParallelTable pour distribuer des lots de données à des copies de l'ensemble du réseau fonctionnant sur plusieurs GPU. DataParallelTable est un conteneur Torch qui encapsule plusieurs conteneurs et distribue les entrées entre eux.
require 'cutorch' require 'cunn' cutorch.setDevice(1) modèle = nn.Sequential() modèle:add(nn.SpatialConvolution(3, 3, 3, 5)) modèle:add(nn.ReLU(true)) modèle :add(nn.SpatialConvolution(3, 3, 3, 5)) modèle:add(nn.ReLU(true)) modèle:cuda() gpus = torch.range(1, cutorch.getDeviceCount()):totable() dpt = nn.DataParallelTable(1):add(model, gpus):cuda() input = torch.round(torch.CudaTensor(16, 3, 10, 10):uniform(0, 255)) output = dpt:forward (entrée) fakeGradients = sortie:clone():uniform(-0.1, 0.1) dpt:backward(input, fakeGradients)
Ainsi, au lieu d'exécuter les passes avant et arrière sur le conteneur Sequential d'origine, nous l'exécutons maintenant sur le conteneur DataParallelTable et les données sont distribuées aux copies du réseau sur chaque GPU.
Voici un travail sur Rescale vous pouvez cloner et vous exécuter avec tout le code ci-dessus.
Un exemple plus large
Examinons maintenant une utilisation de DataParallelTable en action lors de la formation d'un vrai DNN. Nous utiliserons la mise en œuvre de Sergey Zagoruyko de Réseaux résiduels étendus sur CIFAR10 sur github.
In train.lua, nous voyons que toute la parallélisation du réseau neuronal de base est appliquée par une fonction assistante :
modèle : ajouter (utils.makeDataParallelTable (net, opt.nGPU))
Plonger dans makeDataParallelTable, nous voyons une structure similaire à notre dernier exemple ci-dessus en utilisant nn.DataParallelTable:ajouter
fonction utils.makeDataParallelTable(model, nGPU) si nGPU > 1 alors local gpus = torch.range(1, nGPU):totable() local le plus rapide, benchmark = cudnn.fastest, cudnn.benchmark local dpt = nn.DataParallelTable(1, true, true) :add(model, gpus) :threads(function() local cudnn = require 'cudnn' cudnn.fastest, cudnn.benchmark = le plus rapide, fin du benchmark) dpt.gradInput = nil model = dpt:cuda() end fin du modèle de retour
Vous pouvez cloner ces tâches et exécuter la formation vous-même sur Rescale :
Après avoir exécuté la formation pendant 10 époques, nous constatons que la tâche à 4 GPU s'exécute environ 3.33 fois plus rapidement que la tâche à un seul GPU. Très bonne mise à l'échelle !
Dans cet article, nous avons donné des exemples d'implémentations de formation DNN parallèle de modèles et de données à l'aide de Torch. Dans les prochains articles, nous aborderons l'utilisation de la formation multi-GPU à l'aide d'autres bibliothèques de réseaux neuronaux ainsi que la mise à l'échelle multi-nœuds.