Le cadre de conception d'expériences (DOE) de Rescale est un moyen simple d'optimiser les performances des modèles d'apprentissage automatique. Cet article discutera d'un flux de travail permettant d'optimiser les hyper-paramètres sur les réseaux de neurones profonds. Pour une introduction aux DOE sur Rescale, voir ce webinaire.
Les réseaux de neurones profonds (DNN) sont un modèle d'apprentissage automatique populaire utilisé aujourd'hui dans de nombreuses applications, notamment la robotique, les voitures autonomes, la recherche d'images, la reconnaissance faciale et la reconnaissance vocale. Dans cet article, nous allons entraîner certains réseaux de neurones à effectuer la classification d'images et montrer comment utiliser Rescale pour maximiser les performances de vos modèles DNN.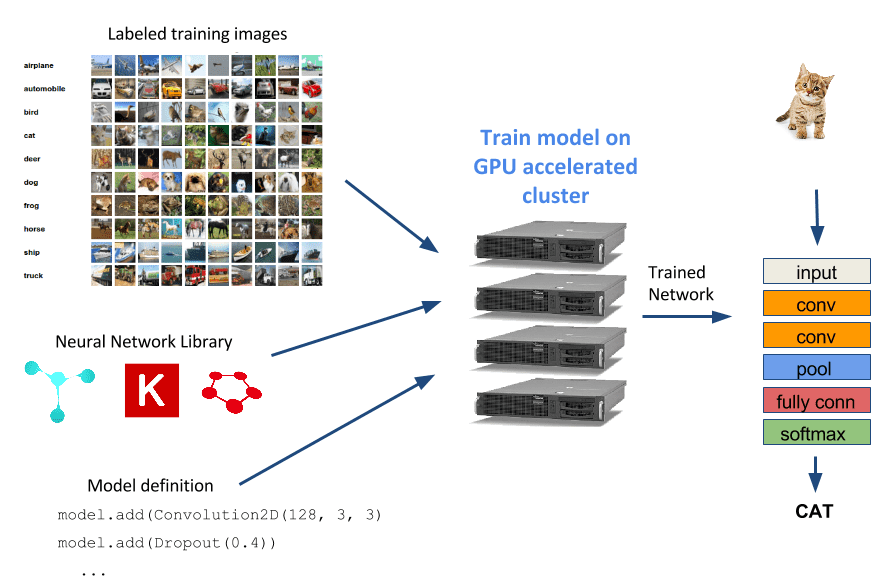
Pour une introduction à la formation d'un DNN de classification d'images sur Rescale, veuillez consulter cet article précédent. Cet article développera l'exemple de formation de modèle de base et montrera comment améliorer les performances de votre réseau grâce à une technique appelée optimisation des hyper-paramètres.
Optimisation des hyper-paramètres
Un point de départ typique pour une tâche utilisant des DNN est de sélectionner un modèle publié dans la littérature et de l'implémenter dans le cadre de formation de réseau neuronal de votre choix, ou encore plus simple, de télécharger un modèle déjà implémenté à partir du Zoo modèle Caffe. Vous pourriez ensuite entraîner le modèle sur votre ensemble de données d'entraînement et constater que les performances (précision de la classification, temps d'entraînement, etc.) ne sont pas assez bonnes. À ce stade, vous pouvez revenir en arrière et rechercher un tout nouveau modèle à entraîner, ou vous pouvez essayer de peaufiner votre modèle actuel pour obtenir les performances supplémentaires que vous désirez. Le processus de réglage des paramètres pour une architecture de réseau neuronal donnée est connu sous le nom d'optimisation des hyper-paramètres. Voici une brève liste d’hyper-paramètres que les gens varient souvent :
- Taux d'apprentissage
- Taille du lot
- Époques de formation
- Paramètres de traitement d'image
- Nombre de couches
- Filtres convolutifs
- Taille du noyau convolutif
- Fractions d'abandon
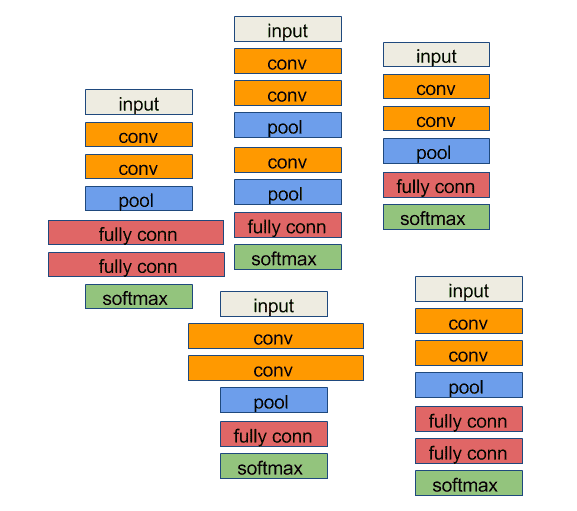
Compte tenu de la grande liste de choix d'hyperparamètres ci-dessus, même une fois que nous avons défini l'architecture du modèle, il existe encore un grand nombre de variantes de réseaux neuronaux similaires. Notre tâche est de trouver une variante suffisamment performante pour nos besoins.
Recherche aléatoire d'hyper-paramètres DOE
À l'aide de la plateforme Rescale, nous allons maintenant créer un travail de conception d'expériences pour échantillonner des hyper-paramètres, puis entraîner ces différentes variantes de réseau à l'aide de GPU.
Pour notre premier exemple, nous commencerons par l'un des exemple de réseaux convolutifs à partir du référentiel github Keras pour former un classificateur de chiffres MNIST. En utilisant ce réseau, nous ferons varier les paramètres réseau suivants :
- nb_filters : Nombre de filtres dans notre couche convolutive
- nb_conv_size : taille du noyau convolutionnel
Nous avons modifié l'exemple pour avoir les valeurs du modèle ci-dessus et voici un extrait du script avec les variables modélisées :
model.add(Convolution2D(${nb_filters}, ${nb_conv_size},
${nb_conv_size}))
model.add(Activation('relu'))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Dropout(0.25))
model.add(Flatten())
model.add(Dense(128))
model.add(Activation('relu'))
model.add(Dropout(0.5))
model.add(Dense(nb_classes))
model.add(Activation('softmax'))
Noter la nb_filtres et nb_conv_size paramètres entourés de ${}. Nous sommes maintenant prêts à créer un travail DOE sur la plateforme Rescale qui utilise ce modèle.
Si vous souhaitez suivre, vous pouvez cloner l'exemple de tâche :
Keras MNIST DOE
Tout d'abord, nous sélectionnons le type de travail DOE dans le coin supérieur droit et téléchargeons le Ensemble de données mnist.pkl.gz à partir du référentiel github Keras.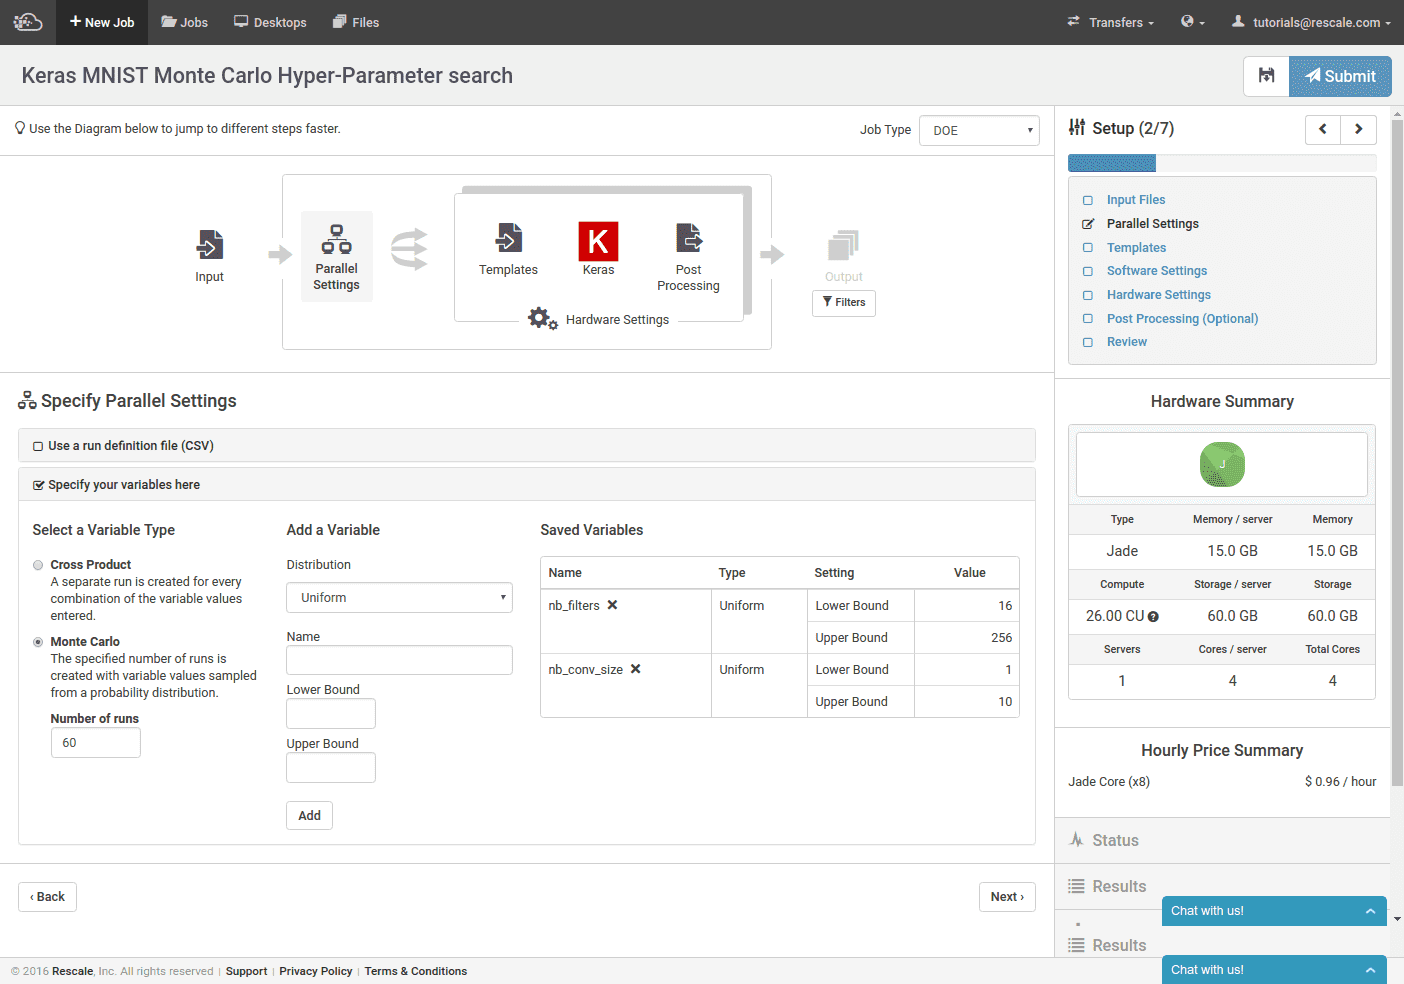
Ensuite, nous spécifions que nous exécutons un Monte Carlo DOE (en bas à gauche), que nous souhaitons effectuer 60 exécutions de formation différentes et nous spécifions nos variables de modèle. Nous choisissons quelque peu arbitrairement les deux paramètres à échantillonner à partir d’une distribution uniforme. La taille du noyau convolutif varie de 1 à 10 (chaque taille d'image est de 28 × 28, donc plus de 28 ne fonctionnerait pas) et le nombre de filtres convolutifs varie de 16 à 256.
Notez que nous pourrions plutôt spécifier nos plages de variables de modèle avec un CSV. Pour cet exemple, nous échantillonnerions manuellement les valeurs aléatoires de nos variables et le CSV ressemblerait à ceci :
Nb_filters, nb_conv_size 16, 3 45, 8 32, 4 ...
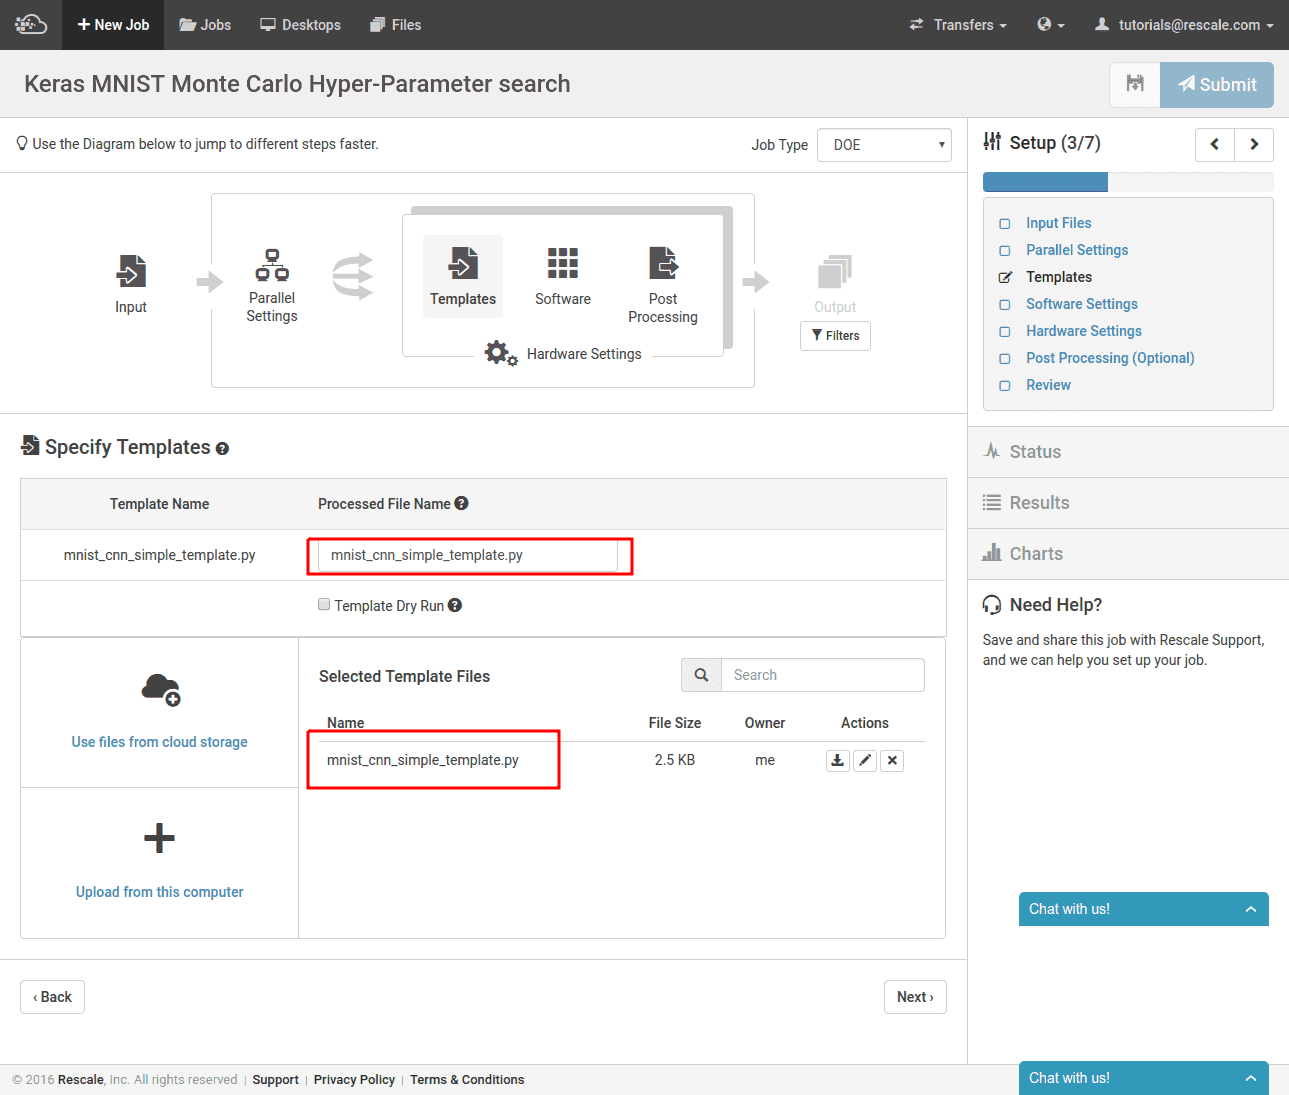
Ensuite, nous devons télécharger le modèle de script Keras que nous avons créé ci-dessus. À ce stade, nous pouvons également spécifier un nouveau nom pour le script avec les valeurs insérées. C'est également bien si vous souhaitez simplement conserver le même nom, comme nous l'avons fait ici. La version matérialisée n'écrasera pas le modèle.
Il est temps de sélectionner la bibliothèque de formation que nous souhaitons utiliser. Recherchez « Keras » dans la zone de recherche et sélectionnez-le. Ensuite, nous sélectionnons la version compatible K520/Theano. Enfin, nous entrons dans la ligne de commande pour exécuter le script de formation. La première partie de la commande consiste simplement à copier l'archive de l'ensemble de données MNIST dans un endroit où Keras peut la trouver. Ensuite, nous appelons simplement le script python.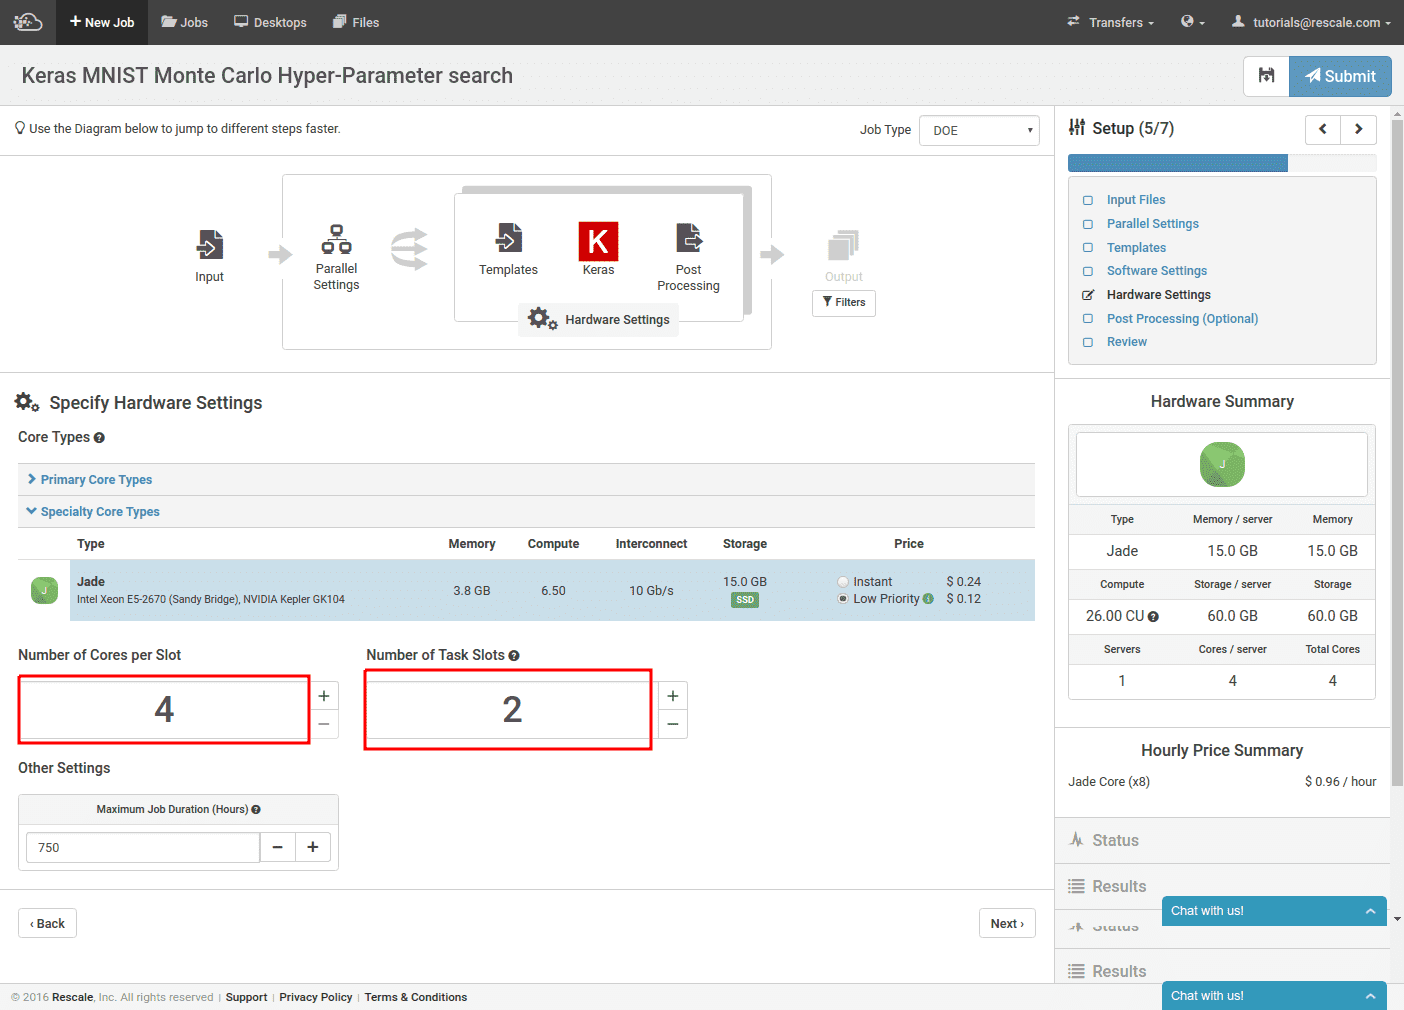
Depuis que nous avons sélectionné une version de Keras configurée pour fonctionner avec les K520, notre type de matériel est déjà limité à Jade. Nous pouvons maintenant dimensionner chaque cluster de formation sur la gauche. Le décompte ici est en nombre de cœurs de processeur. Pour le type de matériel Jade, il existe 4 cœurs de processeur pour chaque GPU. Sur la droite, nous définissons le nombre de clusters de formation distincts que nous proposerons. Dans ce cas, nous utilisons 2 clusters de formation avec un seul GPU par cluster.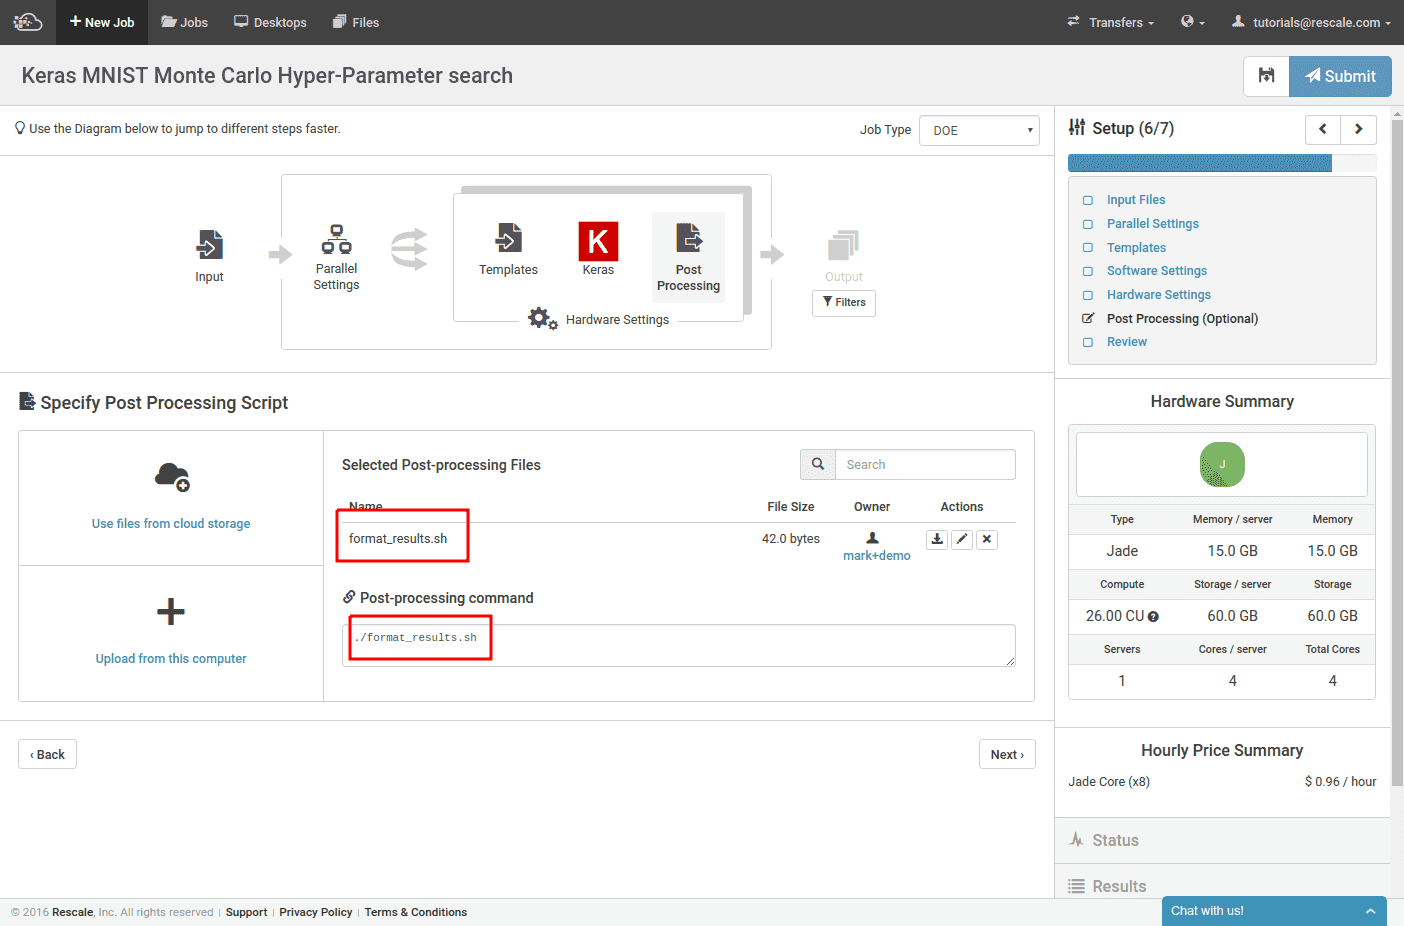
La dernière étape consiste à spécifier le script de post-traitement. Ce script est utilisé pour analyser le résultat de nos tâches de formation et rendre toutes les métriques disponibles pour Rescale pour les afficher dans la page de résultats que nous verrons plus tard. Le format de sortie attendu est une ligne pour chaque valeur :
[nom]\t[valeur]
Étant donné que le script de formation imprime déjà la précision correctement formatée comme dernière ligne de sa sortie, résultat.out, notre script de post-traitement doit simplement analyser cette dernière ligne.
Vous pouvez maintenant soumettre le travail en haut à droite et nous passons à la page d'état du cluster en temps réel.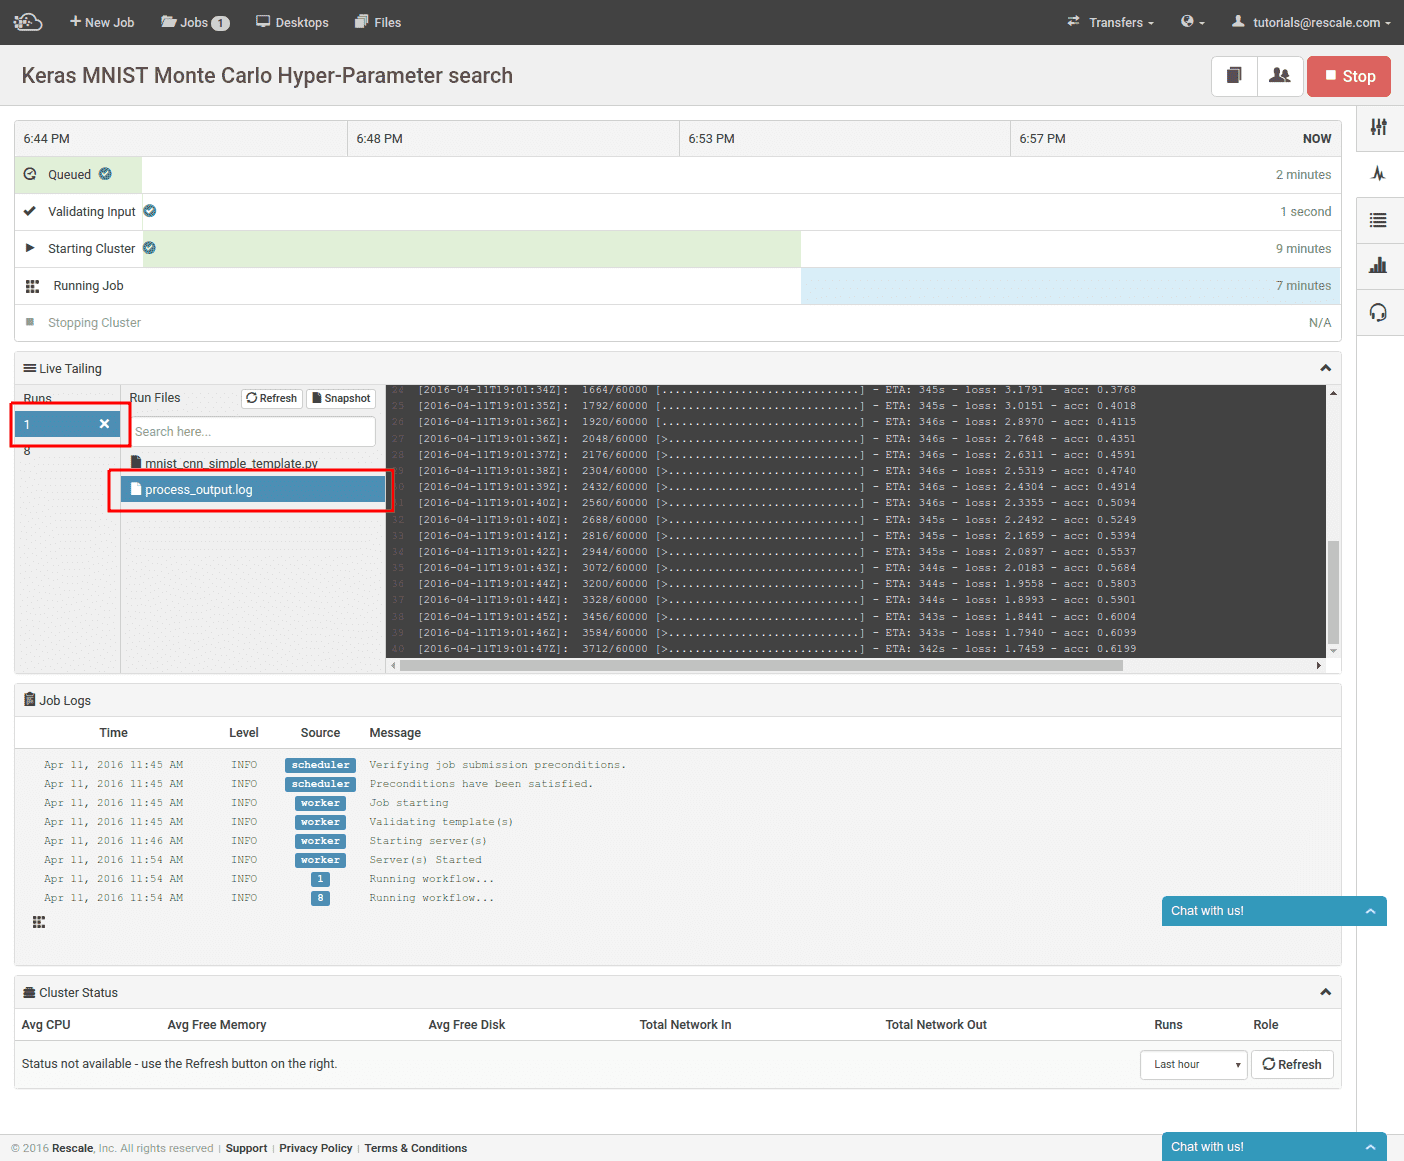
Une fois les clusters provisionnés et la tâche démarrée, nous pouvons visualiser la progression de nos tâches de formation. Dans la fenêtre Live Tailing, sélectionnez une analyse et sélectionnez processus_output.log. Si l'entraînement a déjà commencé, vous pouvez visualiser la progression de l'entraînement et la précision actuelle de l'entraînement. Les analyses individuelles peuvent être terminées manuellement en sélectionnant le « x » à côté du numéro d'exécution sélectionné. Cela permet à l'utilisateur d'arrêter une analyse plus tôt si les paramètres donnent clairement une précision inférieure.
Une fois notre travail terminé, la page de résultats résume les hyper-paramètres utilisés pour chaque exécution et les résultats de précision. Dans le cas ci-dessus, le modèle initial que nous avons tiré des exemples Keras avait une précision de 99.1 % et le meilleur résultat que nous obtenons a une précision d'environ 99.4 %, soit une légère amélioration. Si nous souhaitons télécharger les poids du modèle le plus précis, nous pouvons les trier par précision, puis sélectionner les détails de l'exécution.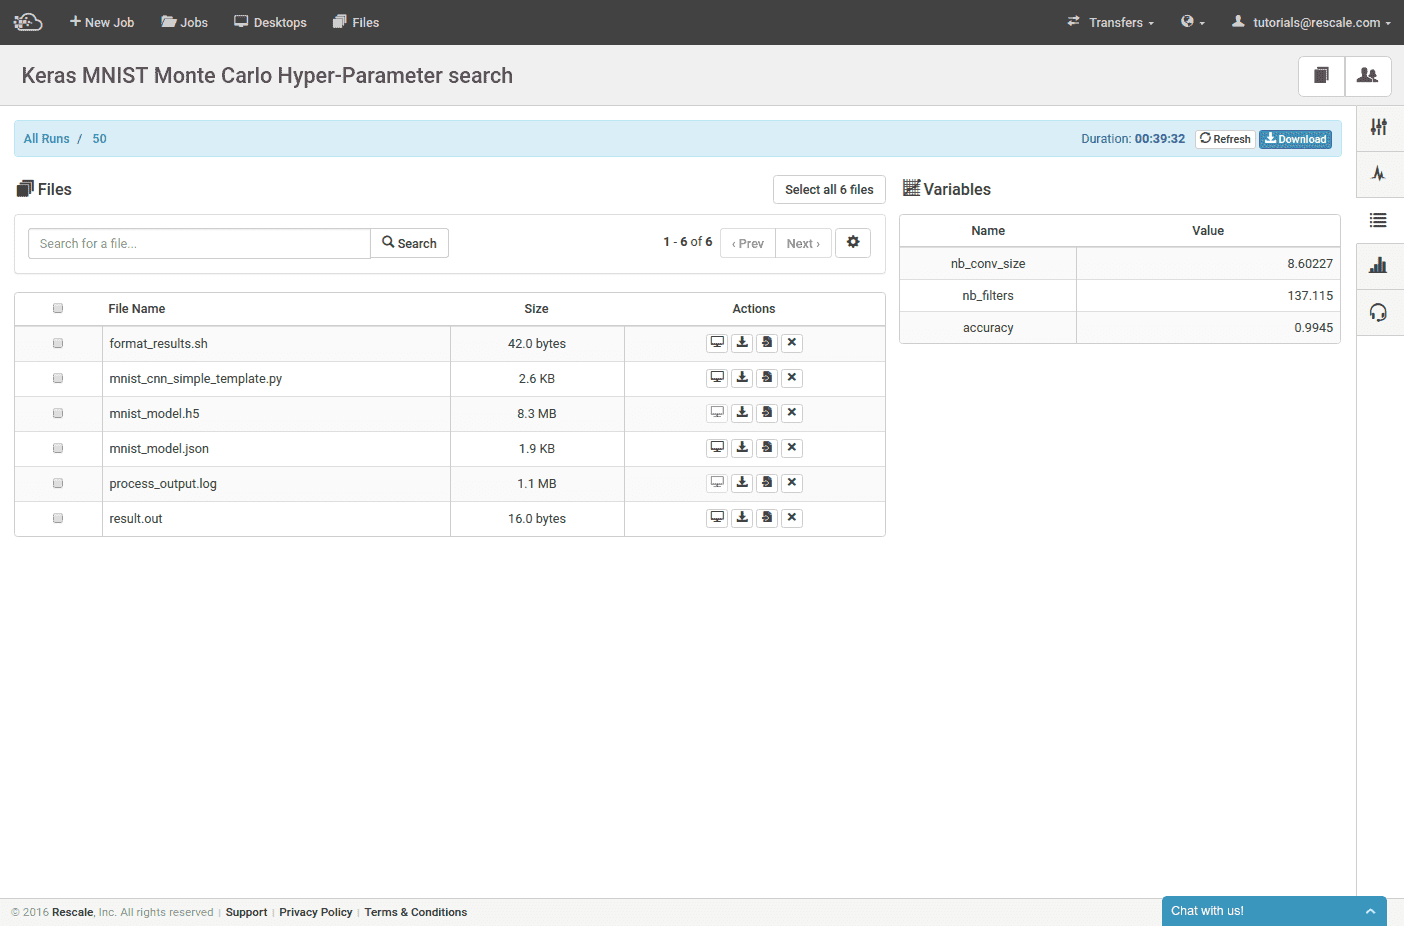
Parmi les autres fichiers de résultats se trouve mnist_model.json et mnist_model.h5, qui sont les fichiers d'architecture du modèle et de pondération du modèle nécessaires pour recharger le modèle dans Keras. Nous pouvons également télécharger toutes les données de toutes les exécutions sous forme d'une seule grande archive ou télécharger le tableau des résultats au format CSV.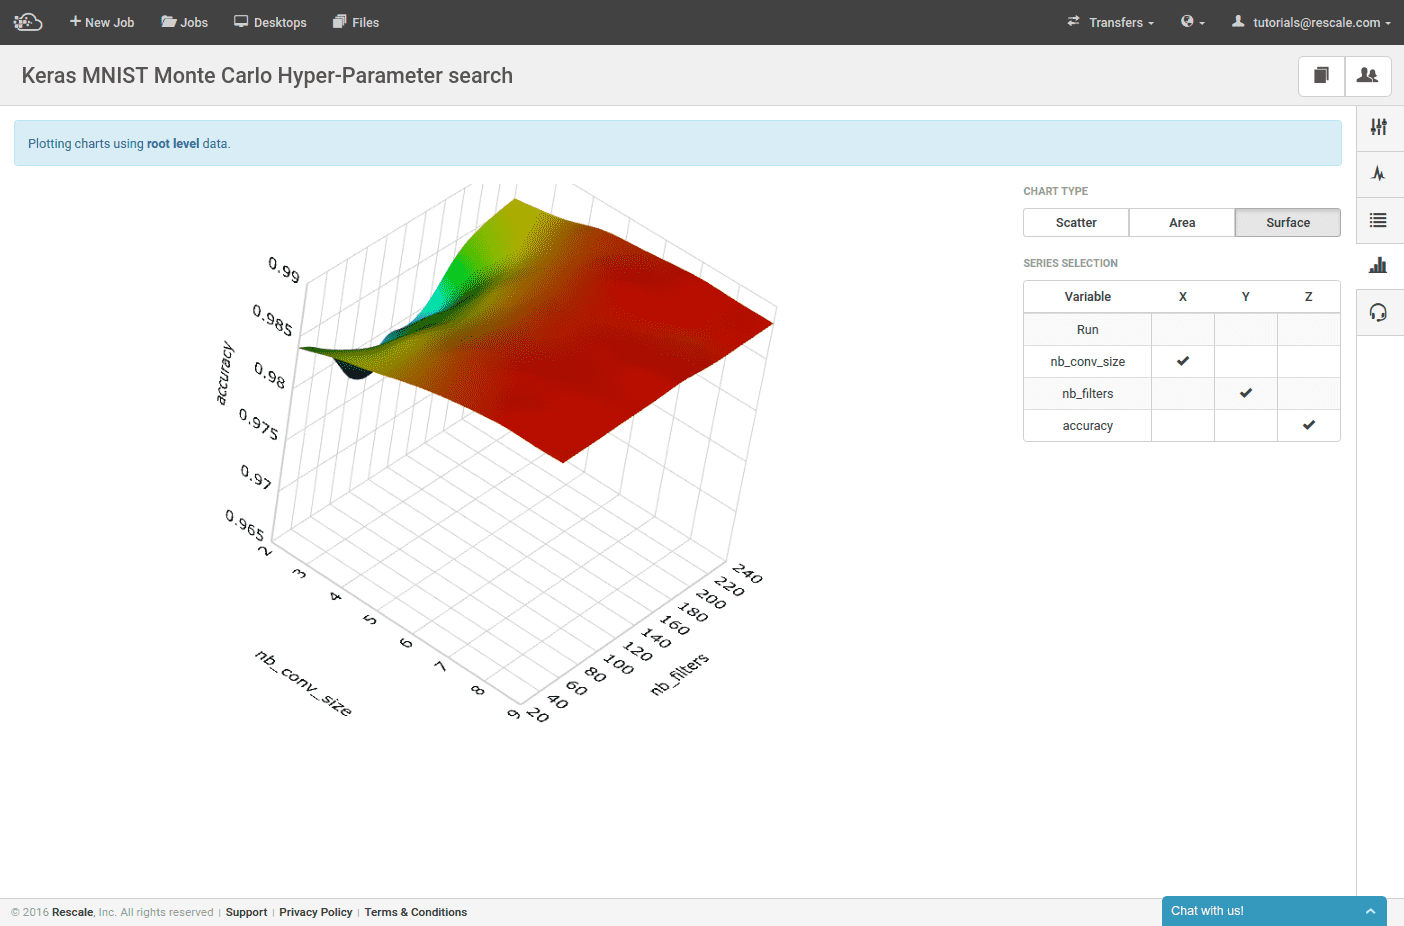
Nos résultats de précision peuvent également être visualisés dans l’onglet graphique.
Apportez votre propre optimiseur d'hyper-paramètres
Rescale prend en charge l'utilisation de logiciels d'optimisation tiers comme détaillé ici. Nous allons maintenant discuter de la création d'une tâche d'optimisation Rescale pour exécuter un optimiseur de boîte noire à partir de la littérature sur l'apprentissage automatique.
À l'aide du SDK d'optimisation Rescale, nous choisissons de brancher le Optimiseur de configuration d'algorithme basé sur un modèle séquentiel (SMAC) de l'Université de la Colombie-Britannique. L'optimiseur SMAC construit un modèle de forêt aléatoire des performances de notre réseau neuronal, basé sur les choix d'hyper-paramètres. Nous utilisons la version 2.10.03, disponible ici.
L'optimiseur est une application Java qui prend la configuration suivante :
- Fichier « scénario » : spécifie la ligne de commande à exécuter par l'optimiseur, dans ce cas il s'agit de notre script de formation réseau
- fichier de paramètres : précise les noms de nos hyper-paramètres et plages de valeurs
Lorsque SMAC exécute le script de formation, il transmet les sélections d'hyper-paramètres actuelles pour les évaluer en tant qu'indicateurs de ligne de commande. Il s'attend à recevoir les résultats de l'exécution dans la sortie standard, formatés sous la forme d'une chaîne comme celle-ci :
Résultat de l'exécution de cet algorithme : , , , , ,
Pour commencer, nous créons un fichier de paramètres pour les hyper-paramètres que nous allons faire varier dans cette expérience :
nb_filters entier [4, 256] [32] nb_conv entier [1, 20] [3] nb_pool entier [1, 20] [2] dropout1 réel [0, 1] [0.25] dropout2 réel [0, 1] [0.5]
Désormais, en plus de faire varier le nombre de filtres convolutifs et la taille du noyau convolutif, nous faisons également varier les fractions d'abandon et la taille de la couche de pooling.
Examinons maintenant les modifications apportées à notre script de formation précédent pour prendre en compte les entrées et les résultats SMAC :
parser = argparse.ArgumentParser() parser.add_argument('-nb_filters', dest='nb_filters', type=int) parser.add_argument('-nb_pool', dest='nb_pool', type=int) parser.add_argument(' -nb_conv', dest='nb_conv', type=int) parser.add_argument('-dropout1', dest='dropout1', type=float) parser.add_argument('-dropout2', dest='dropout2', type= float) parser.add_argument('autre', nargs='+')
Plutôt que d'injecter des valeurs d'hyper-paramètres en tant que modèle, nous utilisons désormais simplement argparse pour analyser les indicateurs fournis par SMAC.
(X_train_orig, y_train_orig), (X_test, y_test) = mnist.load_data() X_train = X_train_orig[:50000] y_train = y_train_orig[:50000] X_val = X_train_orig[50000:] y_val = y_train_orig[50000:]
Puisque nous introduisons les erreurs dans un optimiseur qui sélectionne ensuite de nouveaux paramètres en fonction de cette erreur, nous conservons désormais des ensembles de données de validation et de test séparés. Ci-dessus, nous divisons les données de formation d'origine en un ensemble de formation et de validation. Il est important de conserver un ensemble de données de test distinct afin que nous disposions d'une métrique d'erreur à évaluer qui ne risque pas d'être surajustée par l'optimiseur. L'algorithme d'optimisation ne voit que l'erreur de validation.
model.fit(X_train, Y_train, batch_size=batch_size, nb_epoch=nb_epoch, show_accuracy=True, verbose=1, validation_data=(X_val, Y_val)) val_score = model.evaluate(X_val, Y_val, show_accuracy=True, verbose=0) test_score = model.evaluate(X_test, Y_test, show_accuracy=True, verbose=0) sauf exception comme e : print(e) print('Erreur lors de l'exécution de la formation') satisfiable = False enfin : json = model.to_json() open(' mnist_model.json', 'w').write(json) model.save_weights('mnist_model.h5') print('Erreur de test :', 1 - test_score[1]) print('Val erreur :', 1 - val_score [1]) print('Résultat de l'exécution de l'algorithme : {0}, {1}, {2}, {3}, {4},'.format( 'SAT' si satisfiable sinon 'UNSAT', time.time( ) - t0, 1, 1 - val_score[1], 1337 ))
Ici, nous entraînons le modèle, l'évaluons sur les ensembles de données de validation et de test, puis produisons les résultats dans le format spécifique au SMAC (« Résultat de l'algorithme… »). Notez que nous détectons également toutes les erreurs de formation et de validation et marquons celles qui s'exécutent comme « UNSAT » sur SMAC afin que SMAC sache qu'il s'agit d'une combinaison de paramètres non valide.
Pour que SMAC appelle le SDK Rescale python, nous écrivons un script wrapper, que nous appellerons smac_opt.py, et précisons que SMAC l'appelle dans le fichier de scénario. Le wrapper soumet ensuite le script de formation à exécuter.
Quelques extraits importants du script wrapper :
si __name__ == '__main__' : print objective_function(sys.argv[1:])
Pour commencer, nous prenons tous les indicateurs de ligne de commande passés dans le script et les transmettons directement à notre fonction objectif. C'est la fonction objectif qui sera appelée pour chaque ensemble d'hyper-paramètres.
def objective_function(X): iteration = os.getpid() # Donner à chaque itération ses propres fichiers run_dir = 'run-{0}'.format(iteration) output_file = 'output-{0}'.format(iteration) copy_input( 'input', run_dir) # Regroupons zip_file = 'run.zip' filezip(run_dir, zip_file) # Pas besoin de conserver le répertoire sur le nœud de l'optimiseurshutil.rmtree(run_dir)
Pour démarrer la fonction objectif, nous regroupons les fichiers d'entrée de cette formation dans un fichier .zip.
COMMANDE = 'python mnist_cnn_smac.py {0} | python format_results.py > {1}' command = concatenate_shell_commands( 'unzip ' + zip_file, 'rm ' + zip_file, 'cd ' + run_dir, COMMAND.format(' '.join(X), '../' + output_file ), 'cd ..' ) run = rescale.submit( commande, input_files=[zip_file], output_files=[output_file], var_values=get_val_dict(X) ) run.wait()
Ici, nous formatons la commande du script de formation que nous allons exécuter. Notez que nous transmettons simplement les indicateurs de SMAC (variable « X ») au script de formation. Ensuite, nous appelons la commande submit qui envoie les fichiers d'entrée au cluster de formation et démarre la formation. Nous appelons également désormais nous-mêmes le script `format_results`.
# Obtenez la valeur de la fonction objectif à partir de la sortie et enregistrez-la dans Rescale pour la ligne dans open(output_file) : if re.match('Result of .*algorithm run.*', line) : results = line m = re.match(' Erreur de test : ([\de\.-]+).*', ligne) si m : testerr = float(m.group(1)) quality = results.split(', ')[3] run.report( {'testerr': float(testerr), 'valerr': float(quality)}) renvoie les résultats
Nous analysons le fichier de sortie du script de formation pour obtenir la ligne de résultats SMAC attendue (« Résultat de l'exécution de l'algorithme… »), ainsi que l'erreur sur l'ensemble de données de test.
Enfin, nous devons spécifier le fichier de scénario qui indique à SMAC d'appeler notre script wrapper.
use-instances = false runObj = QUALITÉ numberOfRunsLimit = 100 pcs-file = params.pcs algo = ./smac_opt.py check-sat-consistency = false check-sat-consistency-exception = false
Les parties importantes ici sont :
- pcs-file : spécifie les paramètres
- algo : script wrapper à exécuter
- numberOfRunsLimit : définit le nombre d'exécutions d'entraînement
- check-sat-consistency : indique à l'optimiseur que pour le même ensemble de données d'entraînement, différentes sélections de paramètres peuvent conduire à un modèle réalisable ou infaisable
- Alors maintenant que nous avons tous nos fichiers d’entrée, nous sommes prêts à créer un travail.
Vous pouvez cloner le travail pour l'exécuter vous-même ici :
Keras MNIST SMAC Optimiseur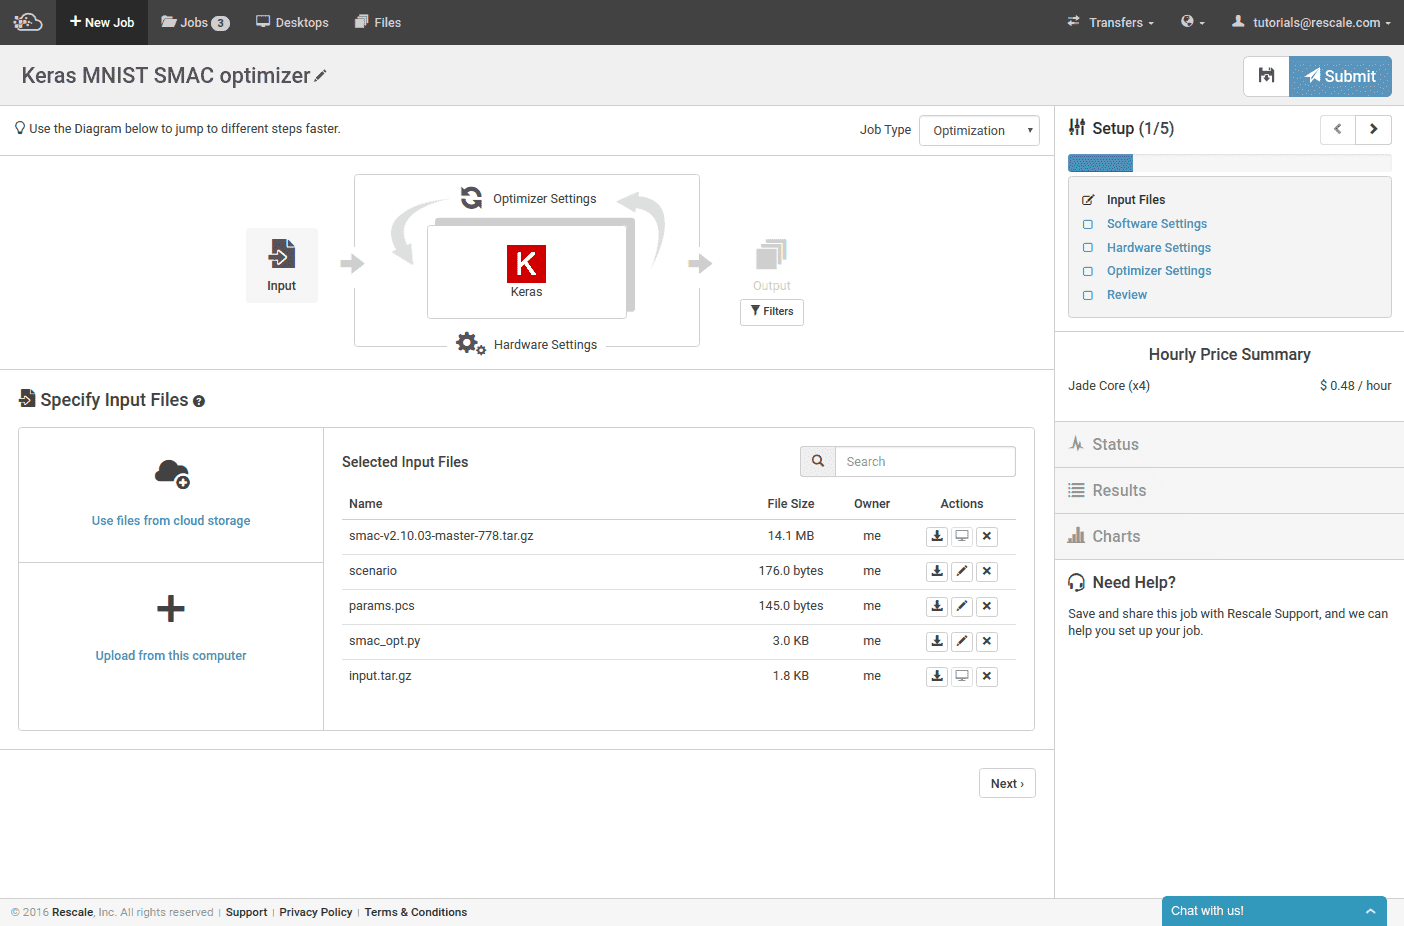
L'archive input.tar.gz se compose d'un répertoire input/ avec notre script de formation mnist_cnn_smac.py et le script de post-traitement format_results.py.
Nous sélectionnons le même logiciel que précédemment, Keras configuré pour Theano sur un K520.
La sélection du matériel est également à peu près la même. Nous sélectionnons à nouveau 2 emplacements de tâches pour former 2 réseaux en parallèle.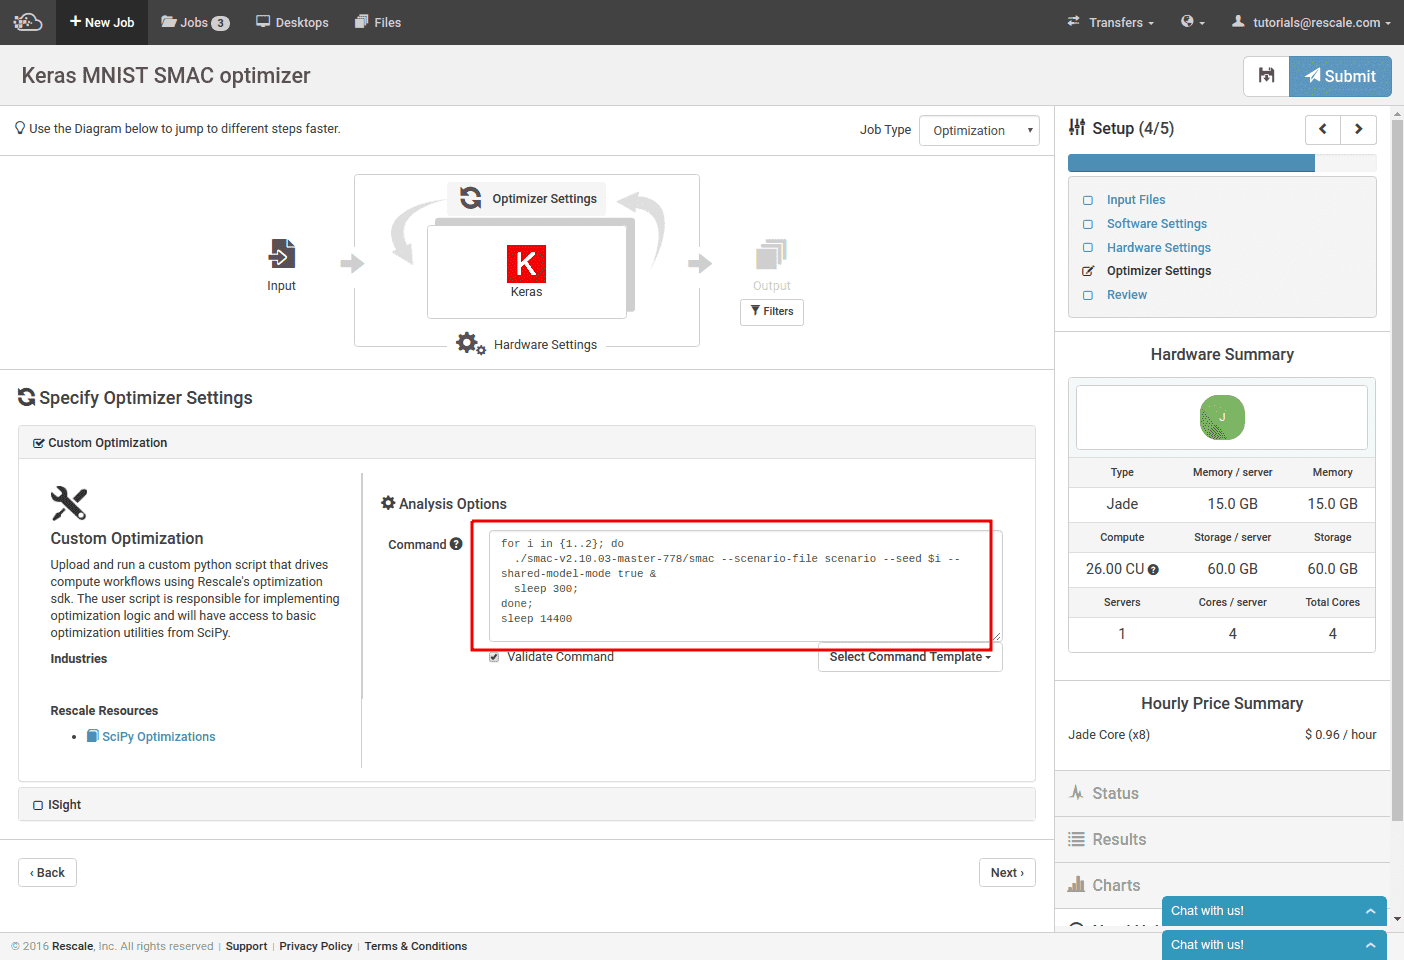
Pour l'optimiseur, nous sélectionnons « Optimisation personnalisée », puis entrons dans la ligne de commande pour exécuter SMAC. Cette commande est rendue compliquée par le fait que chaque processus SMAC n'exécute qu'une seule itération à la fois. Pour exécuter plusieurs formations en parallèle, nous devons utiliser le « mode modèle partagé » de SMAC. L'activation de ce mode indique à SMAC de vérifier périodiquement dans son répertoire actuel les résultats d'optimisation d'autres processus SMAC et d'incorporer ces résultats. Ce mode nécessite que nous définissions le « -seed » sur une valeur différente pour chaque processus SMAC.
Étant donné que nous devons exécuter plusieurs processus d'optimisation à la fois, nous effectuons tous les appels en arrière-plan, puis nous dormons pendant la durée maximale pendant laquelle nous voudrions exécuter cet optimiseur. Dans ce cas, nous attendons 4 heures.
Ce travail est maintenant prêt à être soumis. Une fois exécuté, vous pouvez vivre les itérations actuelles et, à la fin, afficher les résultats comme dans le cas randomisé précédent. Les résultats montreront désormais à la fois les erreurs de validation et de test pour chaque ensemble d'hyper-paramètres.
Conclusion
Dans cet article, nous avons montré 2 façons de rechercher un réseau de neurones dans l'espace des hyper-paramètres. L’un utilisait une recherche aléatoire et l’autre un outil d’optimisation plus sophistiqué, utilisant le SDK d’optimisation Rescale.