
Trouvez l'architecture cloud HPC adaptée à vos besoins
C’est vraiment une période formidable pour se lancer dans la R&D numérique. Les anciennes contraintes des centres de données sur site sont remplacées par une capacité élastique pratiquement illimitée des services de calcul intensif basés sur le cloud. Les chercheurs et les ingénieurs ne doivent plus faire la queue pour accéder à une ressource limitée et de grande valeur.
Mais cela signifie aussi qu'il y a beaucoup de choix. Quel fournisseur de cloud devrions-nous utiliser ? Faut-il être mono-cloud ou multi-cloud ? Quels services de calcul haute performance (HPC) nous conviennent le mieux ? Quelle architecture de puce devrions-nous utiliser ?
Et surtout, les services cloud HPC et les architectures de puces qui les prennent en charge évoluent rapidement. La variété et le nombre de chips explosent. Cela génère une tonne d’options pour les utilisateurs HPC, mais cela crée également une complexité importante.
La bonne nouvelle? Rescale a créé des profils de performances pour simplifier le défi du choix des puces. Examinons ces tendances et comment Rescale peut vous aider.
Une nouvelle ère pour le HPC
Les services cloud HPC ont connu une forte augmentation de la demande au cours de la dernière décennie, stimulée par la croissance rapide de la R&D numérique pour exécuter des modèles et des simulations complexes de la physique réelle. Le HPC englobe un écosystème de ressources informatiques, d'applications, de stockage et de réseau qui sont stratégiquement regroupées pour résoudre des problèmes informatiques complexes.
La technologie cloud est à l'avant-garde de la révolution HPC, aidant les organisations de tous les secteurs à exploiter une puissance de traitement des données qui dépasse ce que les environnements de centres de données traditionnels peuvent offrir. Le HPC dans le cloud offre des niveaux de performances, d'efficacité et de flexibilité sans précédent aux organisations qui cherchent à piloter la transformation numérique de leurs programmes de R&D.
L'adoption du cloud a connu une croissance exponentielle ces dernières années, les entreprises consacrant plus de 30 % de leurs budgets informatiques à l'infrastructure cloud. Cette croissance est pour une bonne raison. Le cloud offre des avantages inégalés, notamment un accès à la demande aux ressources partagées et des économies de coûts grâce à l'élimination d'équipements de serveur internes coûteux.
La croissance des puces spécialisées
Associée à l'expansion des services HPC basés sur le cloud, la croissance massive des puces spécialisées transforme le calcul haute performance pour la R&D, offrant une puissance de calcul optimisée pour des charges de travail spécifiques. Les puces spécialisées visent à remédier aux inefficacités des unités centrales de traitement (CPU) à usage général. .
Ces nouvelles puces se présentent sous différentes formes, notamment des unités de traitement graphique (GPU), des réseaux de portes programmables sur site (FPGA) et des circuits intégrés spécifiques à une application (ASIC). Ils sont conçus pour accélérer le calcul pour des tâches spécifiques, telles que l'intelligence artificielle (IA), l'apprentissage automatique (ML) et l'analyse du Big Data.
La prolifération des puces spécialisées stimule les performances. La loi de Moore s'est aplatie au cours des vingt dernières années, ce qui signifie que les performances des puces traditionnelles n'ont pas augmenté aussi rapidement qu'au début de l'industrie informatique.
En conséquence, le marché s'est tourné vers des architectures informatiques spécialisées à semi-conducteurs pour gagner en efficacité en termes de vitesse, de coût et d'efficacité énergétique. La diversité des architectures de puces explose. Le nombre de puces spécialisées a augmenté de 1,000 10 % au cours des 2020 dernières années. En 400, par exemple, plus de 1,450 nouveaux types de puces (types de base et instances) sont arrivés sur le marché. Il existe désormais plus de XNUMX XNUMX types de puces différents (types de cœur et instances), et cela ne fait que s'accélérer.
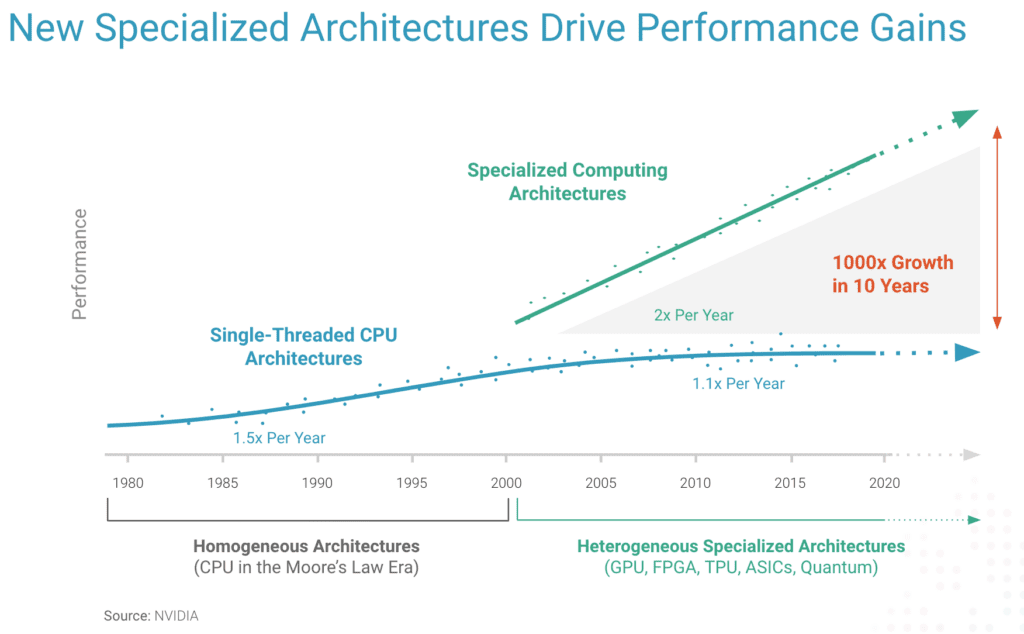
pour améliorer les performances des tâches informatiques de R&D gourmandes en données.
Cette croissance étonnante est alimentée par l’adoption rapide des architectures Arm et un nouveau paradigme de fabrication des puces. Des entreprises comme AWS, Microsoft et Google ont toutes fabriqué leurs propres puces pour prendre en charge leurs opérations cloud.
Il est important de noter que ces puces spécialisées sont conçues pour des tâches de calcul spécifiques. Une puce peut être excellente pour les tâches parallèles, tandis qu'une autre peut offrir les vitesses les plus rapides pour les tâches informatiques monothread et gourmandes en données. Et ni l’un ni l’autre ne constitue le meilleur choix pour chaque tâche et chaque charge de travail.
Par exemple, si vous exécutez un Dynamique des fluides computationnelle (CFD) ou Analyse des éléments finis (FEA), quel logiciel allez-vous utiliser ? Ils vont fonctionner différemment. Chaque variable que vous introduisez entraînera une puce différente qui fournira des performances optimales pour la tâche donnée.
Examinons de plus près ces compromis. Choisir la bonne puce car la bonne application et la bonne tâche de calcul font vraiment une grande différence en termes de performances, de coûts et d’efficacité énergétique.
Choisir la bonne architecture de puce pour les besoins de calcul de R&D
Le premier cas d’utilisation à examiner concerne l’optimisation des temps d’exécution des simulations. En sélectionnant le bon matériel, les utilisateurs peuvent allouer les ressources nécessaires à leurs simulations pour les rendre plus rapides lorsque le temps est un facteur, comme pour les fabricants de pièces automobiles qui conçoivent de nouveaux équipements pour remporter de nouveaux contrats.
Alternativement, vous envisagez peut-être de réduire les coûts de simulation. En sélectionnant le bon matériel, les utilisateurs peuvent minimiser la durée de licence logicielle dont ils ont besoin pour exécuter leurs simulations, réduisant ainsi les coûts globaux d'exécution d'une simulation.
Cela peut être particulièrement utile lorsque les budgets sont limités. En ces temps économiques, les organisations doivent plus que jamais être soucieuses des coûts. Pour contrôler vos coûts cloud, réduire la durée totale d’utilisation avec un matériel plus rapide peut être extrêmement bénéfique.
Un troisième cas d’utilisation concerne la mise à l’échelle des simulations. À mesure que les simulations évoluent, elles fonctionneront différemment avec différents matériels, en particulier dans les cas d'utilisation où elles doivent être exécutées sur plusieurs clusters ou nécessitent plus de mémoire.
Ces trois cas d’utilisation ne sont qu’un petit échantillon de tous les cas d’utilisation possibles en R&D pour le calcul haute performance. Et dans la plupart des situations, ces trois besoins se confondent.
Vous ne voudrez pas seulement le plus rapide, le moins cher ou la plus grande échelle. Et c’est souvent une question de compromis coût-performance. Quelle puce sur quel service cloud vous aidera le mieux à accélérer vos efforts d'innovation ?
Obstacles à une analyse comparative efficace
Comprendre les performances, les coûts, l’efficacité énergétique et l’évolutivité de toute architecture HPC est essentiel. Pour acquérir cette compréhension, les organisations pouvaient traditionnellement comparer certains matériels et les tester sur leurs applications. Mais aujourd’hui, de nouvelles puces arrivent rapidement sur le marché, ce qui rend difficile pour une organisation de suivre le rythme de son analyse comparative.
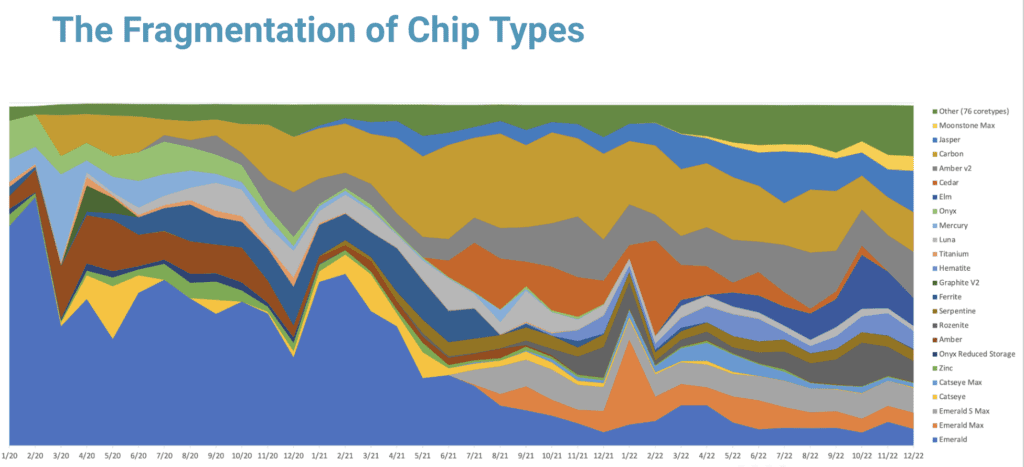
Et l’analyse comparative n’est pas facile. L’effort nécessaire pour démarrer avec l’analyse comparative HPC peut prendre beaucoup de temps. La mise en place et l’exécution des benchmarks nécessitent des efforts considérables. Cela peut être particulièrement difficile pour les organisations qui ne disposent pas de l’expertise ou des ressources nécessaires pour les réaliser.
Aujourd’hui, il est difficile d’identifier le meilleur matériel à tester. Et vous souhaiterez peut-être utiliser différentes puces avec des attributs système différents, peut-être un stockage de mémoire CPU ou des réseaux différents. Si vous ne suivez pas les types de puces les plus récents et les plus performants au fur et à mesure de leur introduction, vous risquez de prendre du retard.
De plus, l'analyse et l'interprétation des résultats d'analyse comparative sont difficiles car l'identification des causes profondes Les problèmes de performance peuvent être complexes.
Profils de performances : la bonne puce, à chaque fois
Alors, si l’analyse comparative est essentielle pour choisir le bon matériel HPC pour vos tâches de R&D, que peut faire une organisation ? La réponse est Redimensionner les profils de performances.
Les profils de performances automatisent la manière dont les organisations peuvent savoir immédiatement quels types de puces correspondent le mieux à leurs besoins.
Grâce aux profils de performances, les organisations peuvent établir leur propre intelligence des performances pour leurs applications et tâches informatiques spécifiques.
Avec les profils de performances, vous n'avez plus besoin de vous fier aux conjectures lorsqu'il s'agit de choisir le bon type de cœur ou le nombre de cœurs requis.
Au lieu de cela, avec les profils de performances, vous pouvez utiliser sa carte de performances pour déterminer la combinaison optimale de ressources matérielles pour votre simulation.
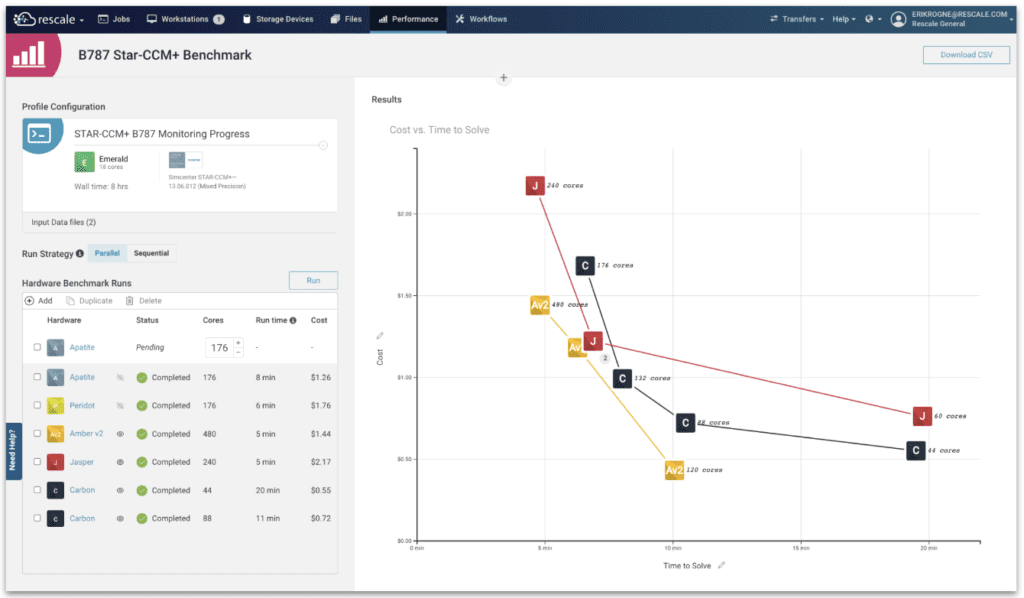
Les profils de performances vous fournissent toutes les données comparatives dont vous avez besoin pour comprendre les forces et les faiblesses de toute architecture matérielle. Vous pouvez alors prendre des décisions qui correspondent à vos besoins stratégiques. Cela varie d'un client à l'autre, comme nous l'avons vu dans les cas d'utilisation, et cela dépend vraiment du projet en cours.
Avec les profils de performances, vous pouvez prendre des décisions éclairées basées sur des références réelles de vos logiciels et modèles, et vous permet d'isoler des variables parmi les types de puces, la taille du cluster, le type d'application et la tâche de calcul. Lorsque vous utilisez les profils de performances, vous saurez quelle infrastructure HPC répond réellement à vos besoins de R&D.
Beaucoup de nos clients bénéficient déjà des profils de performance Rescale, notamment Kairos Power, une start-up d'énergie propre.
« Les profils de performance ont été une fonctionnalité très précieuse pour nous », déclare Brian Jackson, ingénieur principal en dynamique des fluides chez Kairos. « Grâce aux profils de performances, notre équipe a découvert deux architectures matérielles qui offraient une amélioration du rapport coût/vitesse de 30 % par rapport aux architectures de puces que nous utilisions. À l’avenir, nous utiliserons ces nouveaux types de cœurs et nous continuerons à utiliser cette nouvelle fonctionnalité Rescale pour optimiser les performances et la valeur.
Dans cette nouvelle ère de R&D numérique et de calcul haute performance, la nécessité de choisir les bonnes architectures matérielles auprès des fournisseurs de services cloud est primordiale. Faire le bon choix a des implications majeures en termes de coûts, de performances, d’échelle et de durabilité. Se tromper pourrait s’avérer coûteux tout en ralentissant les efforts d’innovation. Choisissez judicieusement avec Rescale Performance Profiles.
Souhaitez-vous en savoir plus sur la manière dont les profils de performances Rescale peuvent aider votre organisation à choisir l'architecture HPC adaptée à ses besoins en R&D ?Regardez le webinaire « Optimiser le coût et les performances des charges de travail dans le cloud » ou en savoir plus sur Profils de performance.