
Tirer parti d'architectures spécialisées avec des accélérateurs matériels spécifiques à un domaine : GPU Nvidia et puces Arm en rescale

En matière d'ingénierie et de recherche scientifique, la demande de solutions de calcul haute performance (HPC) continue de croître. Des simulations complexes aux modèles avancés d’apprentissage automatique, les exigences informatiques de l’ingénierie moderne et des applications scientifiques sont immenses. Pour répondre à ces demandes, des accélérateurs matériels spécifiques à un domaine, en particulier GPU Nvidia et Puces de bras, sont devenus inestimables. Couplé à l'infrastructure évolutive et flexible fournie par plateformes cloud comme Rescale, ces architectures spécialisées peuvent améliorer considérablement efficacité et performances informatiques. Voyons comment ingénieurs et scientifiques peuvent exploiter les GPU Nvidia et les puces Arm sur Rescale pour résoudre leurs problèmes informatiques les plus difficiles.
Les architectures spécialisées génèrent des gains de performances
Les accélérateurs matériels spécifiques à un domaine sont conçus pour optimiser les performances de types particuliers de calculs. Contrairement aux processeurs à usage général, ces accélérateurs fournissent des solutions sur mesure capables de gérer des tâches spécifiques plus efficacement, ce qui les rend idéaux pour les charges de travail complexes et gourmandes en données courantes dans l'ingénierie et la recherche scientifique.

L'évolution des performances des architectures informatiques de 1980 à nos jours illustre les différences entre les architectures homogènes et hétérogènes. Initialement, les architectures de processeur monothread ont amélioré les performances de 1.5 fois par an pendant l'ère de la loi de Moore, puis ont ralenti à 1.1 fois par an vers 2005. En revanche, les architectures informatiques spécialisées (par exemple, GPU, FPGA, TPU, ASIC, Quantum) ont vu un taux de croissance des performances de 2x par an depuis leur introduction, ce qui se traduit par une croissance projetée de 1000x sur une décennie [1]. Le graphique ci-dessus met l'accent sur le passage d'architectures spécialisées homogènes à des architectures spécialisées hétérogènes pour des gains de performances substantiels.
Étudions deux architectures différentes et leur applicabilité aux flux de travail gourmands en calcul.
GPU Nvidia : libérer la puissance du traitement parallèle
Les GPU Nvidia ont révolutionné le paysage du calcul scientifique grâce à leurs capacités de traitement parallèle inégalées. Conçus initialement pour le rendu graphique, les GPU ont démontré une efficacité exceptionnelle dans la gestion de tâches de calcul intensives, notamment dans les domaines de la dynamique des fluides, de la dynamique moléculaire et de la physique des matériaux. Physique de l'IA.
Principales caractéristiques des GPU Nvidia :
- Parallélisme massif: Les GPU Nvidia disposent de milliers de cœurs capables d'effectuer des calculs simultanés, ce qui les rend idéaux pour les tâches parallélisables telles que les multiplications matricielles dans les réseaux neuronaux ou les interactions de particules dans les simulations moléculaires.
- Modèle de programmation CUDA: CUDA de Nvidia (Compute Unified Device Architecture) permet aux développeurs de logiciels d'ingénierie et de recherche d'écrire du code qui exploite toute la puissance de traitement parallèle des GPU. CUDA est devenu un standard en matière de calcul scientifique pour la programmation GPU.
- Noyaux de tenseurs: Introduit dans La Volta de Nvidia Et subséquente architectures, les Tensor Cores sont des unités spécialisées conçues pour accélérer les opérations d'apprentissage en profondeur. Ils fournissent des gains de performances substantiels en matière de formation et d'inférence de les réseaux de neurones.
Puces Arm : efficacité et polyvalence pour diverses applications
Processeurs Arm sont réputés pour leur efficacité énergétique et leur polyvalence, ce qui les a rendus populaires sur une large gamme d'appareils, des téléphones mobiles aux superordinateurs. Dans scientifique et ingénierie Applications, les puces Arm offrent un équilibre entre performances et efficacité énergétique qui est particulièrement bénéfique pour les simulations et l'analyse de données à grande échelle.
Principales caractéristiques des puces de bras :
- L'efficacité énergétique: L'architecture d'Arm est conçue pour maximiser les performances par watt, ce qui lui permet d'être un concurrent majeur du Green Compute. Il convient aux applications sensibles à la consommation et aux déploiements à grande échelle où les coûts énergétiques sont un problème, comme le démontre l'utilisation par NVIDIA Grace du LPDDR (DDR faible consommation) pour la mémoire des processeurs Grace.
- Évolutivité: Les processeurs Arm peuvent être adaptés à partir de systèmes embarqués à faible consommation jusqu'à des clusters de calcul hautes performances, offrant ainsi une flexibilité dans différents cas d'utilisation. En termes de performances, les processeurs Arm égalent et/ou battent leurs contemporains x86, ce qui fait appel aux outils de simulation liés à une licence.
- Coût-Performance: Les puces Arm sont souvent plus rentables que les autres processeurs, les principaux hyperscalers construisant leurs propres processeurs Arm. Cela permet une plus grande efficacité informatique pour leurs utilisateurs et offre un équilibre favorable entre prix et performances, ce qui est particulièrement bénéfique pour les projets de recherche et les mises en œuvre à grande échelle.
Rescale : une plate-forme conçue pour le calcul haute performance
Redimensionner est une plate-forme cloud conçue pour fournir des ressources HPC évolutives, permettant aux chercheurs et aux ingénieurs d'exécuter des simulations complexes et des tâches de traitement de données sur diverses architectures matérielles, notamment les GPU Nvidia et les processeurs Arm.
Principaux avantages de l'utilisation de Rescale :
- Évolutivité: Rescale offre un accès à des ressources informatiques pratiquement illimitées, permettant aux utilisateurs d'adapter leurs charges de travail de manière dynamique en fonction de la demande.
- Diverses options matérielles: Les utilisateurs peuvent choisir parmi une large gamme de configurations matérielles, y compris les derniers GPU Nvidia et puces Arm, pour répondre au mieux à leurs besoins informatiques spécifiques.
- Ergonomie: La plateforme fournit une interface intuitive pour gérer et déployer les charges de travail, ainsi qu'une prise en charge robuste pour une multitude d'applications scientifiques et techniques.
- Souplesse: En utilisant des ressources basées sur le cloud, les chercheurs peuvent optimiser les coûts, en ne payant que pour les ressources de calcul qu'ils utilisent réellement, évitant ainsi d'importants investissements matériels initiaux.
Optimisation des charges de travail d'ingénierie et scientifiques lors du rescale
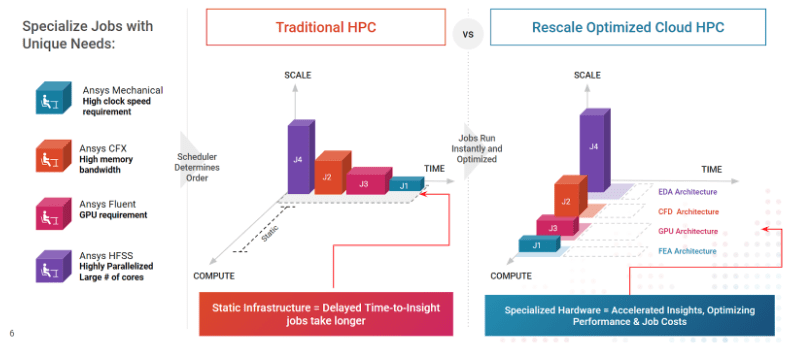
Dans le HPC traditionnel, une configuration homogène utilise des ressources statiques dans lesquelles un planificateur détermine l'ordre des tâches, ce qui entraîne un délai d'obtention d'informations retardé et des durées de tâches prolongées. Les travaux à grande échelle exécutant Ansys Fluent, Siemens CCM+ et LS-Dyna doivent attendre les ressources appropriées. En revanche, Rescale Optimized Cloud HPC utilise une approche hétérogène avec du matériel spécialisé, permettant aux tâches de s'exécuter instantanément et efficacement. Cette configuration exploite des architectures spécifiques, adaptées aux besoins de chaque tâche, accélérant ainsi les informations, améliorant les performances et optimisant les coûts des tâches.
Pour exploiter pleinement les capacités des GPU Nvidia et des puces Arm sur Rescale, il est crucial de configurer et d'optimiser efficacement les charges de travail. Voici comment obtenir des performances optimales pour les applications d'ingénierie et scientifiques
Optimisation des charges de travail pour les GPU Nvidia
Lors du déploiement d'applications sur des GPU Nvidia, plusieurs bonnes pratiques peuvent aider à optimiser les performances :
- Parallélisez votre code : Identifiez les parties de votre code qui peuvent être parallélisées. Utilisez CUDA ou d'autres frameworks de programmation parallèle pour décharger ces tâches sur le GPU.
- Utiliser des cœurs Tensor : Pour les tâches d'apprentissage en profondeur, assurez-vous que vos modèles sont optimisés pour tirer parti des Tensor Cores. Cela peut accélérer considérablement les processus de formation et d’inférence.
- Profiler et optimiser : Tirez parti des outils d'optimisation, tels que les profils de performances et le moteur de recommandation de Rescale, pour analyser les performances de votre travail et identifier les goulots d'étranglement. Optimisez votre flux de travail en fonction de ces informations.
- Tirez parti des modèles pré-formés : Pour les applications d'apprentissage automatique, envisagez d'utiliser des modèles pré-entraînés disponibles via NGC de Nvidia (disponible sur Rescale), qui sont optimisés pour les GPU Nvidia et peuvent accélérer le développement.
Optimisation des charges de travail pour les puces Arm
Lorsque vous utilisez des processeurs Arm sur Rescale, envisagez les stratégies suivantes :
- Optimiser pour l’efficacité énergétique : Concevez votre flux de travail pour tirer parti de l'efficacité énergétique d'Arm, particulièrement bénéfique pour les simulations de longue durée et le traitement de données à grande échelle.
- Utilisez les bibliothèques optimisées pour Arm : Utilisez des bibliothèques et des frameworks spécifiquement optimisés pour l'architecture Arm, tels que les bibliothèques de performances Arm qui contiennent des implémentations BLAS, LAPACK et FFTW hautement optimisées.
- Tirer parti du multithreading : Les processeurs Arm comportent souvent plusieurs cœurs. Assurez-vous que vos applications sont conçues pour exploiter le multithreading afin de maximiser le débit de calcul, car de nombreuses applications disponibles sur Rescale le sont déjà.
- Profil et réglage : Utilisez des outils de profilage des performances tels que le profil de performances de Rescale pour identifier et atténuer les goulots d'étranglement des performances et optimiser les coûts de votre flux de travail.
Cas d'utilisation : accélération de la dynamique des fluides computationnelle avec les GPU Nvidia sur Rescale
Cette étude de cas explore les avantages pratiques de l'exploitation des GPU Nvidia sur Rescale pour accélérer considérablement vos charges de travail de dynamique des fluides computationnelle (CFD). Découvrez comment cette puissante combinaison permet de gagner beaucoup de temps et d’efficacité.
Énoncé du problème
Une équipe d'ingénieurs de F1 développe un modèle CFD pour simuler le flux d'air sur la géométrie complète d'une voiture de course. Le modèle nécessite la résolution de grands systèmes d’équations, ce qui nécessite beaucoup de calculs et prendrait beaucoup de temps sur des processeurs standards.
Solution
L'équipe choisit d'exploiter les GPU Nvidia sur Rescale pour accélérer le processus de simulation. Voici comment ils y sont parvenus :
- Préparation des données: L'équipe prétraite les données de géométrie et de maillage, puis les télécharge sur le stockage cloud de Rescale.
- Choix du matériel: Ils sélectionnent un coretype Rescale équipé de GPU Nvidia A100, connus pour leurs hautes performances dans les tâches de calcul parallèle.
- Exécution de simulations: L'équipe sélectionne un code de solveur CFD qui utilise CUDA pour le traitement parallèle. Le solveur ANSYS Fluent est configuré pour tirer parti des capacités du GPU.
- Optimisation et mise à l'échelle: À l'aide des outils de profil de performance de Rescale, ils identifient les goulots d'étranglement en matière de performances et optimisent le flux de travail. De plus, ils étendent la simulation sur plusieurs GPU afin de réduire davantage le temps de calcul pour une solution rentable.
Résultats
En utilisant les GPU Nvidia sur Rescale, l'équipe réduit le temps de simulation de plusieurs jours à quelques heures, permettant une itération plus rapide et une analyse plus approfondie. Cette accélération permet à l'équipe d'explorer davantage de variantes de conception et d'améliorer l'efficacité globale de leurs simulations. Le graphique ci-dessous illustre qu'il y a presque 8X augmentation des performances lors du passage des flux de travail CPU traditionnels aux GPU Nvidia.

Tendances et considérations futures pour le HPC en ingénierie et en science
À mesure que le domaine du HPC continue d'évoluer, plusieurs tendances et considérations façonneront l'avenir de l'ingénierie informatique et de la recherche scientifique :
- Émergence de nouvelles architectures : Les architectures émergentes telles que l'informatique quantique et les puces neuromorphiques élargiront encore les possibilités d'accélération spécifique à un domaine.
- Intégration de l'IA et du HPC : La convergence de l’IA avec le HPC entraînera le développement d’accélérateurs matériels plus spécialisés. Des plateformes comme Rescale joueront un rôle crucial pour donner accès à ces ressources de pointe.
- Accent mis sur la durabilité : L’efficacité énergétique et la durabilité deviendront de plus en plus importantes dans le HPC. L'architecture basse consommation d'Arm le positionne bien pour répondre à ces demandes, et les innovations en cours continueront d'améliorer l'efficacité énergétique des ressources informatiques.
Conclusion
L'exploitation d'accélérateurs matériels spécifiques à un domaine tels que les GPU Nvidia et les puces Arm sur des plates-formes telles que Rescale offre des avantages significatifs pour l'ingénierie et les calculs scientifiques. En optimisant les charges de travail pour ces architectures spécialisées, les chercheurs et les ingénieurs peuvent atteindre des niveaux de performances et d'efficacité sans précédent, leur permettant de résoudre des problèmes plus complexes et d'accélérer l'innovation. À mesure que la technologie progresse, la capacité d’accéder et d’utiliser de manière transparente ces puissantes ressources informatiques sera un facteur clé du succès des efforts scientifiques et techniques.
Références
NVIDIA respecte la loi de Huang : une vidéo montre comment les ingénieurs maintiennent les accélérations à venir https://blogs.nvidia.com/blog/huangs-law-dally-hot-chips/
Vous souhaitez en savoir plus sur l’exploitation d’architectures spécialisées ?
Planifiez une démo avec l'un de nos experts
