
L’une des principales critiques adressées au HPC dans le cloud est la vitesse d’interconnexion relativement lente entre les nœuds par rapport aux clusters sur site. Alors qu'un certain nombre de fournisseurs de niche proposent la connectivité InfiniBand pour combler cette lacune, Microsoft est le premier fournisseur majeur à proposer ce type d'interconnexion à large bande passante et à faible latence avec son nouveau Gros calcul solution. Il s’agit d’une nouvelle passionnante, car relativement peu d’entreprises disposent des ressources nécessaires pour gérer des centres de données à grande échelle tout en traitant des problèmes de conformité en matière de sécurité et des certifications nécessaires pour que les entreprises puissent déplacer leurs charges de travail vers le cloud. Juste ou non, le soutien de Microsoft, d'Amazon ou de Google peut faire une grande différence pour obtenir l'adhésion de l'entreprise en informatique.
Selon spécifications, les nouvelles tailles d'instance A8 et A9 offrent une connectivité InfiniBand avec RDMA. Ce dernier élément est particulièrement important car, comme ce blog le souligne à juste titre, avoir InfiniBand seul ne suffit pas. Le transport utilisé fait une différence cruciale et TCP fonctionne très mal. Les instances Big Compute prennent en charge le RDMA virtualisé qui offre des performances quasi nues selon Microsoft. Cette annonce devrait être une aubaine pour les utilisateurs souhaitant exécuter des simulations étroitement couplées dans le cloud. Ce type d’application MPI « bavarde » est très sensible à la latence du réseau sous-jacent. Cependant, après avoir essayé la plate-forme, je pense qu'il existe quelques barrières à l'entrée dans son incarnation actuelle.
Premièrement, les fonctionnalités RDMA sont exposées via une interface appelée Network Direct qui n'est actuellement prise en charge que par l'implémentation MPI de MS-MPI-Microsoft. Les applications devront être recompilées avec ces bibliothèques. Ce n’est pas un obstacle trop important puisque MPI est une norme bien définie et que MS-MPI est basé sur MPICH, qui est largement pris en charge. Un problème plus important, cependant, est que les applications devront être écrites pour fonctionner sous Windows. Heureusement, de nombreuses applications d'ingénierie populaires utilisées aujourd'hui disposent déjà de versions Windows prenant en charge MS-MPI. Du moins de manière anecdotique, il semble que les applications puissent être recompilées avec Peu d'effort.
Deuxièmement, la configuration d'un cluster MPI est très différente dans le monde Windows par rapport à Linux. Même si Windows est certainement capable de proposer des performances impressionnantes Référence MPI chiffres, la grande majorité des praticiens HPC fonctionnent actuellement sous Linux. La configuration d'un cluster MPI dans le cloud pour Linux se résume généralement à : "Lancez vos instances, utilisez le gestionnaire de packages pour installer la version MPI de votre choix, configurez SSH sans mot de passe entre tous les nœuds de votre cluster et créez un fichier machine". Sous Windows, l'approche recommandée consiste à installer et configurer HPC Pack sur un boîtier Windows Server (soit sur site, soit dans le cloud). Cela peut être difficile pour quelqu'un qui connaît Linux et qui ne connaît pas les nuances de l'administration des serveurs Windows. Bien que la solution HPC Pack soit robuste et complète, elle semble un peu lourde si vous souhaitez simplement exécuter quelques benchmarks ou une simple simulation ponctuelle. Ce qui serait bien, c'est un outil comme Amas d'étoiles pour que les gens soient opérationnels le plus rapidement possible sans avoir à configurer Active Directory, à installer SQL Server ou à comprendre les API Powershell et REST.
Il s'avère que vous pouvez installer MS-MPI sur Azure sans HPC Pack, mais il ne semble pas y avoir beaucoup de conseils sur la façon de procéder. De plus, un certain nombre de serveurs SSH et d'utilitaires UNIX ont été portés sur Windows. Nous recherchions un moyen plus simple de lancer un cluster MPI sous Windows sans avoir à installer, configurer et gérer une instance HPC Pack distincte. Ce que nous avons fini par expérimenter, c'est d'utiliser l'offre PaaS pour déployer un service Cloud contenant un ensemble de tâches de démarrage pour effectuer les opérations suivantes sur chaque nœud :
- Installez MS-MPI (un programme d'installation autonome est disponible) ici)
- Lancer SMPD
- Installer et configurer un serveur OpenSSH et un ensemble standard d'utilitaires de ligne de commande UNIX
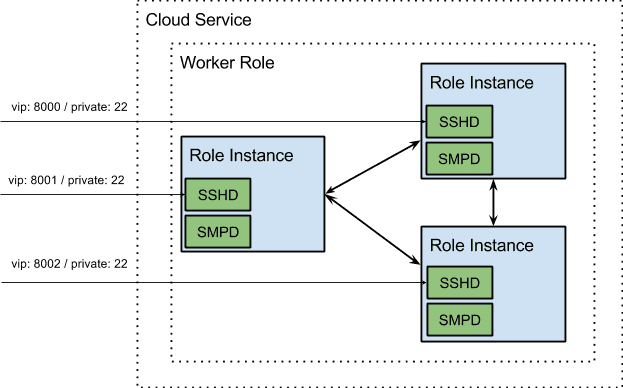
Chaque projet récompensé par un Service Cloud a une seule adresse IP virtuelle (VIP) qui lui est attribuée. Pour contourner ce problème, nous avons utilisé des points de terminaison internes d'instance pour permettre aux utilisateurs de se connecter en SSH à des nœuds individuels à l'aide de différents ports. Les points de terminaison internes sont ouverts afin que chaque instance de rôle puisse se connecter au démon SMPD exécuté sur les autres. Le résultat final de tout cela est un fichier .cspkg facile à déployer et le fichier XML de configuration qui l'accompagne. Les utilisateurs peuvent se connecter en SSH aux instances de rôle et utiliser les commandes UNIX qu'ils connaissent et avec lesquelles ils sont familiers.
Nous voulions effectuer quelques tests de latence et de bande passante sur 2 instances A9. Tout d'abord, nous avons recompilé les benchmarks osu_latency et osu_bibw de la bibliothèque OSU Microbenchmark avec MS-MPI. Ensuite, nous avons déployé le service Cloud ci-dessus, copié l'exécutable de référence sur chaque machine avec SCP (notez que SCP n'est pas une solution viable si vous avez des fichiers volumineux qui doivent être déplacés, mais cela fonctionne bien pour les fichiers plus petits comme ces exécutables de référence) . Enfin, nous nous sommes connectés en SSH à l'un des nœuds et avons lancé les exécutables :
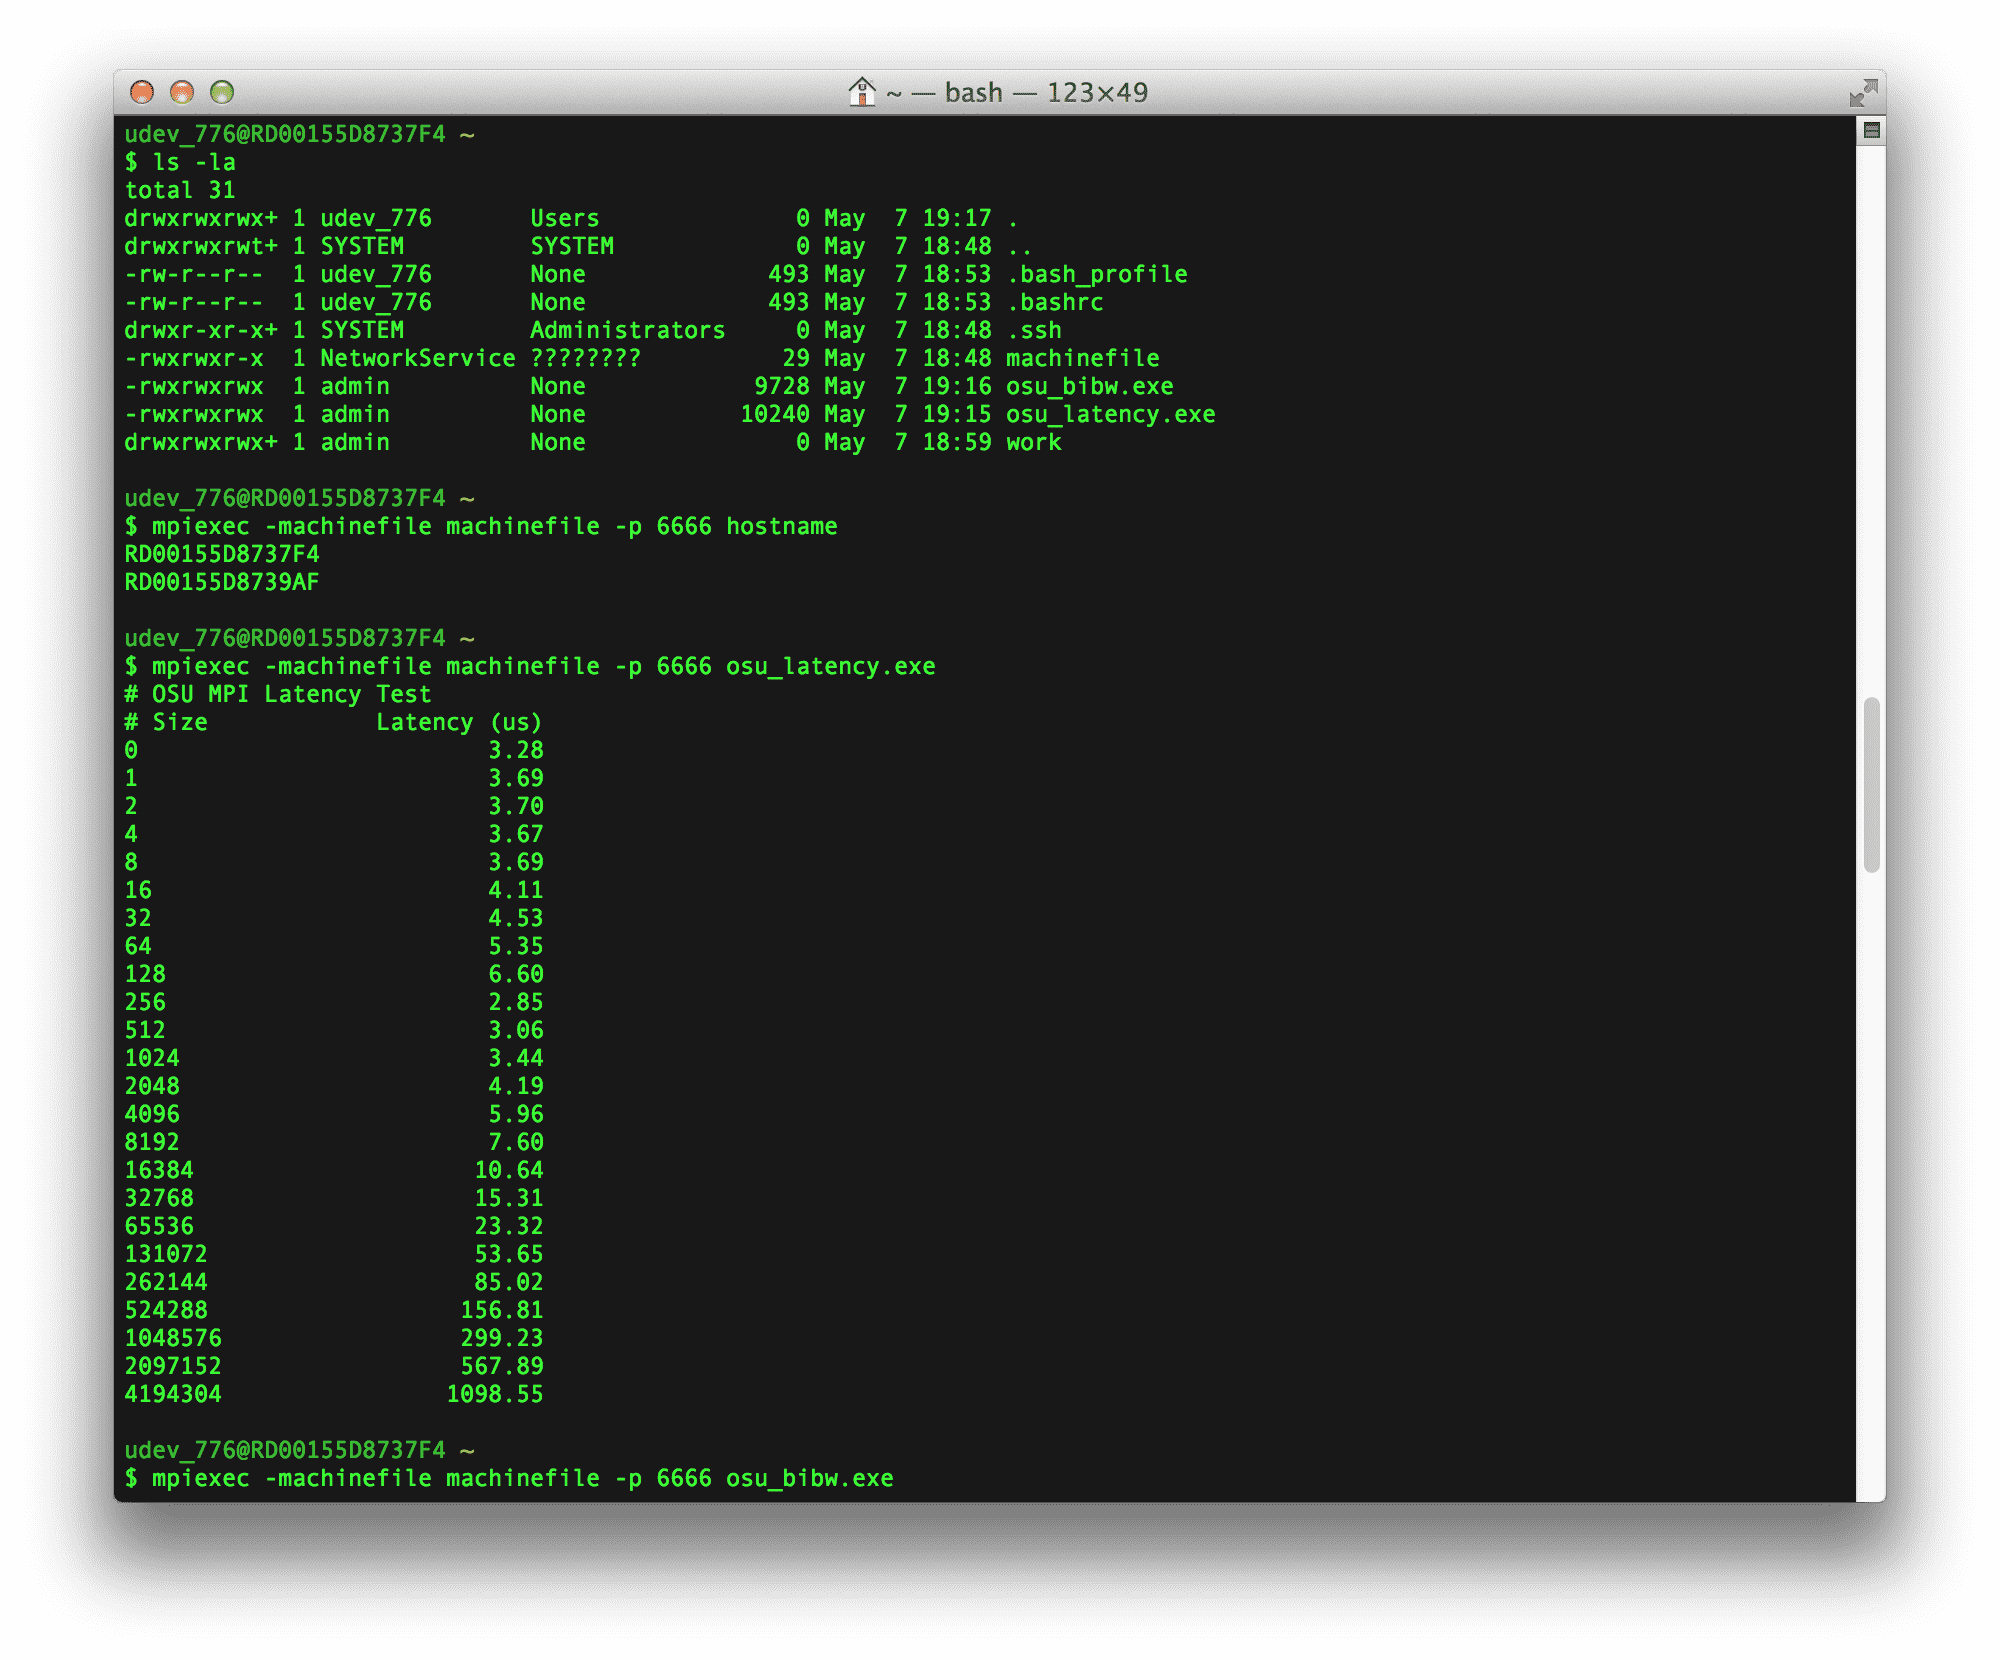
Les résultats des benchmarks sont ci-dessous. Comme vous pouvez le voir, les chiffres de latence de 0 octet sont d'environ 3us et nous constatons qu'environ 7.5 Go/s sont transférés dans le test de bande passante bidirectionnelle pour des messages de plus grande taille, ce qui est assez proche de la saturation complète.
# OSU MPI Latency Test

# Size         Latency (us)

0                      3.28

1                      3.69

2                      3.70

4                      3.67

8                      3.69

16                     4.11

32                     4.53

64                     5.35

128                    6.60

256                    2.85

512                    3.06

1024                   3.44

2048                   4.19

4096                   5.96

8192                   7.60

16384                 10.64

32768                 15.31

65536                 23.32

131072                53.65

262144                85.02

524288               156.81

1048576              299.23

2097152              567.89

4194304             1098.55

# OSU MPI Bi-Directional Bandwidth Test

# Size Bi-Bandwidth (MB/s)

1                      0.43

2                      0.87

4                      1.69

8                      3.35

16                     6.82

32                    13.69

64                    18.64

128                   29.12

256                  486.75

512                 1174.69

1024                2170.21

2048                3844.66

4096                5982.22

8192                2873.87

16384               7078.87

32768               6669.85

65536               4926.26

131072              4878.30

262144              5853.30

524288              6674.26

1048576             7066.08

2097152             7344.74

4194304             7479.30
Ce sont des chiffres de performances très impressionnants. Je soupçonne cependant que le véritable point de bascule pour l'utilisation du Big Compute se produira une fois que Microsoft ajoutera la prise en charge des machines virtuelles Linux avec sa solution IaaS. La documentation disponible en ligne ne précise pas clairement le calendrier actuel (la prise en charge IaaS pour Windows Server a récemment été ajoutée). Il sera intéressant de voir comment se dérouleront les nouvelles guerres d'interconnexion à faible latence en 2014. Comme toujours, Rescale a l'intention de rester agnostique quant aux fournisseurs et d'offrir à nos clients le meilleur matériel disponible.
