
L’un des principaux défis de CHP en nuage minimise la quantité de données, qui doit être transféré entre les machines sur site et les machines dans le cloud. Contrairement aux systèmes sur site traditionnels, ce transfert s'effectue sur un réseau étendu beaucoup plus lent et moins fiable. Comme nous l'avons évoqué précédemment, la meilleure chose à faire est d'effectuer le post-traitement à distance et d'éviter de transférer des données inutilement.
Cela dit, un scénario courant pour de nombreux utilisateurs est d’exécuter un simulation et transférez ensuite tous les fichiers de sortie du travail vers leur poste de travail.
Une fois le travail terminé, chaque fichier du répertoire de travail est chiffré et téléchargé vers le cloud stockage hpce. Cela offre une certaine flexibilité aux utilisateurs qui n'ont besoin de télécharger qu'un petit sous-ensemble des fichiers de sortie sur leur machine. Cependant, le compromis est que chaque fichier introduit une surcharge supplémentaire dans le transfert. Lors du transfert de données sur un réseau, plus il y a de données qui peuvent être regroupées dans un seul fichier, mieux c'est. De plus, de nombreux codes d'ingénierie émettront des fichiers hautement compressibles. Bien que la compression d'un fichier prenne plus de temps, cela peut toujours être un gain net si le temps passé à compresser et à transférer un fichier plus petit est inférieur au temps passé à télécharger l'archive plus volumineuse et non compressée. Même si la compression et le transfert qui s'ensuit prennent plus de temps dans l'ensemble, le véritable goulot d'étranglement dans le processus de transfert global sera le dernier saut entre le stockage cloud et le poste de travail de l'utilisateur. Avoir un fichier compressé plus petit à transférer ici peut faire une énorme différence en fonction de la vitesse de connexion Internet de l'utilisateur.
Si vous savez à l'avance que vous devrez télécharger tous les fichiers de sortie pour une tâche, il est généralement préférable de générer d'abord un seul fichier d'archive compressé au lieu de transférer chaque fichier individuellement. La commande Linux tar offre un moyen simple de créer une archive compressée, mais elle n'utilise pas la puissance de calcul supplémentaire disponible sur le cluster MPI pour générer l'archive.
Jeff Gilchrist a développé un compresseur bz2 facile à utiliser qui fonctionne sur des clusters MPI (https://compression.ca/mpibzip2/). Nous avons compilé un binaire Linux avec une référence de bibliothèque statique bzip2 et l'avons rendu disponible ici à télécharger pour faciliter son intégration dans vos propres travaux. Le binaire a été construit avec le compilateur wrapper OpenMPI 1.6.4 mpic++. Veuillez noter qu'il faudra peut-être le recompiler en fonction de la version MPI que vous utilisez.
Pour l'utiliser, téléchargez l'exécutable mpibzip2 en tant que fichier d'entrée supplémentaire sur votre travail. Ensuite, les commandes suivantes doivent être ajoutées à la fin de la commande d'analyse sur la page des paramètres de la tâche.
tar cf files.tar –exclude=mpibzip2 *
mpirun -np 16 mpibzip2 -v fichiers.tar
trouver ! -name 'files.tar.bz2' -type f -exec rm -f {} +
Tout d'abord, un fichier tar est créé appelé files.tar qui contient tout sauf l'utilitaire parallèle bzip. Ensuite, nous lançons l'exécutable mpibzip2 et générons une archive compressée appelée files.tar.bz2. Enfin, tous les fichiers sauf files.tar.bz2 sont supprimés. Cela empêche à la fois les fichiers individuels ET l'archive compressée d'être téléchargés sur le stockage cloud.
Notez que l'argument -np sur l'appel mpirun doit refléter le nombre de cœurs dans le cluster. Ici, les commandes sont exécutées sur un cluster à 16 cœurs Nickel.
Une chose supplémentaire à prendre en compte est que Windows ne prend pas en charge les fichiers bz2 ou tar par défaut. 7-Zip peut être installé pour ajouter la prise en charge de ce format ainsi que de nombreux autres.
À titre de test rapide, nous avons créé des archives compressées à partir d'une tâche OpenFOAM contenant 2.1 Go de données de sortie réparties sur 369 fichiers et avons téléchargé le fichier résultant sur le stockage cloud.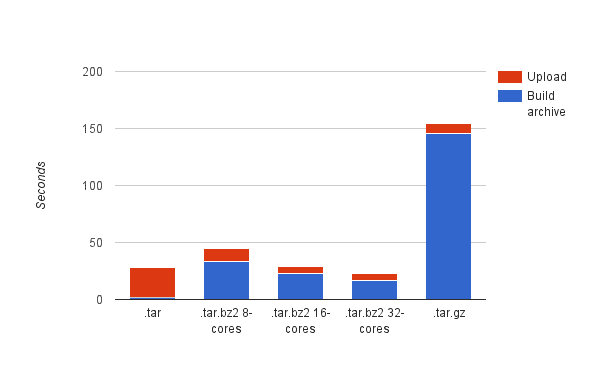
Comme référence, nous avons créé un fichier tar non compressé. Nous avons également essayé de créer un fichier tar compressé gzip en utilisant l'indicateur -z avec la commande tar. Enfin, nous avons essayé de créer une archive compressée bz2 avec 8, 16 et 32 cœurs Nickel.
Sans surprise, dans le cas de base, la création de l’archive prend un temps négligeable et la majorité du temps global est consacrée au téléchargement du fichier le plus volumineux. Lors de la compression du fichier, la répartition globale du temps est inversée : la majorité du temps est consacrée à la compression du fichier. Sans surprise également, l’exploitation de plusieurs cœurs offre une accélération intéressante par rapport à l’utilisation de la prise en charge gzip monocœur fournie avec la commande tar. Avec environ 16 cœurs, la durée globale est à peu près la même que celle du cas de référence.
Le véritable gain de l'étape de compression deviendra cependant évident lorsqu'un utilisateur tentera de télécharger la sortie sur son poste de travail local, car le fichier bz2 compressé est presque 5 fois plus petit que le fichier tar non compressé (439 Mo contre 2.1 Go).
Pour réitérer, nous pensons que transférer une grande partie de votre post-traitement et de votre visualisation dans le cloud est le meilleur moyen de minimiser le transfert de données. Cependant, dans les cas où un grand nombre de fichiers de sortie sont nécessaires, vous pouvez réduire considérablement vos temps de transfert dans de nombreux cas en consacrant un peu de temps à préparer une archive compressée à l'avance. Nous prévoyons d'automatiser de nombreuses étapes manuelles décrites dans cet article et d'en faire un processus plus transparent à l'avenir. Restez à l'écoute!
