
Réduction du temps de calcul pour les simulations de plusieurs points de fonctionnement lors du rescale
Introduction
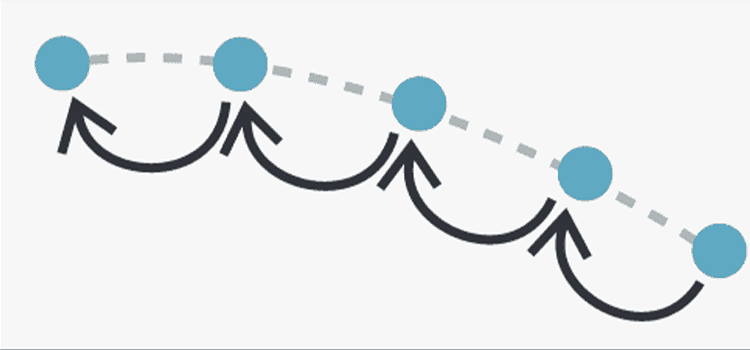
Les simulations informatiques sont souvent utilisées pour examiner le comportement d'un système dans diverses conditions, telles que les simulations de dynamique des fluides computationnelle (CFD) d'une aile fonctionnant à une plage de nombres de Mach ou d'un compresseur de moteur à réaction à différents rapports de pression. Ces simulations sont coûteuses en calcul et peuvent prendre de quelques heures à quelques jours. Une stratégie pour réduire le temps de résolution consiste à utiliser une meilleure condition initiale pour démarrer la simulation. En fournissant au solveur une condition initiale « plus proche » de la solution finale, moins d’itérations sont nécessaires et le temps de calcul est réduit. Fournir une condition initiale appropriée peut également améliorer la stabilité de la simulation, en particulier aux points de fonctionnement présentant une physique complexe telle que le décrochage des ailes.
Dans cet article, nous allons simuler l'écoulement turbulent autour d'une aile pour une plage de nombres de Mach allant de 0.5 à 0.9 à un angle d'attaque d'environ 3 degrés, et les résultats du calcul précédent seront utilisés comme condition initiale pour le prochain. (par exemple, les résultats pour Mach 0.5 seront utilisés pour initialiser le calcul de Mach 0.6). Le turbulent ONERA M6 tutoriel pour le solveur CFD open source Stanford University Unstructured (SU2) sert de base à ces calculs. Le maillage et les fichiers de configuration utilisés ici proviennent du SU2 Github référentiel. Bien que l'utilisation d'une solution précédente comme entrée pour le calcul suivant ait toujours été possible à l'aide de l'interface Rescale, le nouveau SDK Python « d'optimisation personnalisée » permet aux utilisateurs de le faire par programme et au sein d'une seule tâche.
Vous pouvez utiliser les liens suivants pour cloner ou afficher la tâche et suivre :
Cloner des tâches
Voir l'emploi
Développement de scripts Python
La première étape consiste à développer le script Python pour exécuter les calculs et modifier le fichier de configuration SU2 pour la tâche. Un concept similaire de « modèle » utilisé dans les travaux de conception d'expériences sera utilisé ici. Plusieurs lignes du fichier de configuration input-template.cfg sont modifiées pour permettre aux valeurs d'être renseignées par le script Python (comme ci-dessous pour définir le nombre de Mach). Le modèle de fichier de configuration complet peut être trouvé dans le travail.
%--- DÉFINITION DU FLUX LIBRE COMPRESSIBLE ---% % % Nombre de Mach (non dimensionnel, basé sur les valeurs du flux libre) MACH_NUMBER= ${Mach} % % Angle d'attaque (degrés, uniquement pour les flux compressibles) AoA = 3.06
Le script Python utilisé pour exécuter les calculs est donné ci-dessous dans son intégralité. Nous discuterons ensuite de chacune des parties, en soulignant les concepts importants et en fournissant des suggestions. Notez qu'un calcul SU2 produit un fichier de « redémarrage » spécifique dans le but de démarrer un autre calcul. Ce fichier de redémarrage contient les valeurs des primitives de solution à chaque point de nœud.
import optimisation_sdk as rescale import os import Shutil CONFIG_TEMPLATE_FILE = 'input-template.cfg' MESH_FILE = 'mesh.su2' # Fonction d'assistance pour remplir le modèle def replace_in_file(filepath, pattern, replacement): with open(filepath, 'r') as f: data = f.read() data = data.replace(pattern, replacement) with open(filepath, 'w') as f: f.write(data) # Définir les points de fonctionnement (en Mach) op_points = ( 0.5, 0.6, 0.7, 0.8, 0.9) # Définir un nombre global d'exécutions rescale_run = 1 # Boucler les points de fonctionnement pour mach dans op_points : print "Run: %d Mach: %0.4f..." % (rescale_run, mach ) # Copiez le fichier de configuration du modèle d'entrée et remplissez config_run = 'input-%d.cfg' % rescale_runshutil.copyfile(CONFIG_TEMPLATE_FILE, config_run) replace_in_file(config_run, "${Mach}", str(mach)) input_files = [config_run , MESH_FILE] # Définir le fichier « restart » résultant du calcul restart_file = 'restart_file_%d.dat' % rescale_run replace_in_file(config_run, "${Restart-file-out}", restart_file) output_files = [restart_file] # Configurer le solveur pour redémarrer à partir de la solution précédente si rescale_run != 1 : # Le redémarrage est possible replace_in_file(config_run, "${Restart}", 'YES') restart_file_previous = 'restart_file_%d.dat' % (rescale_run - 1) input_files.append( restart_file_previous) else: # Ceci est la première exécution, donc aucun redémarrage n'est possible replace_in_file(config_run, "${Restart}", 'NO') restart_file_previous = 'none' replace_in_file(config_run, "${Restart-file-in}" , restart_file_previous) # Générez la commande pour exécuter SU2 sur le cluster de calcul et soumettez-la ! command = 'parallel_computation.py -n $RESCALE_CORES_PER_SLOT -f %s' % config_run run = rescale.submit( command, input_files=input_files, output_files=output_files, var_values={'Mach': mach} ) # Attendez la fin de l'exécution et incrémenter le numéro d'exécution run.wait() rescale_run += 1
En commençant par le premier bloc,
importer optimisation_sdk en tant que redimensionnement importer os importer fermer CONFIG_TEMPLATE_FILE = 'input-template.cfg' MESH_FILE = 'mesh.su2'
Ici, nous importons les modules Python os etshul qui sont utiles pour les opérations sur les fichiers. Cependant, le plus important est le SDK d'optimisation Rescale qui est utilisé pour soumettre des exécutions. Ce module sera placé automatiquement sur le chemin Python lors de l'exécution d'un travail d'optimisation personnalisé. Les noms de fichiers du modèle de configuration et du maillage sont également déclarés.
# Définir les points de fonctionnement (en Mach) op_points = (0.5, 0.6, 0.7, 0.8, 0.9) # Définir un nombre global de courses rescale_run = 1 # Boucler les points de fonctionnement pour mach en op_points : print "Run: %d Mach : %0.4f..." % (rescale_run, mach) # Copiez le fichier de configuration du modèle d'entrée et remplissez config_run = 'input-%d.cfg' % rescale_runshutil.copyfile(CONFIG_TEMPLATE_FILE, config_run) replace_in_file(config_run, "${Mach }", str(mach)) input_files = [config_run, MESH_FILE] # Définir le fichier « restart » résultant du calcul restart_file = 'restart_file_%d.dat' % rescale_run replace_in_file(config_run, "${Restart-file-out} ", restart_file) output_files = [restart_file]
Dans ce bloc, nous définissons d'abord une liste de nombres de Mach, représentant chacun des points de fonctionnement, et un nombre global d'exécutions est défini (rescale_run). Ce nombre d'exécutions n'est pas obligatoire, mais il est utile à des fins de suivi. Nous entrons ensuite dans une boucle for pour exécuter chacun des points de fonctionnement. Un fichier de configuration spécifique à l'exécution est créé et rempli avec le numéro de Mach souhaité. Ensuite, nous définissons une liste de noms de fichiers d'entrée pour l'exécution, à savoir le fichier de configuration et le fichier de maillage. Ces fichiers seront transférés du nœud d'optimisation vers le(s) nœud(s) de calcul. Enfin, le fichier « restart » résultant du calcul est nommé restart_file_.dat et défini dans le fichier de configuration. Ce fichier de redémarrage est ajouté à une liste de fichiers de sortie qui seront retransférés du ou des nœuds de calcul vers le nœud d'optimisation une fois l'exécution terminée.
Notez que les blocs restants se trouvent tous dans la boucle for définie ci-dessus.
# Configurez le solveur pour qu'il redémarre à partir de la solution précédente si rescale_run != 1 : # Le redémarrage est possible replace_in_file(config_run, "${Restart}", 'YES') restart_file_previous = 'restart_file_%d.dat' % (rescale_run - 1) input_files .append(restart_file_previous) else : # Ceci est la première exécution, donc aucun redémarrage n'est possible replace_in_file(config_run, "${Restart}", 'NO') restart_file_previous = 'none' replace_in_file(config_run, "${Restart-file- dans}", restart_file_previous)
Ici, nous définissons la condition initiale du solveur. S'il ne s'agit pas de la première exécution, un fichier de redémarrage est disponible pour définir la condition initiale. Dans ce cas, le fichier de configuration est configuré pour utiliser le fichier de redémarrage de l'exécution précédente et ce fichier de redémarrage est ajouté à la liste des fichiers d'entrée. S'il s'agit de la première exécution, aucun fichier de redémarrage n'est disponible et cela est défini dans le fichier de configuration.
# Générez la commande pour exécuter SU2 sur le cluster de calcul et soumettez-la ! command = 'parallel_computation.py -n $RESCALE_CORES_PER_SLOT -f %s' % config_run run = rescale.submit( command, input_files=input_files, output_files=output_files, var_values={'Mach': mach} )
La commande pour exécuter le calcul est définie ensuite. Parallel_computation.py est un script wrapper Python fourni par SU2 pour effectuer des calculs multicœurs. Notez l'utilisation de $RESCALE_CORES_PER_SLOT pour définir le nombre de cœurs. Cette variable d'environnement est automatiquement créée pour vous en fonction de vos paramètres matériels. L'exécution est ensuite soumise, en spécifiant la commande à exécuter, les fichiers d'entrée et de sortie, et enfin les valeurs des variables pour cette exécution (dans ce cas uniquement le nombre de Mach).
# Attendez la fin de l'exécution et incrémentez le numéro d'exécution run.wait() rescale_run += 1
Dans le dernier bloc, nous demandons au script d'attendre la fin de l'exécution avant de continuer la boucle for et d'incrémenter le nombre d'exécutions. Le fichier de redémarrage de l'exécution est automatiquement transféré du ou des nœuds de calcul vers le nœud d'optimisation car nous l'avons déclaré comme fichier de sortie.
Exécuter le travail lors de la redimensionnement
Après avoir développé le script Python, nous passons maintenant à l'exécution du travail sur la plateforme Rescale. Le « Type de travail » est défini sur « Optimisation » et un fichier zip MachOpPoints.zip contenant le script Python, le fichier de maillage et le fichier de modèle de configuration est téléchargé en tant que fichier d'entrée.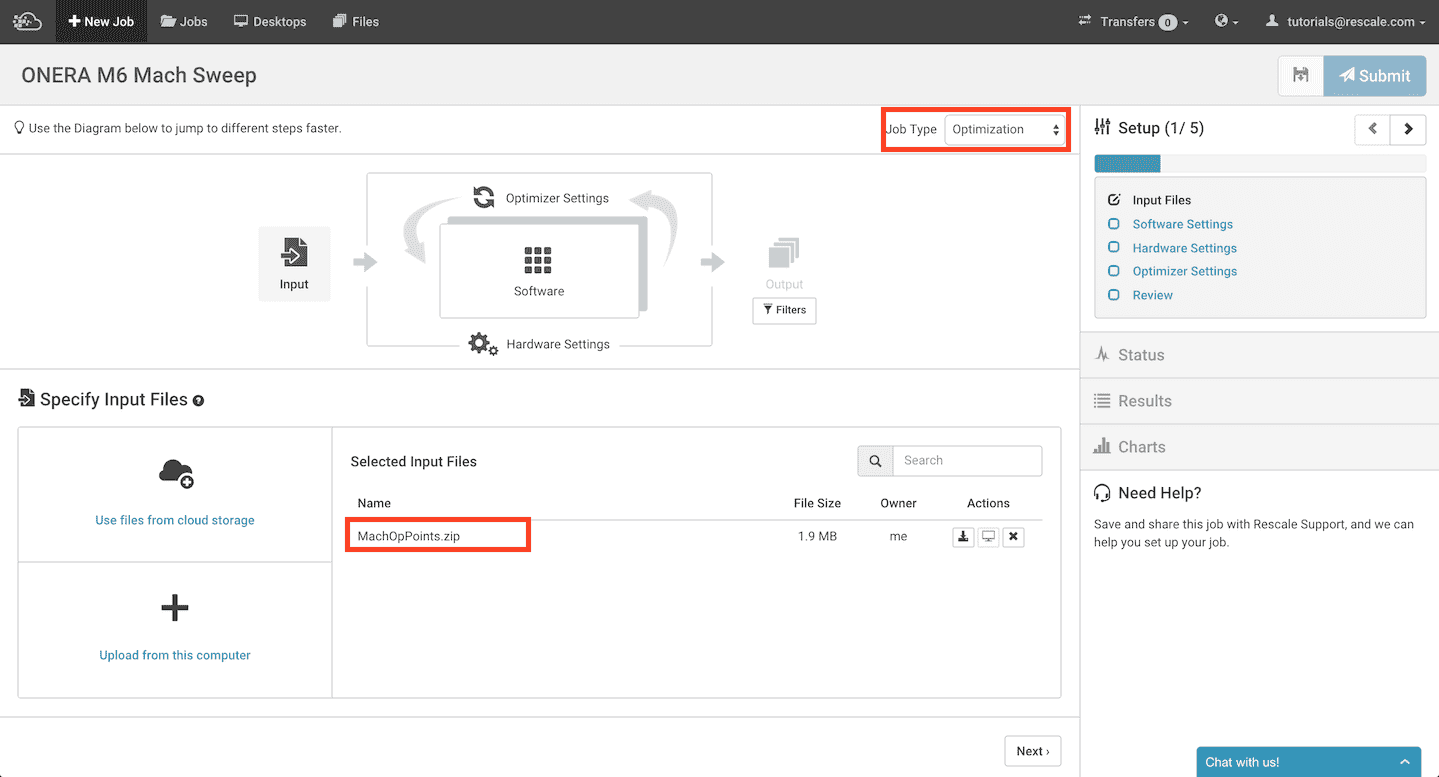
Sous « Paramètres de l'optimiseur », l'option « Personnalisé » et la commande sont définies pour exécuter le script Python (python runOpPoints.py). SU2 a également été sélectionné comme logiciel pour ce travail.
Enfin, nous sélectionnons 4 cœurs Nickel par slot et un seul slot (car les calculs sont exécutés les uns après les autres) sur la page « Paramètres matériels ». Nous sommes maintenant prêts à soumettre le travail !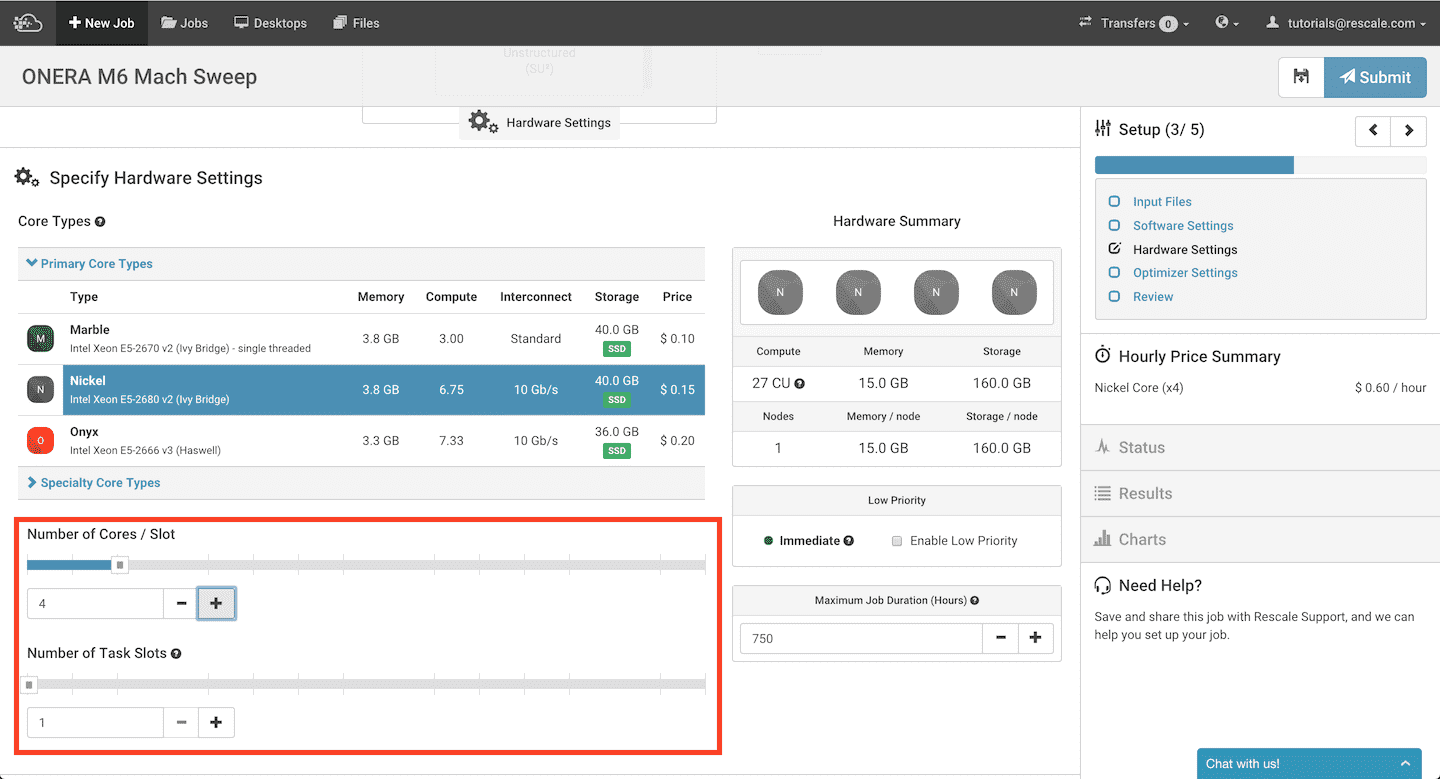
Chacun des points de fonctionnement apparaîtra comme un « exécution enfant » de l'exécution 1 (étiquetée 1.1, 1.2…). Vous pouvez suivre en direct les fichiers de chacun des calculs. Dans l'image ci-dessous, nous examinons le fichier process_output.log, qui contient les informations résiduelles de SU2, pour le troisième calcul (Mach 0.7)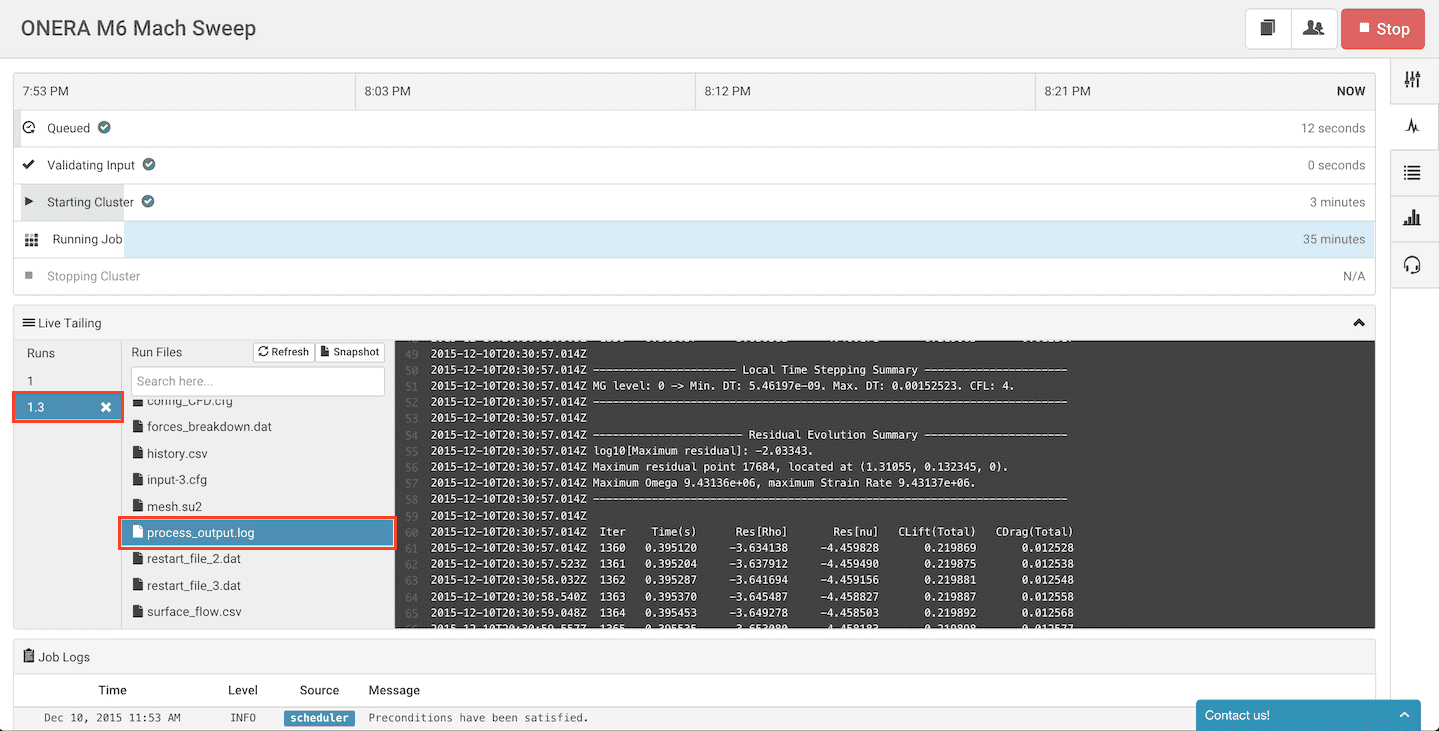
Le travail prend environ une heure. Une fois terminé, l'onglet « Résultats » apparaîtra comme ci-dessous et les 5 courses pourront être vues.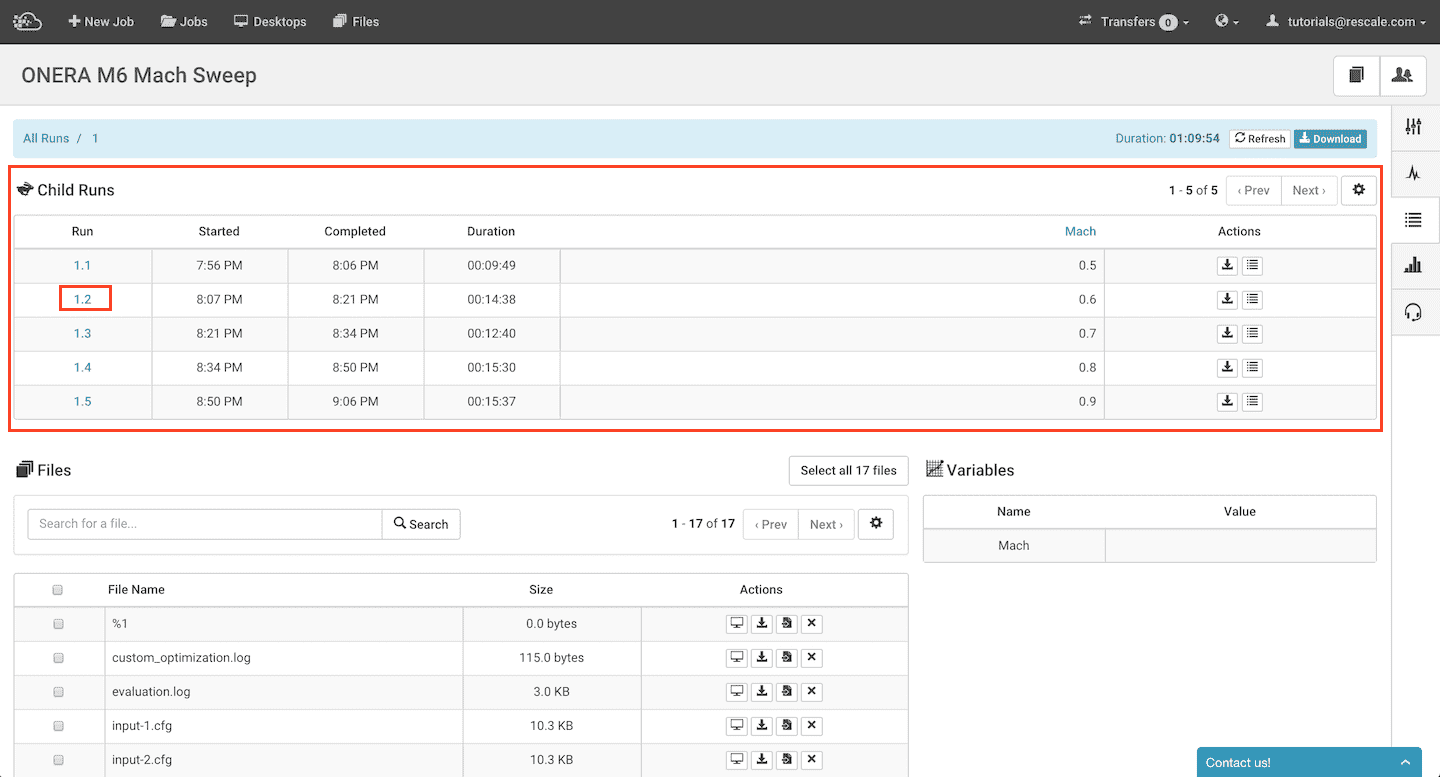
En cliquant sur la deuxième exécution 1.2, les fichiers spécifiques à ce travail sont affichés.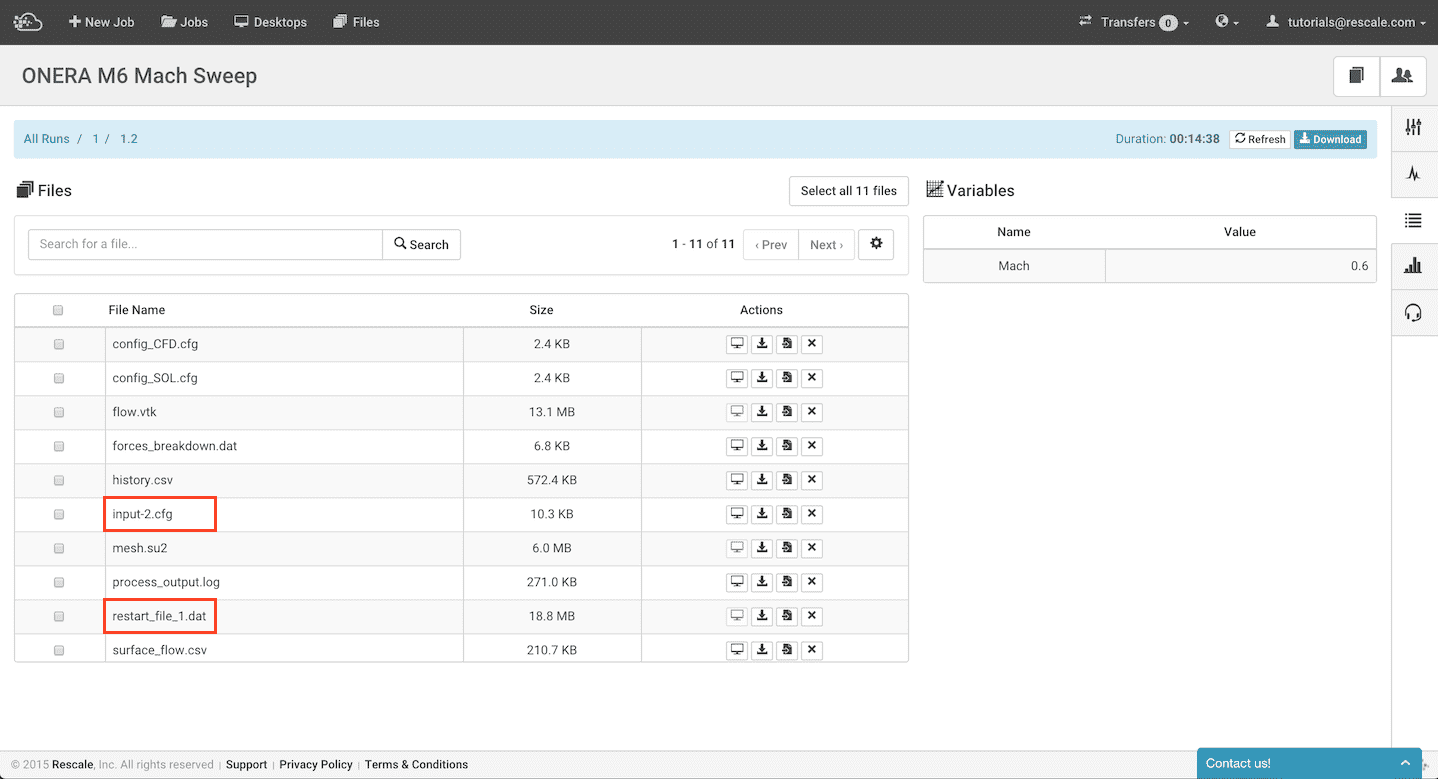
Nous voyons le fichier de configuration input-2.cfg produit par le script Python ainsi que le fichier de redémarrage restart_file_1.dat de l'exécution précédente. En examinant le fichier process_output.log, nous voyons la ligne :
Lisez la solution de flux à partir de : restart_file_1.dat.
confirmant que le calcul a été lancé en utilisant la condition initiale du fichier de redémarrage.
Si vous souhaitez obtenir plus d'informations sur la plateforme Rescale, veuillez nous contacter à l'adresse info@rescale.com.
