Lors de l'exécution HPC dans le cloud, L'un des workflow tâches ingénieurs et scientifiques devoir gérer est la manipulation de grandes quantités de données,. La question que l’ingénieur doit souvent se poser est : « Quelles données me sont utiles et comment puis-je les présenter sous une forme fonctionnelle ? » Lorsque toutes les données sont stockées dans le cloud, il est essentiel de minimiser le temps entre la génération des données et la possibilité de les utiliser pratiquement. Le simple téléchargement de gigaoctets de données n’est pas le moyen préféré ni le plus efficace.
Bien entendu, différentes applications visent des objectifs différents. Parfois, l'ingénieur souhaite que toutes les données de sortie soient stockées localement et facilement accessibles. D'autres fois, le cloud s'avère être un moyen pratique de stocker des données pour des projets et l'ingénieur peut, à tout moment, télécharger la date d'un sous-ensemble de tâches exécutées il y a des mois ; cependant, le délai d’exécution pour un travail HPC est essentiel. Il existe plusieurs approches pour minimiser le délai d'exécution des tâches gourmandes en données. Voici quelques moyens réels Redimensionner les clients minimisent le temps en optimisant la façon dont ils traitent les données.
LS-DYNA pré/post
Les tâches LS-DYNA peuvent générer une sortie de données volumineuse. C'est à l'utilisateur de décider quelles données génèrent son travail. La fréquence à laquelle l'exécution écrit sur le disque dur et les données écrites sont laissées à la discrétion de l'utilisateur. Cependant, l'ingénieur moyen n'est pas sûr à 100 % des données dont il aura besoin, mais pense avoir une bonne idée de ce qu'il finira par utiliser. L'ingénieur prend la décision de sauvegarder autant de données que possible dans des fichiers binaires et sait comment utiliser le script wrapper pratique de Rescale pour exécuter ses tâches LS-DYNA :
ls-dyna -n -s ; -je -p
L'ingénieur, cependant, économise la bande passante de téléchargement en utilisant l'option de post-traitement de ligne de commande intégrée de Rescale et en utilisant l'indicateur « -d » pour post-traiter ses fichiers d'entrée en un seul fichier .db :
ls-dyna -n 16 -s 4 -i big-model.k -p single -d create_postdb.inp
Parce qu'il connaît les informations dont il aura probablement besoin (déplacement, déformation plastique, contraintes de Von Mises et épaisseur), son fichier create_postdb.inp peut ressembler à ceci :
d3plot output.db state_on = 10, 20, 30, 40, 50, 60, 70, 80, 90, 100 déplacement plastic_strain von_mises_stress épaisseur
L'ingénieur n'a plus qu'à télécharger output.db avec toutes les informations souhaitées. Ainsi, au lieu de 35 Go de données, il télécharge un seul fichier de 1 Go. Au lieu d'attendre une heure et demie pour télécharger son fichier, le temps est réduit à quelques minutes seulement pour télécharger toutes les données dont il a besoin.
Post-traitement sur le cluster
Un autre ingénieur court Converger les CFD. Son travail vient de se terminer et a généré 40 Go de données. Heureusement, elle a configuré ses informations d'identification ssh sur la page des paramètres de Rescale :
Elle a saisi sa clé publique (que Rescale a mise sur tous ses nœuds Rescale) et a défini une règle CIDR afin que ses nœuds ne soient accessibles qu'à partir de son réseau. Les journaux de tâches lui ont indiqué comment se connecter au cluster :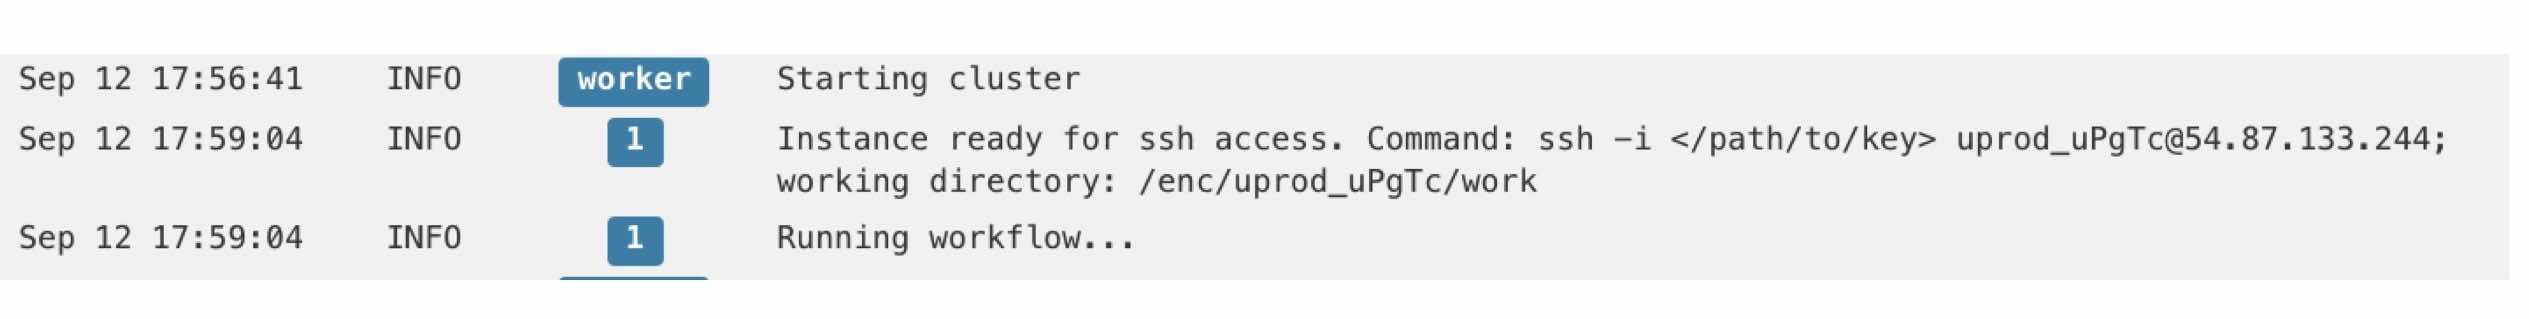
Elle peut désormais facilement se connecter à son cluster en copiant et collant la commande dans son terminal ou en utilisant Putty sous Windows. Une fois connectée à son nœud, elle exécute simplement :
post_convert
Cela lance l'outil de post-traitement pratique de Converge CFD qui lui permet de convertir des ensembles de données sélectionnés en Tecplot, Ensight ou d'autres formats traçables. Elle peut désormais utiliser scp ou sftp pour télécharger ces petits fichiers de tracé sur son disque dur local.
Je ne veux pas « synchroniser » le téléchargement de toutes mes données
Le premier ingénieur effectue de nombreuses tâches sur Rescale, mais lorsqu'il arrive au bureau chaque matin, il se rend compte que bon nombre de ses tâches ont été accomplies du jour au lendemain. Heureusement, au lieu de devoir télécharger manuellement tous ses fichiers de sortie, il a exécuté l'utilitaire de ligne de commande Java de Rescale pour télécharger des fichiers sur son disque dur chaque fois qu'un travail est terminé.
Après avoir demandé une clé API à Rescale, il a lancé l'utilitaire de ligne de commande depuis son ordinateur de travail à l'aide de la simple commande :
java -jar rescale.jar sync -p abcdef1234567890 -d 600
La commande utilise l'API de Rescale pour vérifier toutes les 10 minutes s'il y a des tâches nouvellement terminées ; et s'il y en a, Rescale téléchargera automatiquement les fichiers sur un lecteur local. L'utilitaire de ligne de commande télécharge et déchiffre efficacement (multithread) les données de sortie. Ainsi, pendant que notre ingénieur dormait, le réseau de son entreprise travaillait dur pour télécharger tous les travaux terminés sur son ordinateur de travail afin qu'il puisse passer la journée suivante à être plus productif.
Bientôt disponible : post-traitement basé sur une interface graphique
Bien que la deuxième ingénieure puisse déjà utiliser le transfert X11 via SSH pour effectuer un post-traitement de base basé sur une interface graphique dans le cloud, elle pense que ce serait très utile si les performances étaient meilleures. Heureusement, elle n'aura pas à attendre longtemps puisque Rescale travaille activement sur une solution de bureau à distance pour effectuer un post-traitement basé sur une interface graphique.
Être intelligent avec les données
L’essentiel, lorsqu’il s’agit de données dans le cloud, est d’utiliser les outils à votre disposition aussi efficacement que possible. LS-DYNA et Converger les CFD ne sont pas les seuls logiciels à fournir des outils de post-traitement en ligne de commande faciles à utiliser. De nombreux autres outils disponibles sur Rescale offrent cette même fonctionnalité.
La question « Que fait-on dans le cloud et qu’est-ce qui se fait localement ? La réponse n'est possible qu'en décidant comment Rescale s'intègre le mieux à vos processus d'ingénierie existants. Parfois, il est pratique de disposer de toutes les données sur site tout en effectuant également tout le post-traitement sur site. Mais souvent, une plus grande partie de ce travail d’ingénierie peut être déplacée vers le cloud, comme le démontrent les deux cas d’ingénierie.
Pour cette raison, notre objectif chez Rescale est de fournir tous les outils nécessaires pour rendre le problème du traitement des données aussi minime que possible.
En savoir plus sur les dernières solutions de gestion de données de Rescale
Planifiez une démo avec l'un de nos experts