
Tutoriels ANSYS Fluent Batch
Ce tutoriel vous présentera la soumission de tâches ANSYS par lots à la plateforme Rescale. Nous allons créer un fichier d'entrée à partir du logiciel ANSYS respectif, démarrer une tâche de redimensionnement, soumettre et transférer les résultats à ANSYS.
Les activités de prétraitement (par exemple géométrie, maillage/modèle) sont déjà terminées et toutes solveurUn solveur est un algorithme numérique ou un outil logiciel qui... Autres et les paramètres de configuration sont également déjà déterminés. Contrairement à la soumission de travaux via RSM, vous n'avez pas besoin de lancer Rescale Desktops. Vous pouvez utiliser votre propre logiciel et licence ANSYS ou nous contacter et acheter des unités de licence Elastic (ELU).
Dans cette section, nous allons résoudre un calcul ANSYS Fluent par lots. Pour obtenir les fichiers nécessaires à ce tutoriel, veuillez… ouvrir un ticket de support avec prise en charge du redimensionnement.
Création de fichiers de cas et de journaux
L'exemple du didacticiel est une jonction en T de deux fluides à des températures différentes utilisant ANSYS Fluent version 18. Le dossier tjunction_plot.cas.gz est déjà à votre disposition. Les étapes à suivre pour créer un dossier sont :
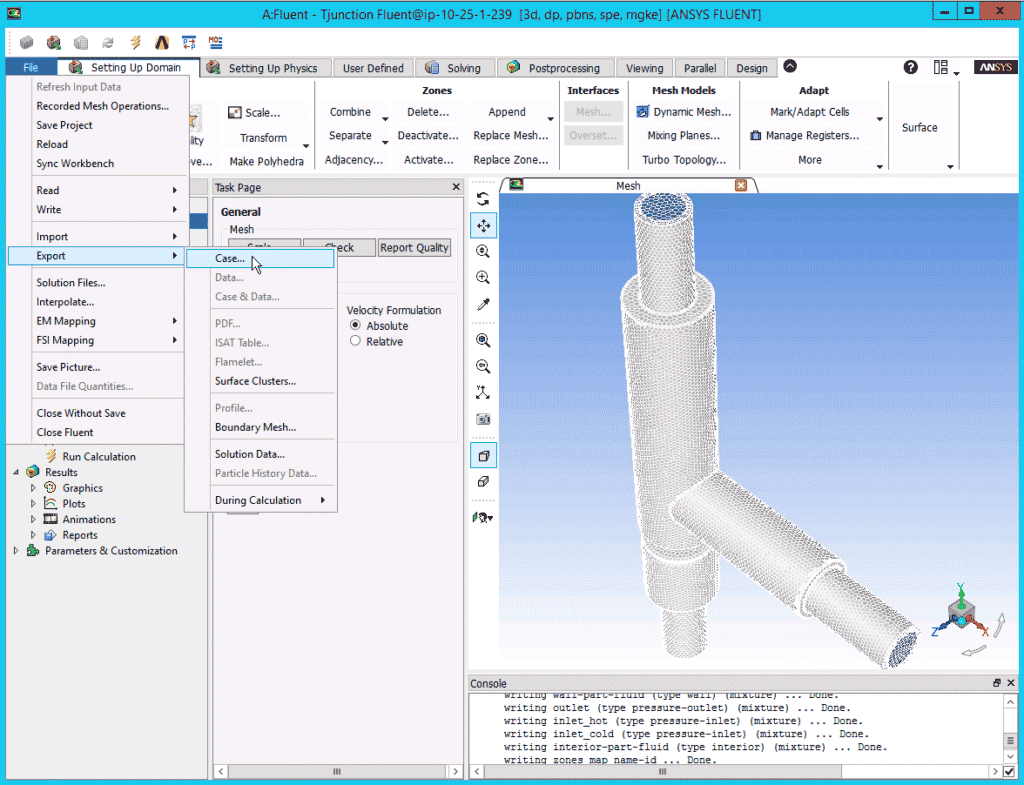
- Sur Fluent, accédez au Fichier , puis sélectionnez Exporter > Cas…, et cela ouvrira une fenêtre de navigateur
- Nommez le fichier avec un .cas or .cas.gz extension et sélectionnez l’emplacement vers lequel ce fichier sera exporté.
Ce fichier contient tous les paramètres de prétraitement ainsi que la configuration du solveur et de la physique qui ont été configurés dans l'interface graphique, conformément à votre flux de travail standard.
Vous aurez également besoin d'un fichier journal contenant toutes les commandes nécessaires que vous souhaitez exécuter à l'aide de Fluent lors d'une exécution par lots. Le dossier journal run_plot.jou est déjà à votre disposition. Les étapes à suivre pour créer un fichier journal sont :
- Dans une fenêtre de l'Explorateur Windows, cliquez avec le bouton droit de la souris > Nouveau > Document texte (ou similaire pour un autre système d'exploitation).
- Donnez un nom au fichier, avec extension .jou. Acceptez la modification de l'extension de fichier.
- Double-cliquez sur le fichier pour l'ouvrir et entrez les commandes du journal, puis enregistrez le fichier.
Le fichier journal ressemblera à ceci :
/file/set-batch-options no yes yes no
/file/read-case tjunction_plot.cas
/solve/initialize/initialize/
/solve/iterate 500
/file/write-case-data tjunction_plot%i.cas.gz
/exit yes
Le fichier journal présenté ci-dessus lit le fichier de cas, définit les options de lot, s'initialise, exécute le calcul pendant 500 itérations et écrit enfin un cas et un fichier de données lorsque la solution a convergé vers une limite prescrite.
Ce fichier est écrit en utilisant le Interface utilisateur de texte fluide ANSYS (TUI). Pour plus d'informations sur l'utilisation de commandes d'interface texte spécifiques, veuillez vous référer à la documentation en ligne d'ANSYS. ici.
Redimensionner la configuration du travail
Après avoir obtenu les fichiers ANSYS Fluent nécessaires, nous allons maintenant soumettre un Fonction Plug & Play travail sur Rescale. Pour plus d'informations sur le lancement d'un job de base, veuillez vous référer au tutoriel ici.
Configuration : fichier(s) d'entrée
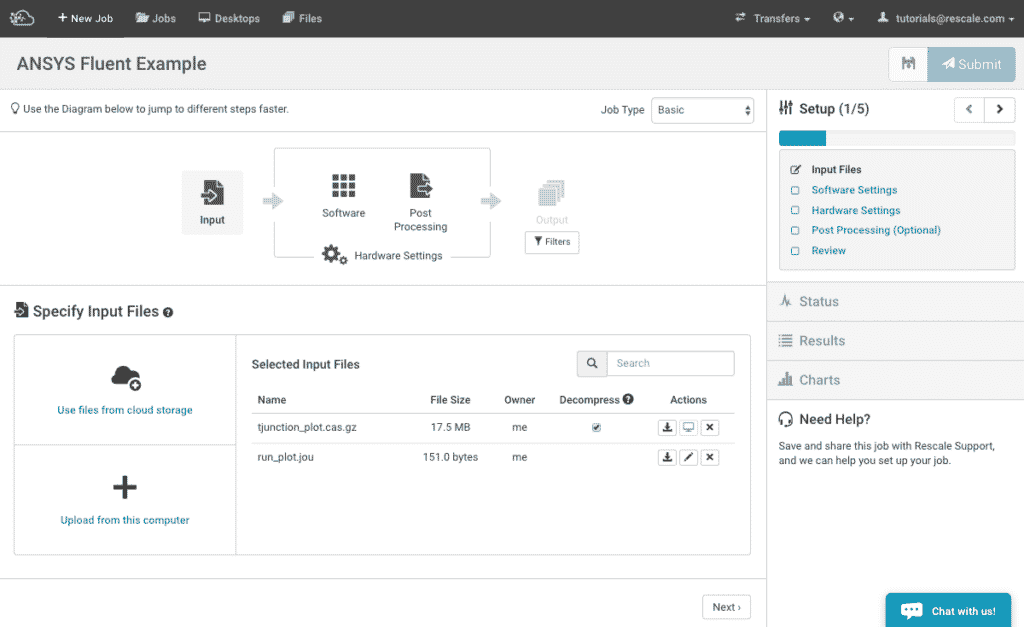
- Allez sur la plateforme Rescale, cliquez sur + Nouvel emploi en haut à gauche. Nommez votre travail et assurez-vous que Type d'emploi est fixé à Fonction Plug & Play.
- Téléchargez ensuite le journal et les fichiers de cas en tant que fichiers d'entrée.
Configuration : Paramètres du logiciel
Cliquez à nouveau Suivant pour passer à Paramètres du logiciel section de la configuration.
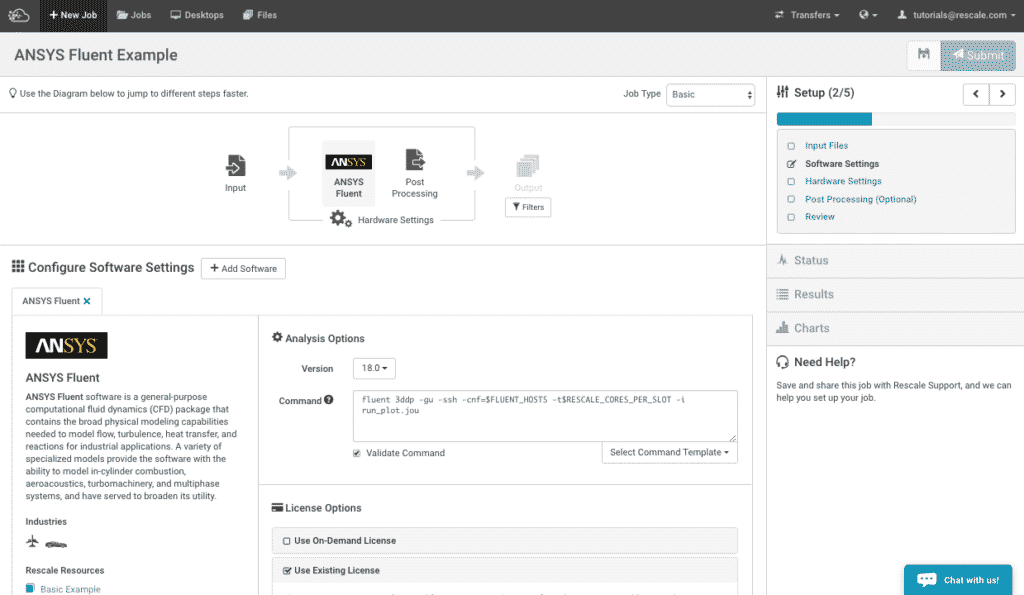
- Vous pouvez faire défiler vers le bas ou utiliser la barre de recherche pour sélectionner ANSYS Fluent. Le Options d'analyse affichera et sélectionnera la version 18.0.
- Dans la fenêtre de commande, vous devrez spécifier le nom du fichier journal sous le crochet angulaire . Nous aimerions également voir la solution résiduelle. Pour ce faire, on commande de conserver les fenêtres graphiques en utilisant le -gu option.
- Suivant sous LicenceLa licence est un outil juridique accordant aux utilisateurs le droit d'utiliser, ... Autres Options, sélectionnez Utiliser la licence existante et entrez votre ANSYS serveurun serveur est un programme informatique qui fournit des services à d'autres... Autres numéros de port de connexion sous License et Licence ANSYS InterconnectLe câblage et les commutateurs utilisés par les nœuds de calcul pour communiquer... Autres respectivement.
Pour ce didacticiel, la page des paramètres du logiciel ressemblera à celle illustrée ci-dessous.
Configuration : Paramètres matériels
L'étape suivante consiste à sélectionner le matériel souhaité pour le travail. Clique sur le Paramètres du matériel icône.
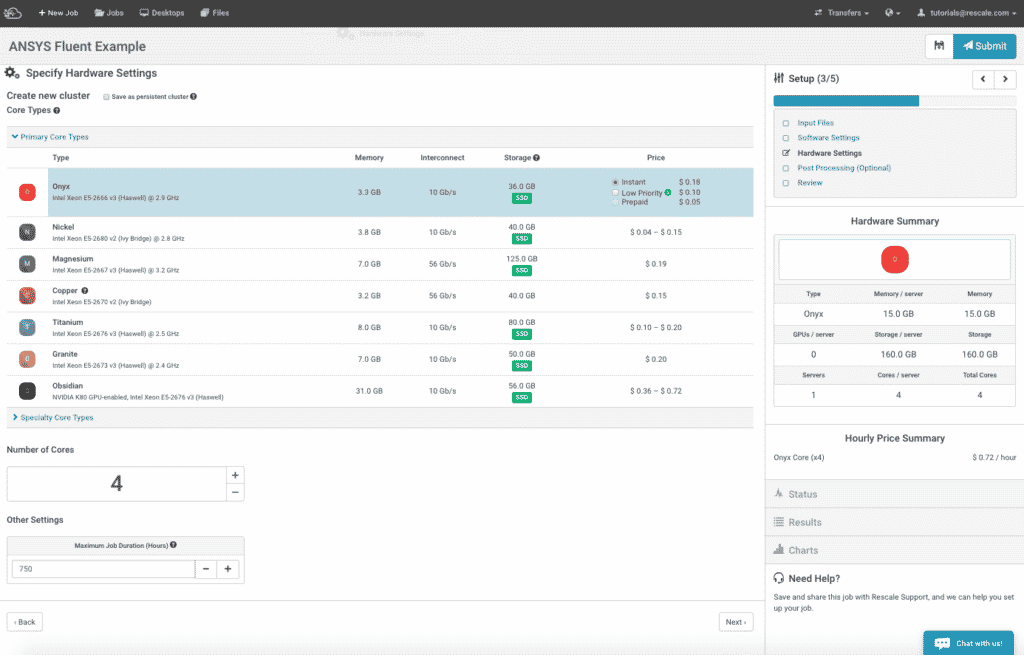
- Sélectionnez votre désiré coreune unité de traitement individuelle au sein d'un processeur multicœur o... Autres type et le nombre de cœurs que vous souhaitez utiliser pour ce travail. Pour ce didacticiel, sélectionnez Emeraude et 4 cœurs.
Votre Paramètres du matériel l'écran devrait ressembler à ceci :
Configuration : Révision
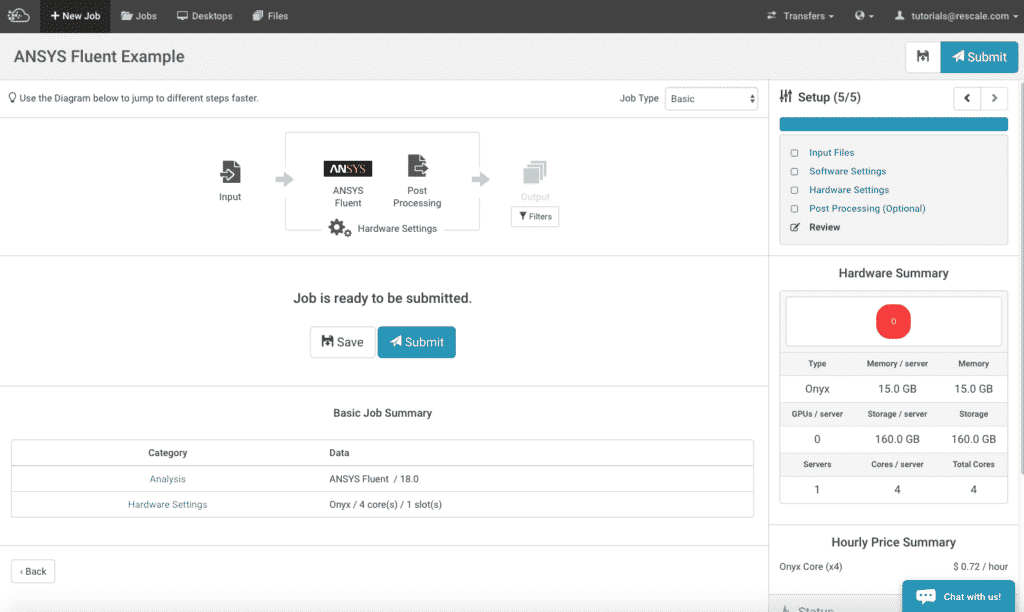
Il n'y a aucun paramètre de post-traitement dans ce didacticiel. Clique sur le Évaluation icône. Vérifiez que la configuration est correcte en examinant le Résumé du travail de base tableau. Ça devrait ressembler à ça:
Soumission et surveillance des travaux
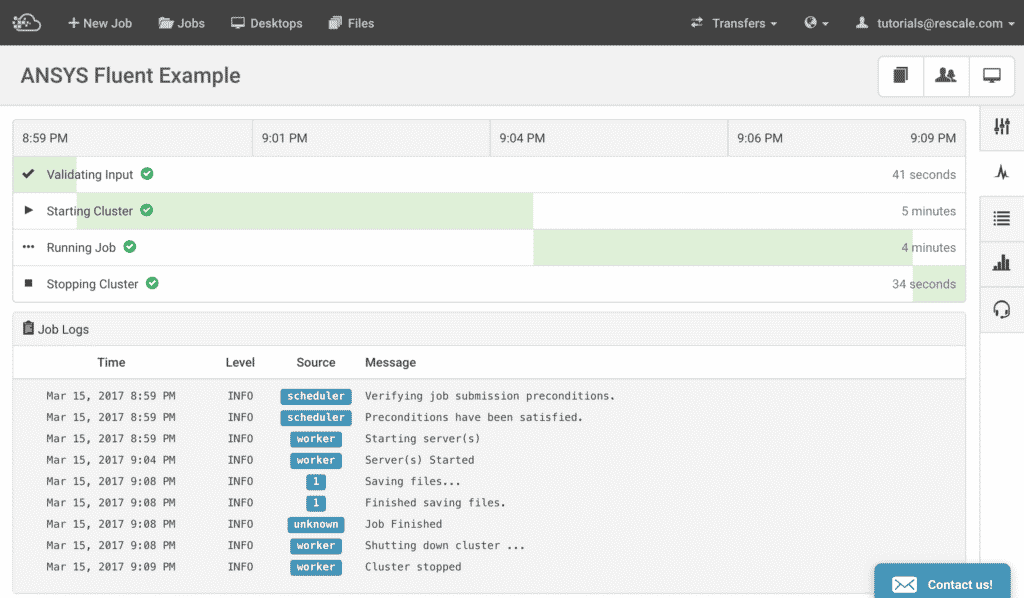
Une fois que vous avez examiné votre configuration, vous êtes prêt à soumettre votre travail. Cliquez sur Soumettre et vous passerez du installation page à la Statut page de la plateforme Rescale. Ici, vous pourrez suivre la progression du travail dans un format semblable à un diagramme de Gantt, voir un journal horodaté et suivre en direct l'état et le résultat de votre travail à l'aide du Queue vivante fenêtre. Un guide sur « l'état de surveillance » sur Rescale est trouvé ici.
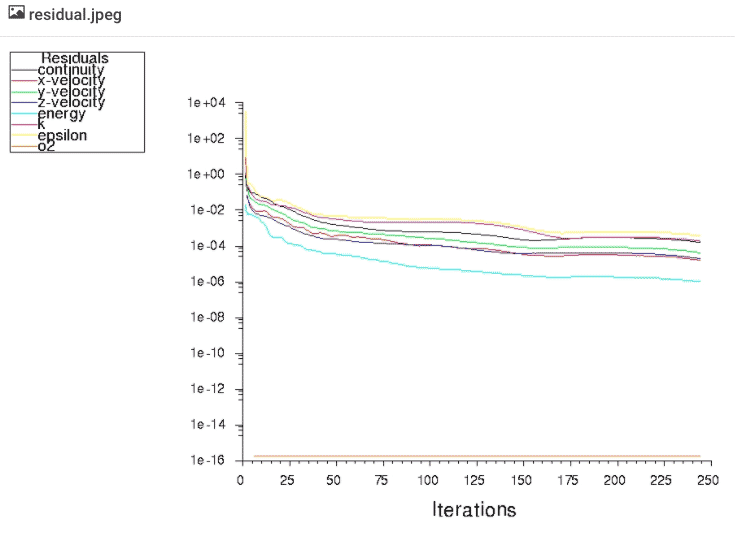
Dans cet exemple, nous avons configuré le simulationLa simulation, c'est expérimenter, tester des scénarios et créer... Autres pour générer un tracé résiduel à chaque itération, qui apparaîtra sous le Suivi en directégalement appelé surveillance des journaux en temps réel ou flux de journaux en direct... Autres fenêtre comme residual.jpeg déposer. Vous pouvez ouvrir ce graphique à tout moment pour suivre l'avancement de la convergence de la solution.
Affichage des résultats
Une fois le travail terminé, vous pouvez soit visualiser les résultats sur votre site local poste de travailUn poste de travail est un système informatique puissant conçu pour les pro... Autres ou sur un bureau Rescale. Les deux méthodes sont présentées ci-dessous :
Sur votre poste de travail local
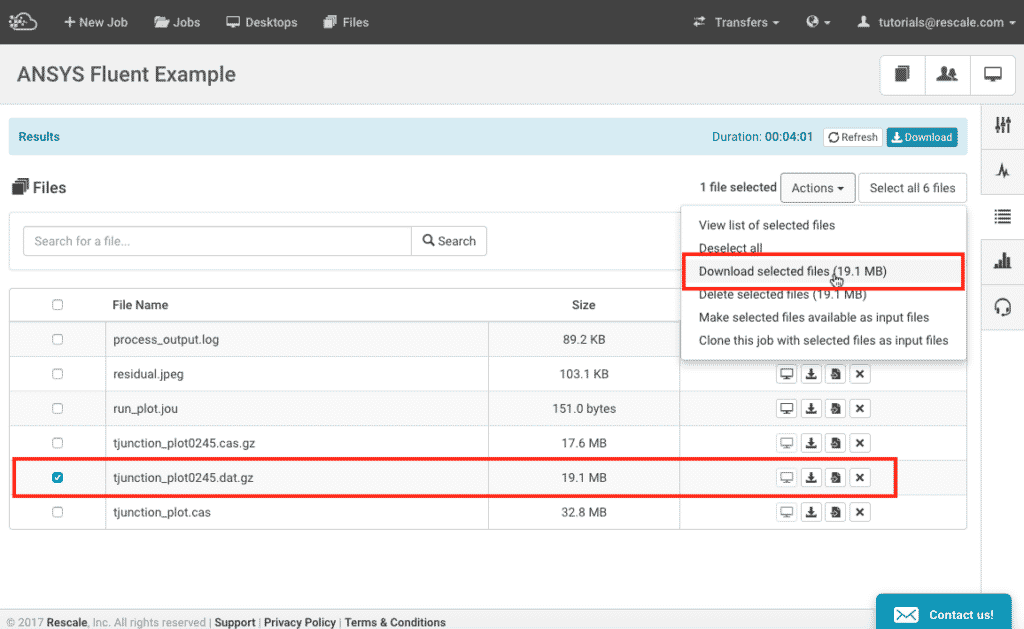
Une fois le travail terminé, vous pouvez sélectionner le(s) fichier(s) que vous souhaitez télécharger.
Remarque : Si vous disposez de fichiers de sortie volumineux, il est recommandé aux utilisateurs Windows d'utiliser Gestionnaire de transfert de redimensionnement (RTM) pour télécharger des fichiers plus rapidement sur votre poste de travail sur site. Plus d’informations sur RTM peuvent être trouvées ici. Les utilisateurs Linux ou Mac peuvent utiliser Redimensionner la CLI pour télécharger des fichiers de sortie plus volumineux.
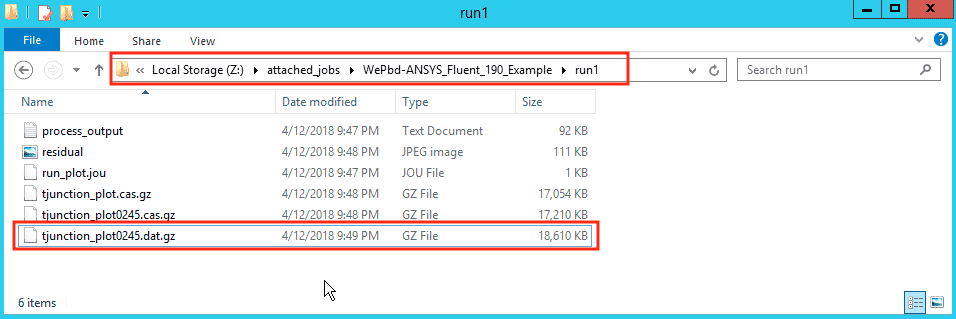
- Accédez à la page de résultats du travail terminé, recherchez et sélectionnez le
tjunction_plot0245.dat.gz - Allez dans Action et cliquez sur Télécharger les fichiers sélectionnés, laissez-lui quelques secondes pour le télécharger sur votre ordinateur
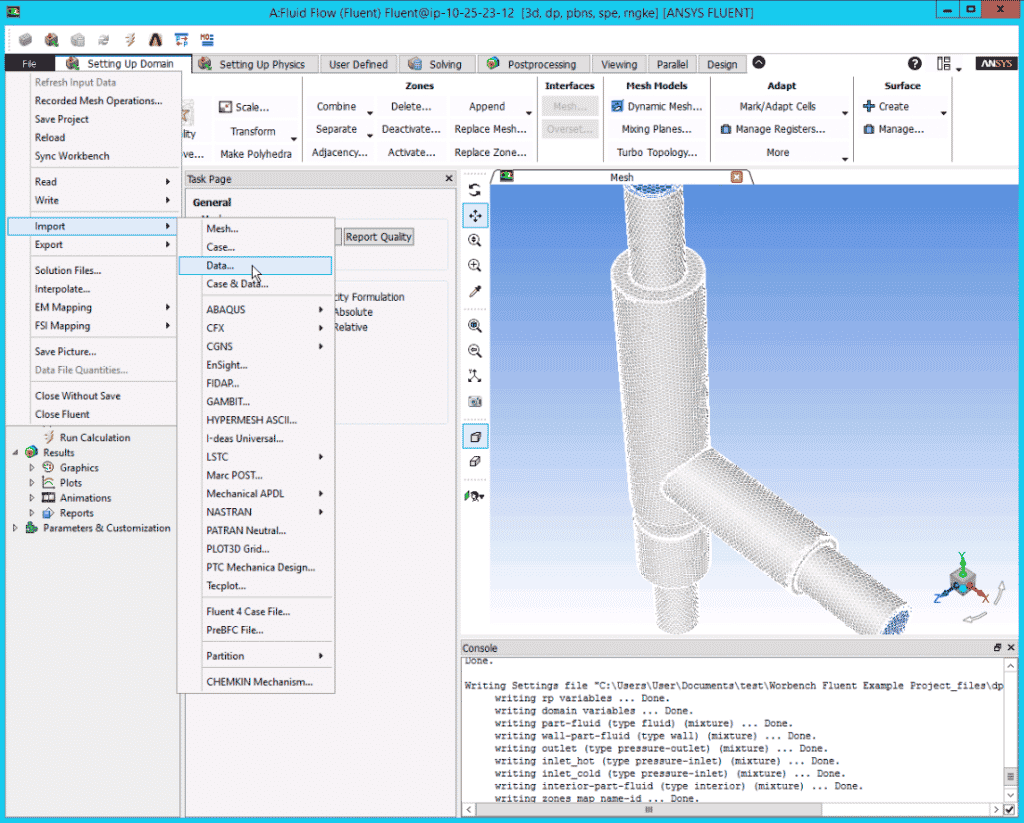
- Lancement Couramment . Aller à Fichier onglet, puis sélectionnez Importer > Données… , pour charger le fichier de données de la solution
Sur un bureau redimensionné
Une fois le travail terminé, suivez ces étapes pour afficher les résultats sur un bureau Rescale :
Mettre en place un Session de bureau:
- Sous 1. Choisissez Configuration dans la liste déroulante, sélectionnez le matériel pour votre Session de bureau
- Sous 2.Ajouter un logiciel liste déroulante, sélectionnez Bureau des fluides ANSYS
- Sous 3.Emplois Dans la liste déroulante, recherchez l'emploi que vous souhaitez ajouter en tapant son nom et/ou en parcourant la liste. Cliquez sur Ajouter pour ajouter un travail au bureau
- Une fois la session Desktop démarrée, lancez Couramment
- Sur Fluent, accédez au Fichier onglet, puis sélectionnez Importer > Données… . Accédez aux répertoires mappés. il est courant de mapper sur le lecteur Z:, mais la tâche attachée peut également se trouver dans les lecteurs X: ou Y: en fonction de votre configuration. Cliquer sur
tjunction_plot0245.dat.gzfichier pour charger le fichier de données de solution et cliquez sur Ouvrez
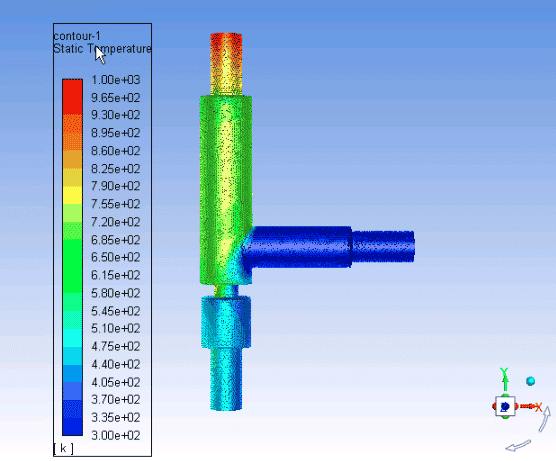
À ce stade, vous pouvez procéder à vos activités de post-traitement comme vous le feriez normalement après avoir résolu une simulation Ansys Fluent de manière interactive.
ANSYS Fluent a également la capacité de permettre aux utilisateurs de modifier ou d'étendre le comportement de la configuration physique et du solveur. Les fonctions définies par l'utilisateur (UDF) peuvent être utilisées pour effectuer des actions telles que l'imposition de conditions aux limites, de processus physiques et chimiques, de transferts de chaleur et de changements de phase.
Dans cette section, nous présentons les instructions d'utilisation des fonctions définies par l'utilisateur (UDF) Fluent en mode batch sur la plateforme Rescale.
Ce guide supposera que vous avez déjà développé une UDF prête à être compilée dans un travail Fluent. Pour obtenir de l'aide sur la création ou le débogage des UDF, veuillez contacter directement le support ANSYS. Voici une guide par ANSYS sur l'utilisation des UDF dans Fluent.
Compilation des FDU par lots
Pour utiliser un UDF lors d'une exécution par lots, le code source de l'UDF doit d'abord être compilé et accessible par Fluent. Nous démontrerons un flux de travail qui compile l'UDF au moment de l'exécution avant le processus principal de résolution ou d'itération de la solution. Nous y parviendrons en ajoutant des commandes à un exemple de fichier journal existant. En fonction de votre flux de travail et de la taille des bibliothèques de compilation, il est possible que ces bibliothèques UDF soient précompilées et incluses en tant que fichiers d'entrée dans votre travail par lots. Mais en général, les UDF sont des codes simples, donc la compilation à l'exécution est une opération courte et évite toute incohérence de plate-forme.
Exemple de fichier journal
Ce qui suit est un exemple de fichier journal qui compile un fichier créé par l'utilisateur. custom_UDF.c dans le répertoire courant (avec le fichier journal) et charge les bibliothèques UDF résultantes. L'UDF est compilé avec le nom de bibliothèque par défaut libudf et crée une structure de répertoires nommée en conséquence avec les bibliothèques partagées.
Ici, les commandes de compilation et de chargement (affichées dans gras) sont séquentiels et ont lieu avant l'initialisation de la solution. Mais vous pouvez effectuer ces opérations partout où elles s’intègrent dans votre flux de travail.
/file/set-batch-options non oui oui non /file/read-case example.cas
/define/user-defined/compiled-functions compiler libudf oui custom_UDF.c "" /define/user-defined/compiled-functions charger libudf
/solve/initialize/initialize /solve/iterate 1000 /parallel/timer/usage /file/write-case-data example-%i.cas /exit oui
Il y a deux éléments de syntaxe spécifiques à noter ici. La première est qu'après le nom du fichier de code source UDF, il y a deux guillemets doubles. "" présent. La seconde est la ligne vide après le compile commande. Cela garantit que la fonction de compilation ne tente pas de traiter les lignes suivantes comme des noms de fichiers supplémentaires à inclure dans la compilation. La ligne vide est nécessaire après la commande de compilation mais n'a pas besoin de précéder ou de suivre la commande de chargement.
Effectuer un appel UDF explicite
Parfois, vous devrez appeler une fonction UDF avant ou après un processus de solution pour définir une condition aux limites ou effectuer une sorte d'étape de post-traitement. Vous pouvez appeler cette fonction UDF explicitement dans votre fichier journal avec un execute-on-demand appeler le cas échéant :
/define/user-defined/execute-on-demand "FunctionName::libudf"
Exécution sur plusieurs nœuds
Une autre chose à noter est qu'en raison de la nature des appels de fonction UDF, tous les nœuds doivent accéder aux bibliothèques UDF compilées. Par défaut, les tâches ANSYS Fluent sont configurées pour s'exécuter dans le ~/work répertoire local à la tête nœudEn informatique traditionnelle, un nœud est un objet sur un réseau. ... Autres. En fonction du comportement de la fonction, les processus du nœud de travail peuvent avoir besoin d'accéder à un fichier ou une bibliothèque commune. Dans ce cas, le travail doit être exécuté depuis le répertoire monté NFS, ~/work/shared. Il suffit donc d'ajouter les commandes de déplacement et de changement de répertoire sur la page « Paramètres du logiciel » avant de lancer Fluent (pas dans le fichier journal) :
mv * cd partagé partagé couramment 3ddp -gu -ssh -cnf=$FLUENT_HOSTS -t$RESCALE_CORES_PER_SLOT -i exemple.jou
Encore une fois, si vous utilisez plusieurs cœurs sur un unique nœud, cette étape est inutile puisque le système de fichiers local est accessible par tous les cœurs de ce nœud.